Author: @kkhrylchenko
Рекламу не размещаю.
Post #440
2.19K




KDD’26, день третий.
1. Keynote от Джеффа Дина. Это один из гигантов области ИИ, стоящий у истоков большого числа различных исследований и разработок Гугла, которыми мы все с вами пользуемся. Он буквально придумал MapReduce, TPU, tensorflow, был соавтором word2vec, mixture of experts, knowledge дистилляции; делал первый нейросетевой машинный перевод. В последние годы лидил разработку Gemini. У него 426490 цитирований на google scholar.
Пока текущий кейноут не залили на ютуб, можете посмотреть как в 2014 году он выступал на ACM RecSys с кейноутом Large Scale Machine Learning for Predictive Tasks.
Сначала сегодня был экскурс в его основные околонейросетевые работы, часть которых я упомянул выше. Забавные факты:
* в своей дипломной работе из 90-х он уже занимался нейросетями — скейлил обучение до 32-х процессоров. Потом продолжил тем же самым заниматься в Гугле :)
* статью про knowledge distillation (которая с Хинтоном в соавторах) — реджектнули на NeurIPS со словами “это никому никогда не понадобится”))
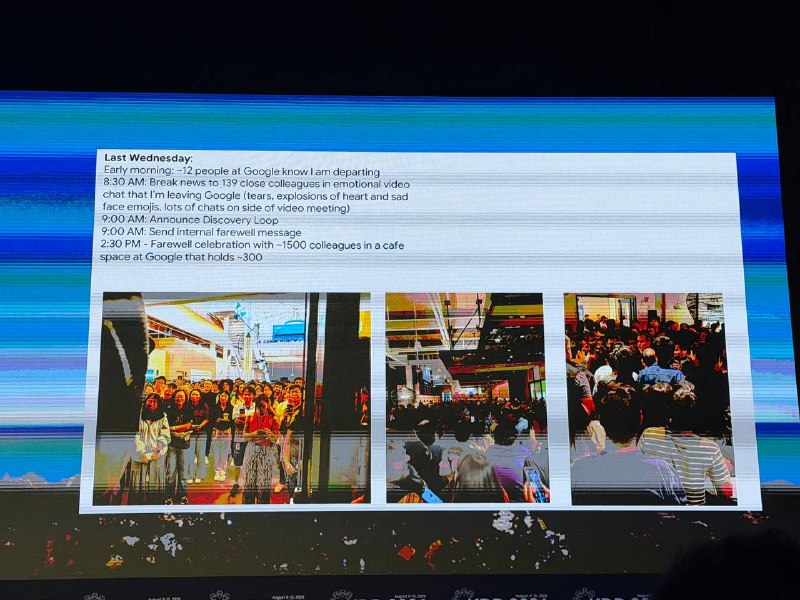
Затем рассказывал про свой уход из Гугла — как объявлял на всю компанию что уходит; что очень много людей пришли на прощальную вечеринку, все не поместились в Гугл кафешке; что было очень много прощальных писем, он пытался на них все ответить, но не получалось, но он пытался, но не получалось... Сходил на йогу, поиграл в футбол, уволился.
И, наконец, рассказал про свою новую компанию Discovery Loop:
* основная идея — автоматизация типичного экспериментального пайплайна “propose experiment -> implement and run -> evaluate”
* К вопросу подходят масштабно — предполагается, что запускаться будет очень большое количество экспериментов, их результаты (и отрицательные, и положительные) будут использоваться агентами на следующих итерациях экспериментов. Ожидается, что при должном масштабировании это приведет к большому количеству научных прорывов
* Сначала фокусируются на digital областях, в которых эксперименты не требуют доступа к физическому миру
* Приводил как пример масштабного запуска экспериментов разработку Gemini, в которой одновременно принимали участие тысячи людей и мерджили результаты экспериментов в единую модель
Еще было немного про кодинг:
* сейчас происходит переход на следующий, еще больше верхнеуровневый этап программирования: ассемблер, C++, Python, а теперь — делегирование задач агентам
* по мнению Джеффа, агенты нас не заменят, а сделают продуктивней (ага, ага)
2. Вообще, сегодня я хорошенько прочувствовал, что агенты становятся основным трендом в рекомендательных технологиях. Семантические айдишники и генеративные рекомендации, конечно, это все еще очень горячая тема, про которую большие компании трубят из каждого угла; но уже появилось четкое ощущение, что самые передовые ребята занимаются агентами, а большие компании просто как всегда не поспевают за прогрессом.
Чуть более конкретно:
* пообщался с Derek Chеng (руководителем команды в Google DeepMind, в которой придумали DCN-v2). Раньше его команда помогала различным сервисам Гугла (в первую очередь рекламе) делать рекомендательные технологии — придумывали архитектуры нейросетей, работали над эффективностью, etc. А теперь они делают агента, который их заменит)) Буквально занимаются посттрейном LLM
* Артёму @nxt_item стажер из команды onerec-think/onereason Куайшоу сказал, что сейчас у них половина команды занимается проектом Агент X, суть которого буквально такая же — создать ИИ ресерчера, который их заменит
В общем, тренды страшные. Мы все призадумались; на постерной сессии полчаса стояли в кружке и пытались осмыслить надвигающийся экзистенциальный кризис. Если еще посты Игоря @seeallochnaya про ситуацию с OpenAI агентами почитать, то совсем страшно.
3. Также сегодня была вторая постерная сессия (вчера industry track, сегодня research), ее я провел в основном возле статьи A Unified Language Model for Large Scale Search, Recommendation, and Reasoning от Spotify, про которую в этом году уже даже на лекциях рассказывал!)
На этом всё.Следующий пост за меня будет писать агент
1. Keynote от Джеффа Дина. Это один из гигантов области ИИ, стоящий у истоков большого числа различных исследований и разработок Гугла, которыми мы все с вами пользуемся. Он буквально придумал MapReduce, TPU, tensorflow, был соавтором word2vec, mixture of experts, knowledge дистилляции; делал первый нейросетевой машинный перевод. В последние годы лидил разработку Gemini. У него 426490 цитирований на google scholar.
Пока текущий кейноут не залили на ютуб, можете посмотреть как в 2014 году он выступал на ACM RecSys с кейноутом Large Scale Machine Learning for Predictive Tasks.
Сначала сегодня был экскурс в его основные околонейросетевые работы, часть которых я упомянул выше. Забавные факты:
* в своей дипломной работе из 90-х он уже занимался нейросетями — скейлил обучение до 32-х процессоров. Потом продолжил тем же самым заниматься в Гугле :)
* статью про knowledge distillation (которая с Хинтоном в соавторах) — реджектнули на NeurIPS со словами “это никому никогда не понадобится”))
Затем рассказывал про свой уход из Гугла — как объявлял на всю компанию что уходит; что очень много людей пришли на прощальную вечеринку, все не поместились в Гугл кафешке; что было очень много прощальных писем, он пытался на них все ответить, но не получалось, но он пытался, но не получалось... Сходил на йогу, поиграл в футбол, уволился.
И, наконец, рассказал про свою новую компанию Discovery Loop:
* основная идея — автоматизация типичного экспериментального пайплайна “propose experiment -> implement and run -> evaluate”
* К вопросу подходят масштабно — предполагается, что запускаться будет очень большое количество экспериментов, их результаты (и отрицательные, и положительные) будут использоваться агентами на следующих итерациях экспериментов. Ожидается, что при должном масштабировании это приведет к большому количеству научных прорывов
* Сначала фокусируются на digital областях, в которых эксперименты не требуют доступа к физическому миру
* Приводил как пример масштабного запуска экспериментов разработку Gemini, в которой одновременно принимали участие тысячи людей и мерджили результаты экспериментов в единую модель
Еще было немного про кодинг:
* сейчас происходит переход на следующий, еще больше верхнеуровневый этап программирования: ассемблер, C++, Python, а теперь — делегирование задач агентам
* по мнению Джеффа, агенты нас не заменят, а сделают продуктивней (ага, ага)
2. Вообще, сегодня я хорошенько прочувствовал, что агенты становятся основным трендом в рекомендательных технологиях. Семантические айдишники и генеративные рекомендации, конечно, это все еще очень горячая тема, про которую большие компании трубят из каждого угла; но уже появилось четкое ощущение, что самые передовые ребята занимаются агентами, а большие компании просто как всегда не поспевают за прогрессом.
Чуть более конкретно:
* пообщался с Derek Chеng (руководителем команды в Google DeepMind, в которой придумали DCN-v2). Раньше его команда помогала различным сервисам Гугла (в первую очередь рекламе) делать рекомендательные технологии — придумывали архитектуры нейросетей, работали над эффективностью, etc. А теперь они делают агента, который их заменит)) Буквально занимаются посттрейном LLM
* Артёму @nxt_item стажер из команды onerec-think/onereason Куайшоу сказал, что сейчас у них половина команды занимается проектом Агент X, суть которого буквально такая же — создать ИИ ресерчера, который их заменит
В общем, тренды страшные. Мы все призадумались; на постерной сессии полчаса стояли в кружке и пытались осмыслить надвигающийся экзистенциальный кризис. Если еще посты Игоря @seeallochnaya про ситуацию с OpenAI агентами почитать, то совсем страшно.
3. Также сегодня была вторая постерная сессия (вчера industry track, сегодня research), ее я провел в основном возле статьи A Unified Language Model for Large Scale Search, Recommendation, and Reasoning от Spotify, про которую в этом году уже даже на лекциях рассказывал!)
На этом всё.
- 👍 22
- ❤ 5
- 🥴 4
- 😱 2
- 🤩 1