TGViewer
Channel Public Channel
Сиолошная

Сиолошная

@seeallochnaya

Канал SeeAll'а с новостями (и мыслями о них) из мира NLP, VR и космоса.

Более подробно смотри в первом сообщении в канале (оно закреплено). А еще у нас есть чат! Заходи: https://t.me/+i_XzLucdtRJlYWUy
Subscribers
79.7K
Photos
2.1K
Videos
352
Links
2.1K
Recent Posts 18 shown
Post #3945 16.6K
Прошло уже почти 3 недели с релиза GPT-6 Astra, и можно подводить первые промежуточные итоги. Модель действительно вышла очень клёвой и способной, и, как мне кажется, лучше Fable 5.1: на многих бенчмарках они или идут вровень, или Astra обходит; к тому же читать текст Astra гораздо приятнее, чем слоп от Клода, и когнитивная нагрузка не такая большая, чтобы продраться через мешанину абстрактных терминов.

Astra особенно отличается в Computer Use и задачах с изображениями/видео. Не знаю что там сделали OpenAI и связано ли это как-то с Looped Transformers, но люди смогли заставить Astra пройти несколько игр: от простого «добудь алмаз в Minecraft» до... легендарной ролевой игры Fallout 3, пространственной головоломки Portal и Factorio (основная игра + дополнение). Насколько я понимаю, во всех или почти во всех случаях это не простой пайплайн «картинка с экрана -> действия», тут и там то MCP подключат, то ещё что, но это всё равно впечатляет. Легко сказать «так модели же учили на всех видео с интернета, конечно они знают как играть» — но модели 3-4 месяца назад учили примерно столько же и на том же, но они не могли проходить игры от начала и до конца.

Не одними играми славится Astra — на многих бенчмарках, в том числе тех, которые вышли после релиза (или ещё круче: авторы ещё не выпустили, но уже померили Astra, как было у Vals.AI), модель показывает существенную разницу. Из запомнившегося — WeirdML v3 на картинке в посте, свежий бенчмарк на ML-задачи, где агенту дают данные и общее описание что делать, и его цель разобраться, что в данных, обучить модели и/или написать эвристики и прийти к решению. Автор пишет, что был очень удивлён оценке Astra, и он не ожидал, что ещё фактически до релиза бенчмарка лучшая оценка будет больше 50%.

В общем, весной после анонса Mythos/Fable у меня был скепсис, что OpenAI получится быстро догнать Anthropic. По какой-то причине компания долгое время не решалась на масштабирование моделей. Возможно, не хотели упираться в нехватку вычислительных мощностей, с которой компания встретилась сейчас — не знаю. Рад, что опасения не подтвердились 🤷‍♂️

Теперь будем смотреть как догоняют Google, META и xAI — и китайцы с опенсурсом🇨🇳... пока в OpenAI по слухам уже идёт предтренировка ещё большей модели с кодовым названием «Bel».
  • 👍 206
  • 🔥 80
  • 💩 36
  • 🤡 16
  • 🎉 5
  • ❤‍🔥 3
  • 👨‍💻 3
  • 🤔 1
Post #3944 23.6K
Похоже у OpenAI и вправду очень сильно вырос спрос, и подписки за $200 закрыли поделом — вычислительных мощностей впритык, уже неделю не было сбросов лимитов 😭
  • 🌚 194
  • 😭 160
  • 🤣 46
  • 👍 17
  • 🤡 13
  • 💩 5
  • 😈 3
  • 👨‍💻 3
  • 👎 1
Post #3943 60.7K
Вы наверняка видели эту картинку с XKCD. Оказалось, она была пророческой — именно через уязвимость в указанной библиотеке ImageMagick (поддерживаемой за "спасибо" каким-то рандомом из Небраски 😀) нашлись уязвимости, позволившие 3 белым хакерам и паре LLM по подписке взломать OpenAI и несколько других компаний, включая Slack, Zoom, Meta.

Сначала им удалось взломать форум обсуждений OpenAI, построенный на платформе Discourse (старый, часто используемый и никакой связи с OpenAI не имеет). Ну как "им" — в июле хакеры попросили Opus 4.8 проанализировать уязвимости, и тот справился, найдя одну в библиотеке для работы с изображениями. Потом Opus 5 переписал/улучшил хак, и по итогу загрузка картинки на форум приводила к выполнению кода.

После этого была обнаружена ещё какая-то проблема/уязвимость в SSO OpenAI (система, использующаяся для логина), и используя её хакеры могли бы в теории получить доступ к внутренним репозиториям OpenAI, чего они не сделали, ограничившись созданием одного PR как доказательство работоспособности.

OpenAI оперативно отреагировали, и через 2 дня уязвимости были исправлены.

Вот тут сборник рассказов про взломы других компаний через уязвимость в той же библиотеке изображений. На все взломы ушло суммарно... $3000 в токенах 👨‍🦳👨‍🦳
  • 🌚 213
  • 🔥 93
  • 🤯 20
  • 👨‍💻 20
  • 👍 8
  • 🤡 6
  • 🤣 6
  • 😭 2
Post #3942 22.2K

Forwarded from Самые умные мысли Павла Комаровского (и немножко щитпостинг)

OpenAI по слухам там почти решили еще одну задачу тысячелетия. Думаю, огромное число математиков сейчас лихорадочно нажимают в ЧатГПТ галку "разрешить использовать логи для улучшения моделей" и кидают в чат все пришедшие в голову гипотезы о том, как подходить к ее решению…
  • 🤣 423
  • 🤡 85
  • 🔥 35
  • 🤯 9
  • ❤‍🔥 7
  • 👍 4
  • 😈 4
  • 💩 2
  • 👨‍💻 1
Post #3939 22.9K

Forwarded from hypewave (Сова Сова)

Первый взгляд на физическое издание музыкального альбома по GTA VI

Подтверждены следующие треки:
• Yung Lean - That's It (feat. Future & Metro Boomin)

• Travis Scott - RHYNO (prod. by Guy-Manuel de Homem-Christo)

• CA7RIEL & Paco Amoroso, PinkPantheress, Fred again.., & Etienne de Crécy - Sexy Magic

• Morgan Wallen - Last Thing You Need

• Rauw Alejandro - Macacoa 2000

• Keith Richards - Bright Lights, Big City
  • 🤡 133
  • 🔥 42
  • 💩 20
  • 👎 7
  • ❤‍🔥 4
  • 🤯 3
  • 👍 2
  • 🤣 1
Post #3937 24.1K
Вчера послушал интересное интервью Matt Sheehan на The Ezra Klein Show. Matt —исследователь китайской политики в области ИИ, старший научный сотрудник Фонда Карнеги (один из ведущих аналитических центров) за международный мир. Тема интервью — аргумент «А как же Китай?» в обсуждении ИИ-регуляций, который часто звучит в последние недели.

Мне этот аргумент казался глупым ещё пару лет назад — если Компартия верит, что ИИ сможет отобрать у них контроль или тем более привести к существенному урону, то даже для них рационально будет или остановить разработку (с некоторыми оговорками), или хотя бы снизить темп. Другое дело что они могут (пока) не верить и/или не воспринимать это всерьёз — а поскольку многие комментаторы, ставшие экспертами как в политике, так и в ИИ, считают, что это невозможно в принципе (потому что вы видели? модели же не умеют думать и даже просто считать буквы в словах), то и сам разговор как будто бы становится ни о чём.

В общем, что интересного было в интервью:
— в Китае уже действуют очень жесткие регуляции, и у них «накачана мышца» в оформлении и контроле следования регуляциям. Правда целятся они пока не во всемогущих ИИ-агентов, а во что-то попроще: рекомендательные системы, цензура алгоритмов, ИИ-компаньёны и отношения с ними (серьезно, я даже про такое не знал, а у них это было большой проблемой, которую взяли на контроль).

— таким образом Китай уже сделал несколько итераций, кабинеты заполнены уже что-то понимающими в технологиях чиновниками и экспертами, есть какие-никакие процессы: регистрация, проверки, стандарты, взаимодействие с компаниями/лабораториями. Этот опыт очень сильно поможет в будущем, не придется начинать с нуля. Тут США как раз наоборот очень сильно отстают. Но да, техническую экспертизу по новым рискам ещё нужно развивать.

— поэтому для Китая США выглядят глупо: началось обсуждение регуляций, а пока что ничего не введено, никакого контроля почти ни за чем, связанным с ИИ. Никаких серьезных ограничительных шагов нет, но если и когда они появятся — это может быть серьёзным толчком к диалогу. Представьте: вам часть ваших ученых говорит, что есть риски, и при этом вы видите, что главный конкурент их разделяет и замедляется. Появляется существенная предпосылка к тому, чтобы прислушаться и последовать примеру. Односторонние ограничения могут стать убедительным сигналом серьёзности намерений.

— при этом на первых порах не обязательно, чтобы обе стороны подходили к вопросу симметрично или даже доверяли друг другу полностью: Основа сотрудничества — собственная заинтересованность обеих стран в предотвращении потери контроля над ИИ. Для этого не требуется предварительно разрешить всё геополитическое противостояние.

— уже есть прецеденты создания рабочих групп, налаживания каналов обмена информации и регулярного диалога. Например, раз, два.

— и вот чему я был удивлён ещё больше (в основном потому, что китайские материалы до меня не доходят): оказывается в сентябре на пресс-конференции National Cybersecurity Awareness Week выступал заместитель главы Бюро координации кибербезопасности Китая, и там в числе прочего перечислили пять основных категорий рисков и вызовов в сфере ИИ. И «Риски экстремальной потери контроля над ИИ» заняли второе место в этом списке, хотя раньше именно в такой формулировке (с «экстремальная потеря контроля») не появлялись. И это не пустые слова — 14-го сентября National Cybersecurity Standardization Technical Committee опубликовали обновление своего фреймворка управления безопасностью. Это уже третья версия, поэтому можно увидеть, что предыдущие две очень сильно влияли на регуляции, и третья, скорее всего, тоже будет взята во внимание.

Так что Китай может быть пока и не пришёл к окончательной уверенности в экзистенциальных ИИ-рисках/рисках потери контроля над ИИ, но обсуждает и воспринимает это достаточно серьёзно. Возможно, что они введут меры, схожие с предложенными Dario Amodei в эссе (независимые наблюдатели с доступом + публикация отчётов об инцидентах, итд), раньше США — по крайней мере на федеральном уровне.

И напомню, что примерно через неделю представители верхушек США и Китая встретятся для обсуждения ИИ-рисков.

Такие времена 🤷‍♂️
  • 🔥 179
  • 👍 88
  • 🤡 34
  • 🤔 17
  • 🌚 14
  • ❤‍🔥 7
  • 🤯 4
  • 💩 4
  • 👎 3
  • 👨‍💻 1
Post #3936 24.2K

Forwarded from SpaceX | Starship News

🚀📸Илон Маск рассказал о следующих важных этапах разработки Starship:

Впереди у нас 14-й испытательный полет. Это будет последний полет перед тем, как мы попытаемся поймать корабль. Если этот полет пройдет успешно, то в 15-м полете мы попробуем поймать корабль. Либо в конце этого года, либо, скорее всего, в начале следующего, мы повторим полет корабля и ускорителя.

Как только мы сможем повторно использовать корабль, мы создадим первую полностью многоразовую орбитальную ракету. Она разработана не только для полной многоразовости, но и для быстрой повторной эксплуатации, как самолет. Это очень важный прорыв. Это действительно ключевой прорыв, необходимый для расширения жизни за пределами Земли.

Я бы сказал, что шансы поймать корабль составляют как минимум 50 или 60%. Если бы там была башня, она бы поймала корабль в последнем полете. Конструкция позволяет осуществлять полную многоразовость. В этом я уверен. Я думаю, что крайне вероятно, что в следующем году, в 2027 году, мы достигнем полной многоразовости с быстрой повторной эксплуатацией.
  • 👍 243
  • 🔥 155
  • 🤯 26
  • 🤡 26
  • ❤‍🔥 9
  • 🎉 9
  • 🤔 2
  • 💩 2
  • 👨‍💻 1
Post #3935 24.1K
RationalAnswer | Павел Комаровский В комментах мне сейчас часто пишут что-то вроде: «Нравилось читать Павла про финансы. А сейчас совсем кринжово читать, когда Павел пытается хайпить на теме, в которой совсем не разбирается, делая некие выводы.» Надо, наверное, пояснить, как я про это думаю.…
Возьму себе кредит за подкидывание Паше идеи поста 😂

Но вообще зная Павла несколько лет и имев с ним несколько плодотворных и глубоких дискуссий и даже споров — у меня осталось о нем исключительно положительное мнение. Особое удовольствие последних 2 недель — это читать его ответы в твиттере, где люди не могут нормально прочитать и/или пересказать, и на ходу придумывают (а как осознают — меняют тему). Каюсь, грешен.
  • 🌚 89
  • 🤡 86
  • 👍 39
  • ❤‍🔥 25
  • 🤣 15
  • 💩 9
  • 🔥 3
  • 🤔 1
  • 🤯 1
Post #3934 21.2K

Forwarded from RationalAnswer | Павел Комаровский

В комментах мне сейчас часто пишут что-то вроде: «Нравилось читать Павла про финансы. А сейчас совсем кринжово читать, когда Павел пытается хайпить на теме, в которой совсем не разбирается, делая некие выводы.»

Надо, наверное, пояснить, как я про это думаю.

Смотрите, моя ценность как автора никогда не была в том, что я как-то особенно виртуозно разбираюсь в финансах или экономике – нет, я там шарю на уровне обычного крепкого спеца, который в целом в теме, но не обладает некими уникальными знаниями, на голову превышающими всех остальных.

Моя ценность в том, что я стараюсь взвешенно и рационально подойти к любому вопросу – и по возможности объективно его проанализировать, принимая во внимание все доступные данные и точки зрения. Понятно, что в «родной» для меня теме финансов это сделать сильно проще, но к другим вопросам я стараюсь подходить точно так же.

Так вот, тезис «Павел не шарит как технарь за AI => следовательно, его выводы некорректны» как бы подразумевает, что любому профильному технарю сразу будет очевидно, что я неправ, и моя точка зрения ложная (а мне просто не хватает понимания, чтобы это заметить). Но это, конечно, не так: как писал вот здесь, огромное количество ведущих общепризнанных профессионалов из индустрии стоят на позиции, что экзистенциальные риски со стороны ИИ – это очень серьезная проблема для человечества.

Почему же мне кажется важным писать про это?

Потому что мы сейчас находимся где-то в той точке, когда эта идея про риск ИИ впервые получает шанс войти в мейнстрим-дискурс – так как способности новых агентных систем уже потенциально выглядят достаточно понятными в плане «что здесь может пойти не так» для широкой публики.

Проблема здесь в том, что с точки зрения «здравого смысла» любому нормальному человеку кажется очевидным, что рассказы про «сверхумный ИИ нас всех погубит» – это какая-то научно-фантастическая сказочка, серьезно относиться к которой абсурдно. А вот объяснение «жадные главы бигтехов нам врут, чтобы стать еще богаче» – это как бы понятная база, которую даже обосновывать как-то дополнительно не надо (мы такое уже видели сто раз на практике, и еще двести раз увидим).

И чтобы начать серьезно относиться к AI risk, нужно немного отодвинуть в сторону свою интуицию, и попробовать разобраться в вопросе на более детальном уровне – какие там у сторон с разными взглядами логические цепочки, как они парируют аргументы друга друга, и так далее. Сразу скажу: я тут, конечно, отнюдь не хочу заявить манипулятивный тейк в стиле «любой умный человек, кто детально поразбирается в этом, обязательно станет AI-думером!». Я скорее о том, что я понимаю, почему большинство адекватных людей по умолчанию попадают в категорию «это просто глупости, в которых нет смысла даже разбираться».

Короче, что я пытаюсь сказать: если вы меня в последнее время читаете с мыслью «Павел всегда раньше казался адекватным и здравомыслящим, а сейчас вот у него почему-то кукуха отлетела по одной конкретной теме» – то, возможно, имеет смысл рассмотреть также и гипотезу «Павел, как обычно, адекватно и здравомысляще покопался в этой теме – и просто пришел к выводу, что к рискам ИИ надо относиться серьезнее, чем принято считать в мейнстриме». Ну, чисто как предположение…
  • 👍 207
  • 🤡 195
  • ❤‍🔥 59
  • 🔥 12
  • 💩 11
  • 🤣 8
  • 🌚 6
  • 👎 2
Post #3933 36.4K
CEO Anthropic Dario Amodei выпустил мини-эссе «Нам нужно контролировать темп развития передовых ИИ-систем». С его основной идеей уже согласились CEO OpenAI и xAI. Выжимка:
— Anthropic и раньше тратили много усилий на изучение и снижение рисков ИИ, информирование общества и продвижение регулирования — несмотря на обвинения в хайпе, «думерстве» и захвате отрасли через регуляции.
— Но за последние несколько месяцев Dario пришёл к выводу, что этого уже недостаточно: меры безопасности могут просто не успевать за ростом возможностей моделей. Поэтому, по его мнению, нужно сознательно ограничивать скорость развития frontier-моделей, хотя даже при таком подходе прогресс всё равно будет очень быстрым.
Причины две:
— примерно с этого лета развитие ИИ резко ускорилось — прежде всего из-за того, что ИИ всё лучше помогает создавать следующее поколение ИИ.
— инцидент со взломом Hugging Face агентами OpenAI. Dario опасается, что уже через 6–12 месяцев подобный рой агентов потенциально сможет создать устойчивый ботнет огромного масштаба и причинить ущерб на сотни миллиардов долларов.

При этом «контроль темпа» не означает остановку обучения моделей. Идея в том, чтобы между скачками возможностей оставалось достаточно времени на alignment, safeguards и независимую проверку их эффективности.

Он предлагает три последовательных шага.
1. Встроенные независимые оценщики
Frontier-лаборатории должны дать внешним организациям вроде METR постоянный доступ почти на уровне сотрудников компании. Они смогут проверять не только готовые модели, но и сами процессы обучения и деплоя, соблюдение заявленных мер безопасности и внутренние инциденты.
Это важно потому, что сейчас компании сами решают, что раскрывать публике. Независимые оценщики должны иметь возможность публично сообщать о рисках, инцидентах, качестве предоставленного им доступа и даже о случаях, когда компания попыталась вырезать из отчёта существенную информацию.
Anthropic уже добровольно обязуется внедрить такую систему у себя.

2. Координация демократических стран
Frontier-компании в демократических странах должны договориться об общих стандартах безопасности и ограничениях на неконтролируемую гонку возможностей. Поскольку законодательство движется медленнее ИИ, часть таких правил лаборатории могут принять добровольно ещё до появления законов.
Но Amodei подчёркивает: замедляться нужно так, чтобы при этом не потерять технологическое преимущество демократических стран над авторитарными. Поэтому он предлагает:
— не продавать Китаю мощные ИИ-чипы и оборудование для их производства и бороться с контрабандой и удалённым доступом к зарубежным GPU;
— пресекать несанкционированную дистилляцию frontier-моделей компаниями из авторитарных стран;
— сильнее защищать сами веса моделей от кражи.

По его оценке, это может достаточно замедлить Китай, чтобы заметно увеличить преимущество США в следующие 3–5 лет — период, когда ИИ станет особенно важен геополитически. Это не уменьшит вероятность будущих договорённостей с Китаем, а наоборот увеличит переговорные рычаги демократических стран.

3. Глобальная координация
Следующий уровень — соглашения уже между США и другими демократиями с одной стороны и авторитарными государствами с другой. Dario предлагает несколько возможных уровней:
Уровень 1: запрет очевидно опасных применений ИИ — например, для создания биологического оружия.
Уровень 2: обязательное тестирование frontier-моделей перед релизом на серьёзные риски в кибербезопасности, биологии и alignment.
Уровень 3: своего рода «скоростной лимит» на recursive self-improvement (RSI).

Главная логика всего эссе: современные модели уже дают огромное количество информации о том, как строить более сильный ИИ и что может пойти не так. Если контролируемое замедление даст хотя бы дополнительный год-два до появления систем критического уровня возможностей, это время можно использовать для решения проблем alignment и безопасности.

И даже если формальных международных соглашений добиться не получится, Dario считает, что уже само изменение неформальных норм поведения frontier-лабораторий может существенно помочь.
  • 🤡 301
  • 👍 197
  • 🤔 31
  • ❤‍🔥 24
  • 🎉 23
  • 🌚 19
  • 🤣 17
  • 💩 15
  • 🤯 5
  • 👨‍💻 4
Post #3932 114K
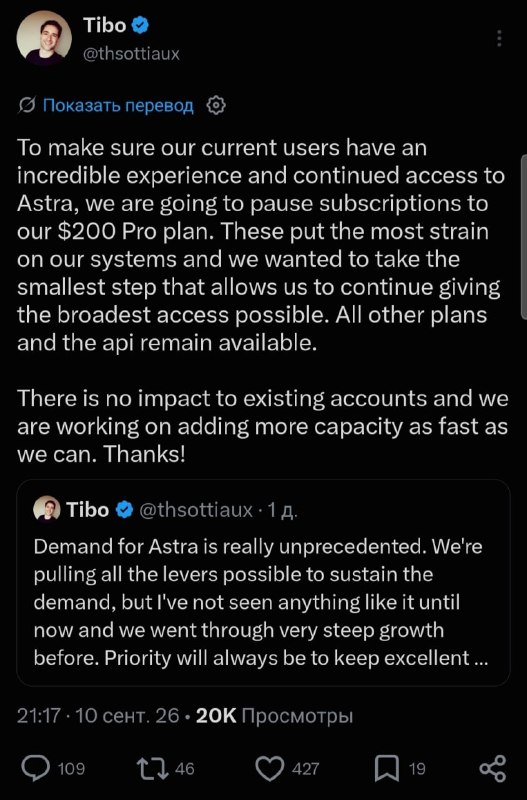
Подписки проданы, подписок больше нет — Tibo написал, что они приостанавливают продажу подписок за $200, чтобы сохранить качество сервиса для текущих пользователей. Plus за $20 и x5 за $100 пока остаются.

Запуск Astra прошёл хорошо 🚀 но зато видно, почему Anthropic дают Fable лишь на 50% от подписки — реально сложно поддерживать спрос 😳😳

НУЖНО. БОЛЬШЕ. КОМПЬЮТА.
  • 🤯 290
  • 🔥 76
  • 🌚 25
  • 🤡 15
  • 👎 11
  • 🤣 6
  • 💩 5
  • 👨‍💻 4
Post #3931 35.1K
Сиолошная OpenAI выложили блогпост https://openai.com/index/navier-stokes-solution/ Мы публикуем решение проблемы существования и гладкости решений уравнений Навье—Стокса — одной из задач тысячелетия. Это доказательство, полученное внутренней системой OpenAI, показывает…
В NYT вышла колонка с названием «В противостоянии OpenAI и Antrhopic математик из Нью-Йоркского университета выходит из ситуации проигравшим» (ссылка без пейволла). В ней OpenAI дали комментарии прессе, расширив свои показания:

В среду вечером, отвечая на вопросы The Times, OpenAI заявила <...>: «Мы можем категорически утверждать, что промпты доктора Бакмастера, отправленные в Codex за последние два месяца, никоим образом не могли повлиять на нашу систему, в том числе через обучение». В заявлении также говорилось: «Никакие пользовательские запросы после 3 июля не могли каким-либо образом повлиять на эту систему».


Напомню, что математики пришли к промежуточному результату (который был... сгенерирован другой моделью) 15-го августа. И оба автора признают, что они расширяют идеи, выраженные в статье других математиков за 2023-й год, и что им «принадлежит заслуга за основную идею нашего результата» (это цитата из оригинального 4-страничного письма).

В целом, я всё ещё жду авторитетного мнения от какого-то математика-эксперта по тому, насколько далеко промежуточный результат от финального решения, и насколько на самом деле это было «необычное» направление для исследований. Например, в тот же день вышла другая работа от ребят из Berkley и Caltech, которая целилась в +- тот же промежуточный результат 🤷‍♂️ настолько ли неочевидно направление, если оно описано в статье 2023-го года?

Ну ладно, это уже мелочи, вот на сладкое из комментариев OpenAI в колонке NYT:

В своём заявлении в среду вечером OpenAI сообщила: «Кроме того, после завершения работы над задачей Навье—Стокса мы добились существенного прогресса в решении ещё одной задачи тысячелетия. Сейчас мы прорабатываем, как наиболее правильно поделиться этими результатами».


Математики всех департаментов уже готовятся перебирать логи переписок с Codex и на математических форумах, чтобы объявить, что у них украли идею 🧠
  • 🔥 217
  • 🤯 66
  • 🤡 66
  • 🤣 31
  • 👍 14
  • 🌚 8
  • 👎 5
  • 🤔 4
  • 💩 3
  • 👨‍💻 3
Post #3930 38.8K
Смешно, что на Reddit на r/math до сих пор нет поста о том, что решили задачу тысячелетия...🥁🥁 потому что посты про AI-доказательства запрещены

Хейт к AI очень многим мешает смотреть на факты и трезво оценивать допущения, не наклеивая лейблы
  • 🤣 547
  • 🤡 125
  • 🌚 65
  • 👍 55
  • 🔥 9
  • 💩 9
  • 👎 7
  • 👨‍💻 1
Post #3929 87K
Сиолошная OpenAI выложили блогпост https://openai.com/index/navier-stokes-solution/ Мы публикуем решение проблемы существования и гладкости решений уравнений Навье—Стокса — одной из задач тысячелетия. Это доказательство, полученное внутренней системой OpenAI, показывает…
Трудно по-настоящему «почувствовать AGI», пока не увидишь, как ИИ превосходит тебя в области, которая тебе по-настоящему важна. На этой неделе многие математики и физики в OpenAI пережили свой «момент Ли Седоля», увидев, как эта модель за считанные минуты решает открытые задачи, над которыми они безуспешно бились годами.

— Noam Brown

Это потрясающее историческое достижение и новая жемчужина в короне трансформеров, предобучения, обучения с подкреплением и масштабирования вычислений во время инференса. ИИ уже двигает цивилизацию вперёд, и нетрудно представить, как в ближайшие годы подобные системы будут всё сильнее определять темп нашего прогресса.


— Jerry Tworek
  • 🔥 305
  • 🤡 85
  • ❤‍🔥 39
  • 💔 16
  • 🤯 12
  • 👎 6
  • 💩 6
  • 🌚 6
  • 👨‍💻 6
  • 😭 4
Post #3928 32.3K
Это-то всё хорошо, но почему ходили слухи, что Anthropic решили ДВЕ задачи тысячелетия? 😳 OpenAI недорабатывают...
  • 🤣 276
  • 🌚 39
  • 👍 22
  • 🤡 13
  • 👨‍💻 3
  • 🤯 1
Post #3926 39.7K
Сиолошная OpenAI выложили блогпост https://openai.com/index/navier-stokes-solution/ Мы публикуем решение проблемы существования и гладкости решений уравнений Навье—Стокса — одной из задач тысячелетия. Это доказательство, полученное внутренней системой OpenAI, показывает…
Что ещё пишут в посте:

— С 28 августа OpenAI обучает новую внутреннюю модель, которая показала беспрецедентные результаты на внутренних тестах, в том числе по математике (см. выше). Она сильно лучше Astra.

— Во вторник, 1 сентября, до OpenAI дошли слухи о решении двух задач тысячелетия (откуда две...). Вдохновлённые этими слухами и резким скачком результатов внутренней модели, они решили проверить её на всех нерешённых задачах тысячелетия и нескольких других особо значимых задачах.

— Они использовали систему взаимодействующих агентов на базе этой модели. Агентам были доступны инструменты для чтения кешированной версии интернета (исправились после взлома агентами, хаха) и выполнения кода. Агенты были разделены на группы и могли общаться внутри своей группы. Размеры групп различались; в группе, которая получила решение задачи Навье — Стокса, одновременно работало около 10 000 агентов (охренеть).

— Для каждой задачи они давали разным группам агентов разные варианты её формулировки, охватив все варианты. В случае задачи Навье — Стокса отдельным группам мы предложили варианты «A» и «B» — конкретные формулировки, решение которых означало бы доказательство исходного утверждения, — и варианты «C» и «D», решение которых означало бы его опровержение. По итогу именно C и D доказали. Эти варианты не выдуманы OpenAI, они есть в официальной формулировки института, выдающего награду за решение Задач тысячелетия.

— Увидев решение одной из промежуточных задач (той же, что вчера опубликовали два математика), они сочли задачу Навье — Стокса наиболее перспективной для дальнейшей работы. Поэтому решили сосредоточить на ней ресурсы: перевели агентов с других задач и включили в их промпты решение промежуточной задачи. Когда в ходе работы стала доступна версия нашей внутренней модели, прошедшая дополнительное обучение, агентов перевели на неё.

— Через некоторое время организовали обмен наработками между группами: с помощью Codex собрали наиболее полезные идеи каждой группы. Последующие промпты опирались на промежуточные результаты самих агентов. Именно так направляли работу группы, нашедшей решение задачи Навье — Стокса. Это пересекается с тем, что было в письме математика — там автор говорил, мол, ему передали, что даже промпт в систему писали не люди, а Codex.

— Агенты получили решение в субботу, 5 сентября, примерно через 88 часов после запуска первых агентов. Формализация и проверка в Lean с помощью GPT‑6 Astra заняли ещё 17 часов.

— В общей сложности при работе над всеми задачами агенты отправили 4,9 миллиона сообщений и сгенерировали около 300 миллиардов выходных токенов.

— После завершения всего проекта и проверки в Lean, 6 сентября, OpenAI связались с авторами: исходя из слухов, OpenAI полагали, что у тех тоже есть решение задачи Навье — Стокса, и предложили одновременно опубликовать результаты и признать их приоритет в совместном объявлении (= хотели подмазаться 😀). Тогда и узнали, что те решили промежуточную задачу. В ходе обсуждений им предложили ознакомиться со всеми использованными промптами, а позднее — и с доказательством.

— Ни агенты, ни исследователи OpenAI не видели ни по каким каналам их работу до её публикации вчера вечером. В частности, для решения этой задачи OpenAI не обращались к данным конкретных пользователей.

— OpenAI не может исключить, что обезличенные данные, полученные в результате использования их продуктов, помогли «улучшить модели» (это как раз галочка «разрешить тренироваться на моих данных» в настройках). Однако по мнению OpenAI доказательства существенно различаются, а в случае промежуточной задачи различаются даже сами доказанные утверждения (с внешней силой и без неё). Хочется конечно верить, но тут будем ждать вердикта математического сообщества, насколько идеи те же и схожи, и насколько вероятно вообще, что они утекли через тренировочные данные.

— OpenAI не намерены претендовать на премию в миллион долларов за решение одной из Задач тысячелетия.
  • 🔥 247
  • 🤯 99
  • 👍 39
  • 🤡 28
  • 👎 6
  • 🎉 5
  • 💩 3
  • 👨‍💻 3
  • 🌚 1
Post #3925 28.8K
Сиолошная OpenAI выложили блогпост https://openai.com/index/navier-stokes-solution/ Мы публикуем решение проблемы существования и гладкости решений уравнений Навье—Стокса — одной из задач тысячелетия. Это доказательство, полученное внутренней системой OpenAI, показывает…
  • 🎉 132
  • 🤡 29
  • 👍 15
  • ❤‍🔥 9
  • 🔥 6
  • 💩 4
  • 🤣 2
  • 👨‍💻 1
Older posts →

About this channel

How can I read @seeallochnaya without a Telegram account?
TGViewer shows the public web preview Telegram publishes for Сиолошная: recent posts, photos, videos and the subscriber count, with no app, login or account.
How many subscribers does Сиолошная have?
Сиолошная (@seeallochnaya) has 79.7K subscribers on Telegram, refreshed roughly every 30 minutes.
Does Сиолошная know I viewed it here?
No. Public channel previews carry no viewer identity, and TGViewer has no accounts or tracking of what you look up.
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →