TGViewer
Channel Public Channel
immers.cloud | Облако с GPU

immers.cloud | Облако с GPU

@immers_cloud

immers.cloud — облачный GPU-сервис с широким выбором видеокарт для ML, генеративных моделей, 3D и рендеринга.

Самый большой ассортимент GPU Tesla и RTX 💻

👉 Наш сайт https://immers.cloud/
🎧 @immerscloudsupport

Чат по ИИ - https://t.me/immersAI
Subscribers
943
Photos
1.3K
Videos
9
Links
317

Showing posts older than #1333 · Back to latest

Older Posts 4 shown
Post #1327 667
DeepSeek-V4-Flash-0731: что обновили в новой версии

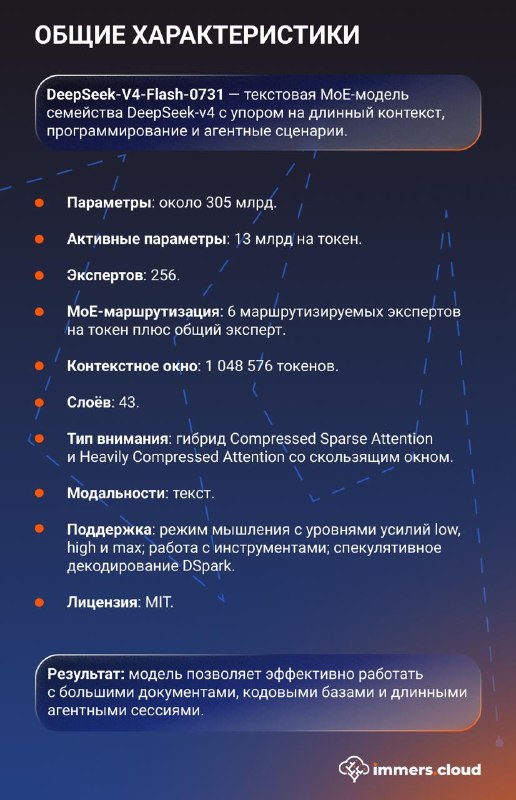
👋 DeepSeek-V4-Flash-0731 — обновлённая текстовая MoE-модель на 305 млрд параметров. При обработке каждого токена активируются 13 млрд параметров, а контекстное окно достигает 1 048 576 токенов.

📌 Главная инженерная инновация линейки V4 — гибридное внимание, снижающее затраты на обработку длинного контекста.

Что важно:

▪️ Compressed Sparse Attention сжимает контекст в пропорции 1:4, после чего Lightning Indexer отбирает наиболее релевантные блоки для вычисления внимания.

▪️ Heavily Compressed Attention применяет сжатие 1:128 и сохраняет глобальный обзор всей истории. Скользящее окно из 128 токенов параллельно обрабатывает ближайший контекст без сжатия.

▪️ Встроенный модуль DSpark поддерживает спекулятивное декодирование: предлагает несколько будущих токенов и позволяет основной модели проверить их за один шаг.

📲 Подробнее об архитектуре, бенчмарках и сценариях использования — в слайдах.

📎 Оригинальные веса в формате 8-bit занимают около 155,43 GiB. Память под KV-cache при работе с контекстом до миллиона токенов необходимо рассчитывать отдельно.

➡️ Бесплатно проверить DeepSeek-V4-Flash-0731 можно через публичный API-эндпоинт в каталоге Immers Foundation Models. Для доступа необходимо зарегистрироваться, пройти верификацию и выпустить токен.

☁️ Для изолированного развёртывания в immers.cloud модель доступна на конфигурациях 2 × H200 или 4 × H100.
  • 👍 2
  • 👏 2
  • ❤ 1
  • ⚡ 1
  • 🔥 1
Post #1320 667
Unlimited-OCR: как распознавать многостраничные документы за один проход

👋 Unlimited-OCR — открытая мультимодальная OCR-модель от компании Baidu. MoE-архитектура на 3 млрд параметров из которых при генерации активируются только 500 млн.

📌 Главная особенность — возможность обрабатывать несколько страниц одновременно за один проход.

Что важно:

▪️ Ключевая научная новелла модели — Reference Sliding Window Attention (R-SWA). Этот механизм позволяет зафиксировать объём KV-cache и не увеличивать его при генерации токенов, при этом постоянно сохраняя доступ ко всем исходным токенам: изображениям и запросу-промпту.

▪️ Страницы PDF преобразуются в изображения и загружаются в общий контекст. Это позволяет непрерывно распознавать книги, архивы, отчёты и комплекты документов без отдельного запуска для каждой страницы.

▪️ DeepEncoder сжимает страницу размером 1024 × 1024 до 256 визуальных токенов. Контекстное окно модели составляет 32K токенов, поэтому фактическое количество одновременно обрабатываемых страниц зависит от их разрешения и объёма опорного префикса.

📲 Подробнее в слайдах.

📎 При выборе GPU учитывайте не только размер весов, но и KV-cache, а также объём префикса, который увеличивается с количеством и разрешением страниц.

➡️ Бесплатно протестировать Unlimited-OCR можно через публичный API-эндпоинт. Чтобы получить доступ, необходимо создать аккаунт, пройти верификацию и выпустить токен.

☁️ Если для рабочих задач нужен изолированный сервер, модель можно развернуть на Tesla A2 от 33,74 ₽/ч.

📎 Об особенностях направления запросов по API в модель можно узнать по ссылке.
  • ❤ 2
  • ⚡ 2
  • 👍 1
  • 🔥 1
Post #1319 758
🚀 Бесплатные публичные AI-эндпоинты

В каталоге Immers Foundation Models можно бесплатно протестировать open-source модели через чат или API — без оплаты за токены. Это удобный способ оценить качество генерации, проверить tool calling и собрать прототип.

1. GPT-OSS-20B
Компактная модель OpenAI для рассуждений, программирования и агентных задач.
▶️ Протестировать GPT-OSS-20B

2. Llama-3-8B-GPT-4o-RU
Версия Llama 3, дообученная для качественной работы с русским языком.
▶️ Протестировать Llama-3-8B-GPT-4o-RU

3. NVIDIA Nemotron-3-Nano-30B-A3B
Модель для агентных систем, RAG, обработки длинного контекста и генерации кода.
▶️ Протестировать NVIDIA Nemotron-3-Nano

4. Qwen3-Coder-Next
Модель для программирования и автономных coding agents: анализирует репозитории, находит ошибки и предлагает патчи.
▶️ Протестировать Qwen3-Coder-Next

5. Qwen3.5-35B-A3B
Мультимодальная модель для текста и изображений с режимами Thinking и No-thinking.
▶️ Протестировать Qwen3.5-35B-A3B

6. Gemma-4-26B-A4B-it
Мультимодальная MoE-модель Google для работы с текстом, изображениями и агентными сценариями.
▶️Протестировать Gemma-4-26B-A4B-it

🆕 Новые модели для обработки документов:

7. Unlimited-OCR
Распознаёт сразу несколько страниц документа в одном запросе. Подходит для технической документации, архивов и многостраничных контрактов.
▶️ Протестировать Unlimited-OCR

8. PaddleOCR-VL-1.6
Компактная модель для распознавания текста, таблиц, формул и структуры документов.
▶️ Протестировать PaddleOCR-VL-1.6

Выберите модель и тестируйте ее бесплатно на immers.cloud.
  • 🔥 3
  • ❤ 1
  • ⚡ 1
  • 👍 1
  • 👏 1
Post #1313 592
PaddleOCR-VL-1.6: как компактная модель разбирает сложные документы

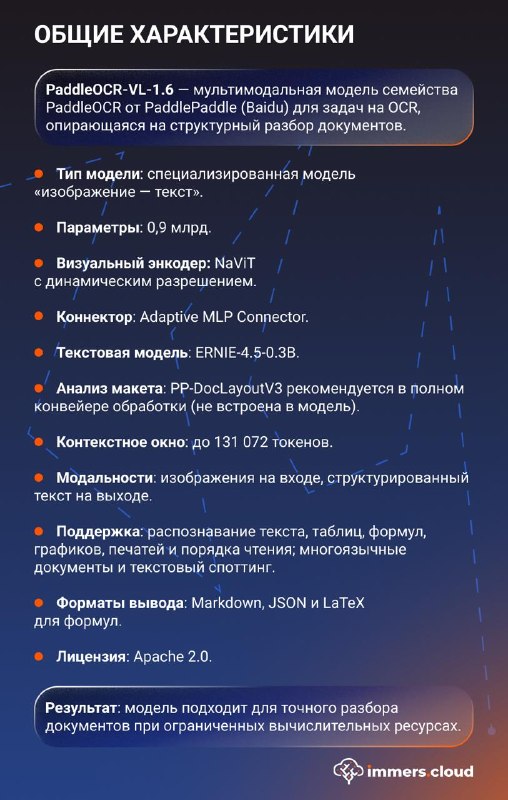
👋 PaddleOCR-VL-1.6 — открытая мультимодальная модель PaddlePaddle (Baidu) на 0,9 млрд параметров, специализированная на преобразовании PDF, сканов и фотографий в структурированные Markdown и JSON.

📌 Главное изменение относительно версии 1.5 — не новая архитектура и не увеличение числа параметров, а точечная оптимизация областей данных, в которых предыдущая модель работала нестабильно.

Что важно:
▪️ Обработка документов в исходном масштабе
Визуальный энкодер NaViT работает с динамическим разрешением и обрабатывает фрагменты изображения без обязательного приведения всей страницы к фиксированному размеру. Это помогает сохранять мелкий текст, формулы и детали сложных таблиц.

▪️ Оптимизация слабых областей
Система подготовки данных ищет нестабильные примеры, редкие типы документов и ошибки разметки. Проблемные области используются для расширения данных, а неподтверждённые метки проверяются независимыми экспертными парсерами.

▪️ Разбор структуры документа
В полном конвейере PaddleOCR-VL-1.6 используется вместе с PP-DocLayoutV3: модель анализа макета локализует области страницы, а PaddleOCR-VL-1.6 распознаёт текст, таблицы, формулы, графики, печати и порядок чтения.

📲 Подробнее об архитектуре, бенчмарках и сценариях использования — в слайдах.

📎 При тестировании обратите внимание на особенности направления запросов по API и рекомендации по синхронизации с моделью PP-DocLayoutV3, подробнее по ссылке.

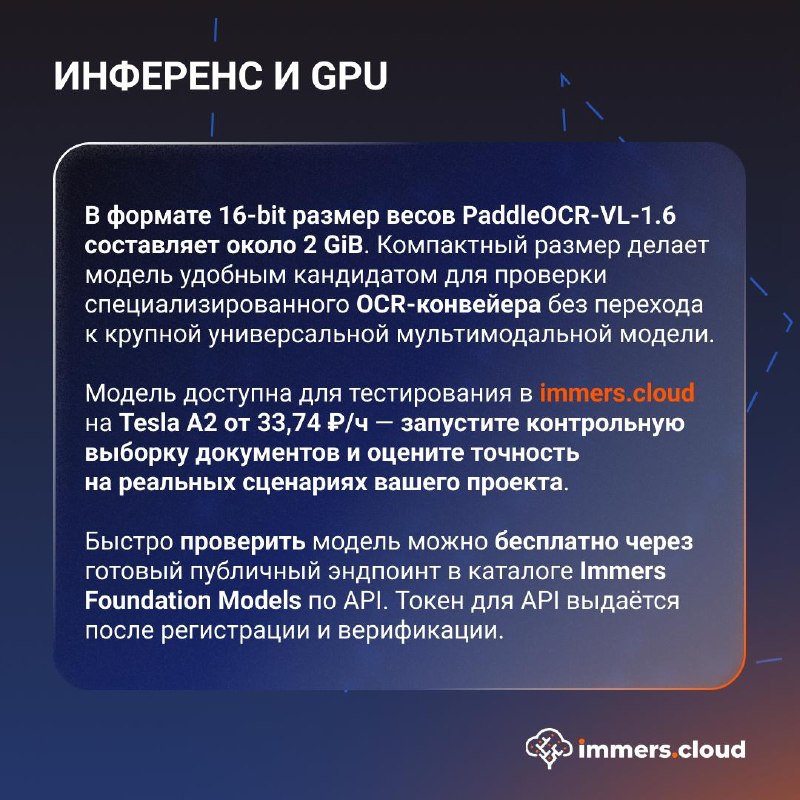
➡️ PaddleOCR-VL-1.6 можно бесплатно проверить через публичный эндпоинт по API. Для доступа к API достаточно зарегистрироваться, пройти верификацию и получить токен.

Если потребуется частный сервер, модель доступна на Tesla A2 от 33,74 ₽/ч.

#ИИ_Модели #LLM
  • 🔥 2
  • 👏 2
  • ❤ 1
  • 🤔 1
Older posts →
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →