TGViewer
Channel Public Channel
immers.cloud | Облако с GPU

immers.cloud | Облако с GPU

@immers_cloud

immers.cloud — облачный GPU-сервис с широким выбором видеокарт для ML, генеративных моделей, 3D и рендеринга.

Самый большой ассортимент GPU Tesla и RTX 💻

👉 Наш сайт https://immers.cloud/
🎧 @immerscloudsupport

Чат по ИИ - https://t.me/immersAI
Subscribers
943
Photos
1.3K
Videos
9
Links
317

Showing posts older than #1313 · Back to latest

Older Posts 5 shown
Post #1306 579
🖥 immersView — рабочий стол Windows в браузере

👋 Нужно подключиться к Windows-серверу, когда основного компьютера нет рядом? Или показать результат коллеге и вместе поработать с одной виртуальной машиной?

В карусели:
→ как открыть рабочий стол Windows без отдельного RDP-клиента
→ как пригласить других участников и настроить доступ
→ как передавать файлы и работать при разной скорости интернета
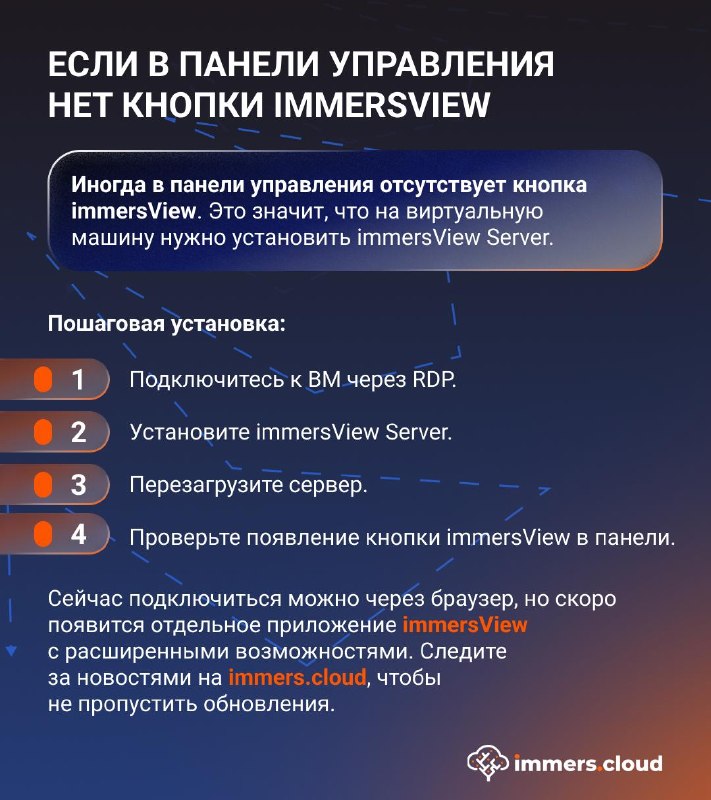
→ как подключиться за пять шагов
→ что делать, если кнопки immersView нет в панели управления

📲 Листайте слайды и сохраняйте инструкцию, чтобы она была под рукой. Браузерное подключение можно попробовать уже сейчас.

🎥 Смотрите подробный видеогайд:
📱 ВК

📱 YouTube

📺 Rutube
  • 🔥 3
  • 👍 2
  • ❤ 1
  • 👏 1
  • 😱 1
Post #1298 594
Kimi-K3: новый масштаб открытых моделей

👋 Kimi-K3 — мультимодальная MoE-модель Moonshot AI с 2,8 трлн параметров, контекстом до 1 млн токенов и открытыми весами. Это первая открытая модель класса 3T — масштаб, который до сих пор оставался преимущественно за закрытыми системами.

🚀 Релиз уже стал заметным событием для сообщества: за первые дни преодолела отметку 8 тыс. лайков, а сейчас приближается к 10 тыс.

Что важно:
▪️ KDA + Gated MLA
69 слоёв используют компактное рекуррентное внимание KDA, а 24 слоя Gated MLA сохраняют глобальную работу с контекстом. Гибридная схема рассчитана на последовательности длиной до 1 млн токенов.

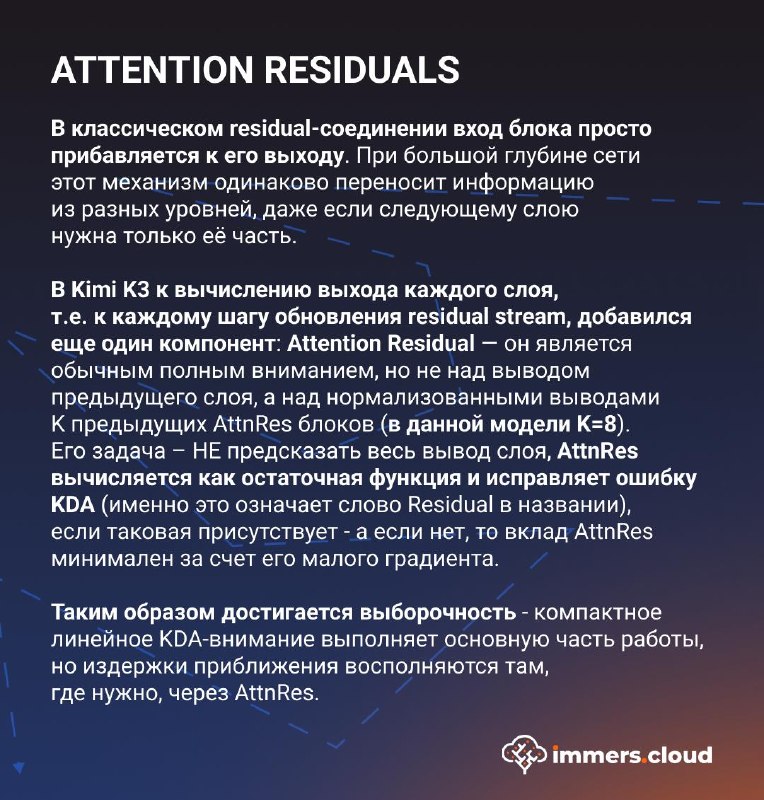
▪️ Attention Residuals
Модель не просто передаёт residual-состояние от слоя к слою, а выборочно извлекает представления из предыдущих уровней. Это помогает управлять потоком информации в сети глубиной 93 слоя.

▪️ Stable LatentMoE
Перед передачей экспертам активации сжимаются в латентное пространство вдвое меньшей размерности. В результате из 2,8 трлн параметров на токен активируется 104 млрд, а вычисления и коммуникации между экспертами остаются управляемыми.

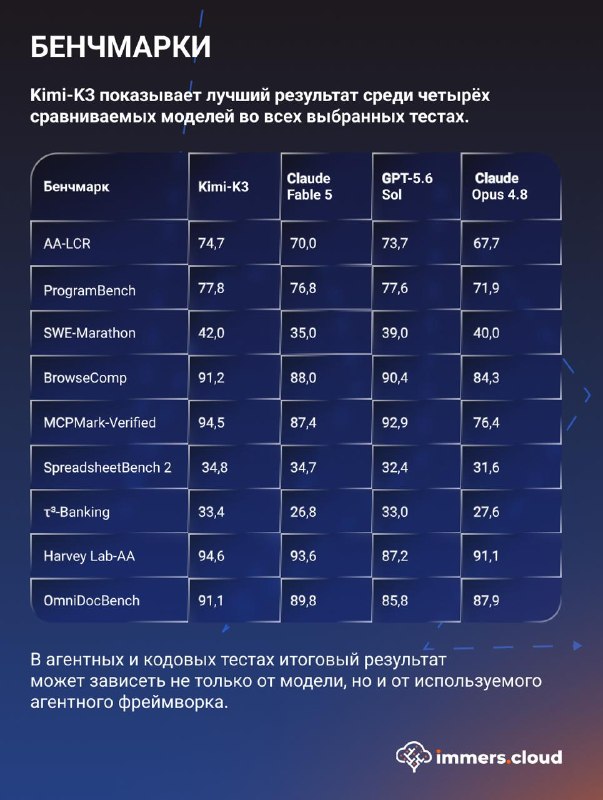
📲 Подробнее о KDA, Attention Residuals, Stable LatentMoE и результатах модели — в слайдах.

➡️ Перейти на страницу Kimi-K3

➡️ Посмотреть другие модели в каталоге Immers Foundation Models

#ИИ_Модели #LLM
  • 🔥 4
  • 🎉 3
  • ❤ 2
  • 👍 1
Post #1297 589
Сегодня, в последнюю пятницу июля, мы отмечаем День системного администратора.

⚙️ Эпоха обжима витой пары, настройки локальных принтеров и физического обслуживания железа постепенно уходит в прошлое. Сегодня фокус профессии сместился на оркестрацию контейнеров, управление распределенными системами, автоматизацию (IaC) и обеспечение отказоустойчивости облачных архитектур. Инструменты изменились, но главная цель осталась прежней: гарантировать бесперебойную работу цифрового мира.

🎉 Мы поздравляем инженеров, администраторов и всех, кто причастен к поддержке и развитию инфраструктуры!

Желаем, чтобы:
• Uptime стремился к 99.99%, а SLA всегда оставался в «зеленой зоне»;
• Релизы и деплои проходили по расписанию, а необходимость в экстренных откатах (rollback) свелась к нулю;
• Мониторинг реагировал только на реальные инциденты, а алерты не нарушали личные границы в выходные;
• Резервные копии всегда успешно проходили тесты на восстановление, а RTO и RPO соответствовали самым строгим требованиям.

Ваша работа часто остается незаметной для конечного пользователя, пока система работает штатно. Именно вы создаете надежный фундамент, на котором строятся бизнес-процессы и развиваются современные технологии.

❤️ Спасибо специалистам, благодаря которым цифровая инфраструктура остаётся надёжной, управляемой и безопасной. Желаем стабильной работы систем, успешной автоматизации и как можно меньше внештатных ситуаций!

🎁 В этот день мы подготовили для вас подарок — бонус 10% на пополнение счета! (Количество ограничено)
  • ❤ 6
  • 👍 2
  • 👏 1
  • 🎉 1
Post #1296 560
📢 SK Hynix прогнозирует усиление дефицита памяти в 2027 году

📰 SK Hynix — один из крупнейших производителей памяти и ключевой поставщик HBM для AI-ускорителей NVIDIA. От объёма и пропускной способности HBM напрямую зависит производительность GPU при обучении и инференсе нейросетей.

Глава SK Hynix предупредил, что в 2027 году отрасль может столкнуться с наиболее серьёзным дефицитом памяти за всю свою историю. По прогнозу компании, спрос продолжит превышать её производственные возможности и после 2030 года — несмотря на расширение производства.


Источник: Материал Reuters на Investing.com

💾 Что это значит для пользователей GPU?

Чем меньше доступной памяти, тем сложнее производителям наращивать выпуск серверных ускорителей. Это может привести к ограниченному выбору конфигураций, увеличению сроков поставки и росту стоимости оборудования.

В результате покупка собственного оборудования становится менее предсказуемой: дорогостоящий сервер нужно заказывать заранее, а его конфигурация может не соответствовать реальной нагрузке.

☁️ Как снизить инфраструктурный риск?

В каталоге Immers Foundation Models можно заранее оценить требования нейросети к памяти и выбрать подходящую GPU-конфигурацию.

Часть моделей доступна через публичные эндпоинты — их можно протестировать в чате или по API до запуска собственного сервера.

Для постоянной нагрузки модель можно развернуть как частный эндпоинт на GPU-сервере immers.cloud. Это позволяет не покупать оборудование заранее, подбирать ресурсы под конкретную задачу и масштабировать инфраструктуру по мере роста нагрузки.

✅ Вы платите за время работы выбранных серверных ресурсов, а не вкладываетесь в GPU, которые могут оказаться избыточными или недоступными в нужный момент.

➡️ Выбрать модель и GPU-конфигурацию
  • 👍 1
  • 👏 1
  • 🤔 1
  • 😱 1
Post #1287 582
Что влияет на расход VRAM?
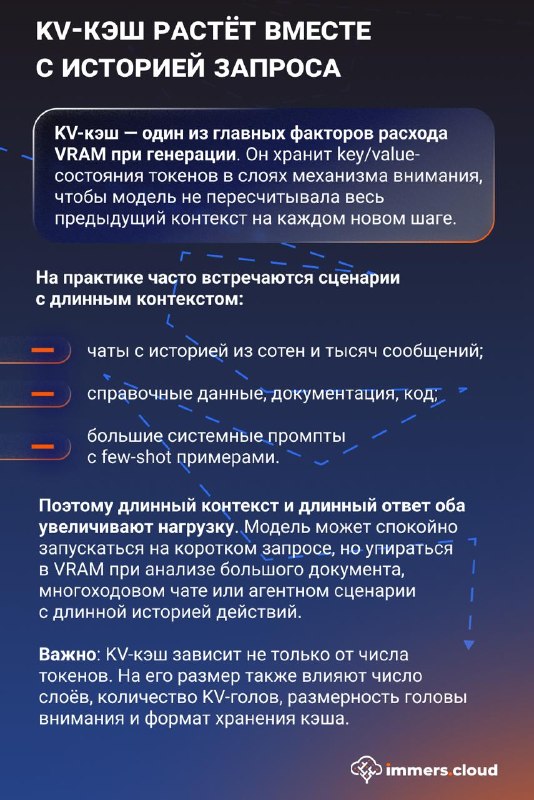
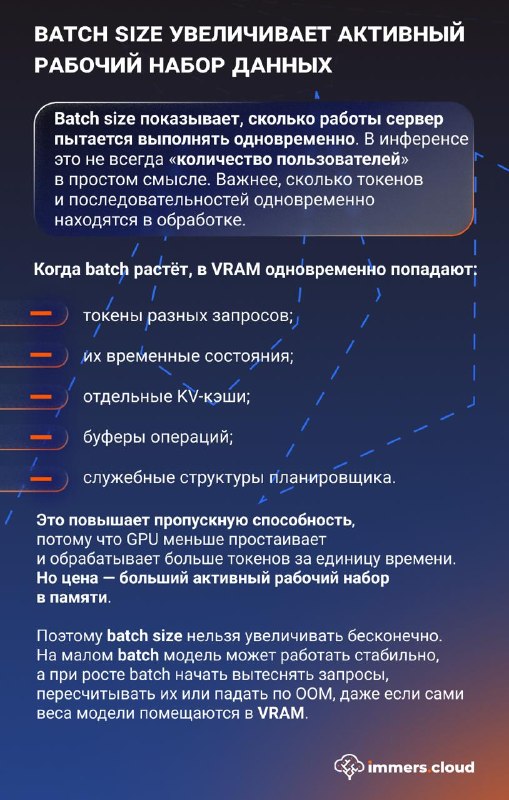
👋 Во время инференса память GPU расходуется сразу на несколько задач: хранение весов, KV-кэш, временные активации, batch, CUDA Graphs, служебные буферы и внутренние механизмы inference-фреймворка. Итоговое потребление зависит не только от самой модели, но и от того, как именно она используется.

📌 Один и тот же LLM может без проблем работать с короткими запросами, но столкнуться с нехваткой памяти при длинном контексте, большом числе одновременных пользователей или высокой параллельной нагрузке.

▪️ Именно поэтому сервер подбирают не только по размеру модели. Для корректного расчёта важно учитывать рабочий сценарий, длину контекста, ожидаемую генерацию, batch size, max concurrency, особенности GPU и используемый inference-фреймворк.

📲 Подробнее — в слайдах.

➡️ В Immers Foundation Models можно изучить характеристики open-source моделей, посмотреть рекомендуемые требования к ресурсам и протестировать модель через публичный эндпоинт, если он доступен. Для production-задач можно развернуть приватный сервер с GPU и подобрать конфигурацию под свою нагрузку.
  • ❤ 3
  • 👍 1
  • 🔥 1
  • 🎉 1
Older posts →
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →