TGViewer
Channel Public Channel
immers.cloud | Облако с GPU

immers.cloud | Облако с GPU

@immers_cloud

immers.cloud — облачный GPU-сервис с широким выбором видеокарт для ML, генеративных моделей, 3D и рендеринга.

Самый большой ассортимент GPU Tesla и RTX 💻

👉 Наш сайт https://immers.cloud/
🎧 @immerscloudsupport

Чат по ИИ - https://t.me/immersAI
Subscribers
943
Photos
1.3K
Videos
9
Links
317

Showing posts older than #1287 · Back to latest

Older Posts 4 shown
Post #1280 597
Что можно узнать из названия AI-модели?

👋 В названии ML-модели часто уже есть технические подсказки: линейка, поколение, размер, архитектура, специализация и формат весов.

📌 Например, в Qwen3.6-35B-A3B — 35B показывает общий размер модели, а A3B — активную часть MoE-модели, которая участвует в обработке одного токена.

➕ Суффиксы тоже важны. Code может указывать на специализацию под кодинг, it / instruct — на дообучение под инструкции, а FP8, INT4, AWQ или BF16 — на формат весов или квантизацию.

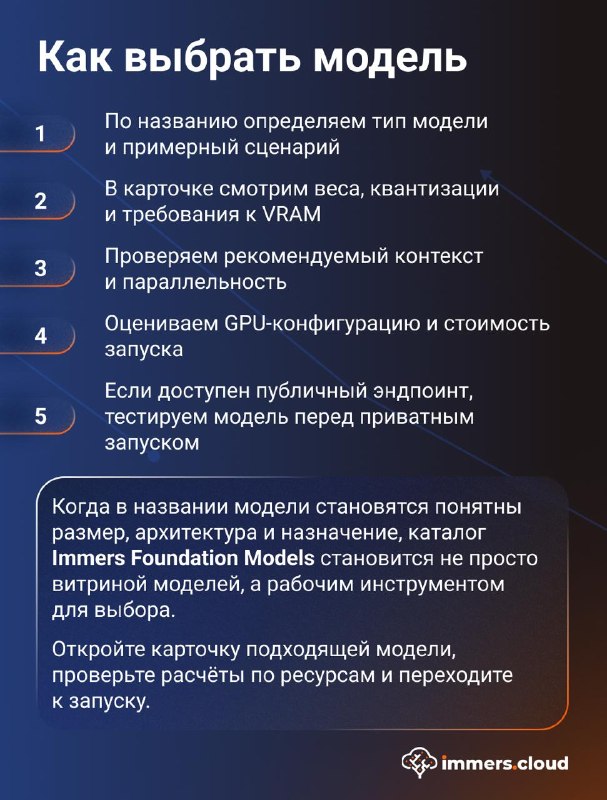
Название помогает быстро отсеять неподходящие варианты, но финальное решение лучше принимать по карточке модели: смотреть веса, VRAM, контекст, доступные конфигурации и стоимость запуска.

📲 Подробнее — в слайдах.

➡️ В Immers Foundation Models можно открыть карточку модели, проверить требования к ресурсам и перейти к запуску. Если доступен публичный эндпоинт — сначала протестировать модель перед приватным развёртыванием.
  • 👍 2
  • ❤ 1
  • 🔥 1
  • 🎉 1
  • 🏆 1
Post #1273 569
MiniMax-M3: как модель работает с 1M контекста

👋 MiniMax-M3 — открытая мультимодальная MoE-модель семейства MiniMax, рассчитанная на кодинг, агентные сценарии и инференс с длинным контекстом.

Главная особенность модели — MiniMax Sparse Attention: разреженное внимание, которое помогает обрабатывать последовательности до 1 048 576 токенов без линейного роста вычислительной стоимости внимания.

Что важно:
▪️ Контекст до 1M токенов
MiniMax-M3 можно рассматривать для задач, где модели нужно удерживать большие объёмы информации: репозитории, длинные документы, технические спецификации, логи, видео и многошаговые цепочки действий.

▪️ MiniMax Sparse Attention
MSA состоит из двух веток. Index Branch сначала оценивает блоки ключей-значений и выбирает релевантные части длинного контекста. Main Branch затем считает точное внимание только по выбранным блокам, а локальный блок ближайшего окружения токена сохраняется всегда.

▪️ Ниже стоимость внимания
При контексте 1 миллион токенов MSA сокращает вычислительные затраты на внимание на один токен в 28,4 раза по сравнению с GQA. Это критично для длинного контекста, где обычное внимание быстро становится дорогим по вычислениям и памяти.

📲 Подробнее — в слайдах.

➡️ MiniMax-M3 доступна через каталог моделей Immers Foundation Models: вы платите не за токены, а за время аренды GPU-сервера. Для запуска доступна конфигурация 4 × NVIDIA H200 от 1 717,59 ₽/ч.
  • ❤ 3
  • 🔥 3
  • 👍 1
  • 👏 1
Post #1272 692
🚫 Зарубежные API-провайдеры отключают Россию

OpenRouter и некоторые модели на Hugging Face Inference Endpoints все чаще блокируют запросы с российских IP. А если не блокируют — то выставляют счет за каждый токен, который при росте нагрузки превращается в непредсказуемый овердрафт.
Ваш ИИ-продакшен не должен зависеть от геополитики или ценовой политики Кремневой Долины.

👉 immers.cloud запустил Foundation Models — каталог проверенных open-source моделей, которые вы разворачиваете полностью на своем сервере с оплатой только за время работы GPU, а не за токены.

Все модели прошли ручную валидацию:

✔️ Рекомендуемый контекст
✔️ Требования к VRAM для каждой квантизации
✔️ Совместимость с поколениями GPU (от RTX 3090 до H200)
✔️ Максимальное число concurrent-запросов

Система сама подберет подходящую конфигурацию, развернет приватный эндпоинт и настроит OpenAI-совместимый API — за пару кликов.

🚀 Запустите свой инстанс — без VPN, без опасений блокировок, с предсказуемым бюджетом.

Immers Foundation Models

immers.cloud
  • 👏 5
  • ❤ 3
  • 👍 1
  • 🔥 1
  • 😱 1
Post #1265 644
Kimi-K2.7-Code: модель для длинных агентных задач в кодинге

👋 Kimi-K2.7-Code — open-source MoE-модель от Moonshot AI, ориентированная на сценарии, где модель должна не просто написать код, а пройти длинный инженерный цикл: понять задачу, исследовать кодовую базу, проверить гипотезы, вызвать инструменты и сохранить контекст между шагами.

Что важно:

▪️ Фокус на long-horizon coding tasks
Kimi-K2.7-Code рассчитана на задачи, где результат зависит не от одного удачного ответа, а от последовательной работы на длинной траектории. Это важно для рефакторинга, миграции кодовых баз, реализации многофайловых фич, code review и автономной работы по техническим спецификациям.

▪️ Сохранение рассуждений между ходами
Модель принудительно работает в thinking mode, а preserve_thinking позволяет сохранять reasoning-содержание между ходами диалога. Для агентных задач это критично: ассистент должен помнить, какие гипотезы уже проверены, какие ошибки найдены и какие промежуточные решения были приняты.

▪️ Многошаговая работа с инструментами
Kimi-K2.7-Code поддерживает Interleaved Thinking and Multi-Step Tool Call — механизм, который позволяет чередовать рассуждения и вызовы инструментов в одном процессе. За счёт этого модель лучше подходит для инженерных сценариев, где нужно не просто ответить, а выполнить цепочку действий.

📲 Подробнее — в слайдах.

➡️ Развернуть Kimi-K2.7-Code можно через каталог моделей Immers Foundation Models. Для запуска доступны конфигурации 6 × H200 от 2 535,78 ₽/ч или 8 × H200 от 3 338,30 ₽/ч — выбор зависит от требуемого профиля нагрузки и запаса памяти под длинный контекст.
  • 👏 3
  • ❤ 2
  • ⚡ 1
  • 🔥 1
Older posts →
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →