
Unlimited-OCR: как распознавать многостраничные документы за один проход
👋 Unlimited-OCR — открытая мультимодальная OCR-модель от компании Baidu. MoE-архитектура на 3 млрд параметров из которых при генерации активируются только 500 млн.
📌 Главная особенность — возможность обрабатывать несколько страниц одновременно за один проход.
Что важно:
▪️ Ключевая научная новелла модели — Reference Sliding Window Attention (R-SWA). Этот механизм позволяет зафиксировать объём KV-cache и не увеличивать его при генерации токенов, при этом постоянно сохраняя доступ ко всем исходным токенам: изображениям и запросу-промпту.
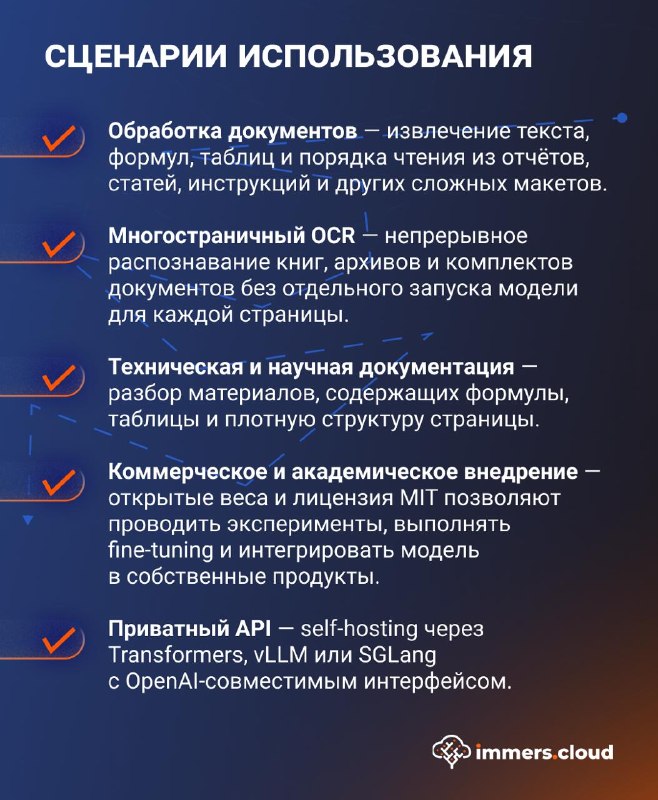
▪️ Страницы PDF преобразуются в изображения и загружаются в общий контекст. Это позволяет непрерывно распознавать книги, архивы, отчёты и комплекты документов без отдельного запуска для каждой страницы.
▪️ DeepEncoder сжимает страницу размером 1024 × 1024 до 256 визуальных токенов. Контекстное окно модели составляет 32K токенов, поэтому фактическое количество одновременно обрабатываемых страниц зависит от их разрешения и объёма опорного префикса.
📲 Подробнее в слайдах.
📎 При выборе GPU учитывайте не только размер весов, но и KV-cache, а также объём префикса, который увеличивается с количеством и разрешением страниц.
➡️ Бесплатно протестировать Unlimited-OCR можно через публичный API-эндпоинт. Чтобы получить доступ, необходимо создать аккаунт, пройти верификацию и выпустить токен.
☁️ Если для рабочих задач нужен изолированный сервер, модель можно развернуть на Tesla A2 от 33,74 ₽/ч.
📎 Об особенностях направления запросов по API в модель можно узнать по ссылке.
Post #1320
667



- ❤ 2
- ⚡ 2
- 👍 1
- 🔥 1