
Сравнительный анализ инференса модели openai/gpt-oss-20 на RTX 4090 и H100 NVL
Что важно:
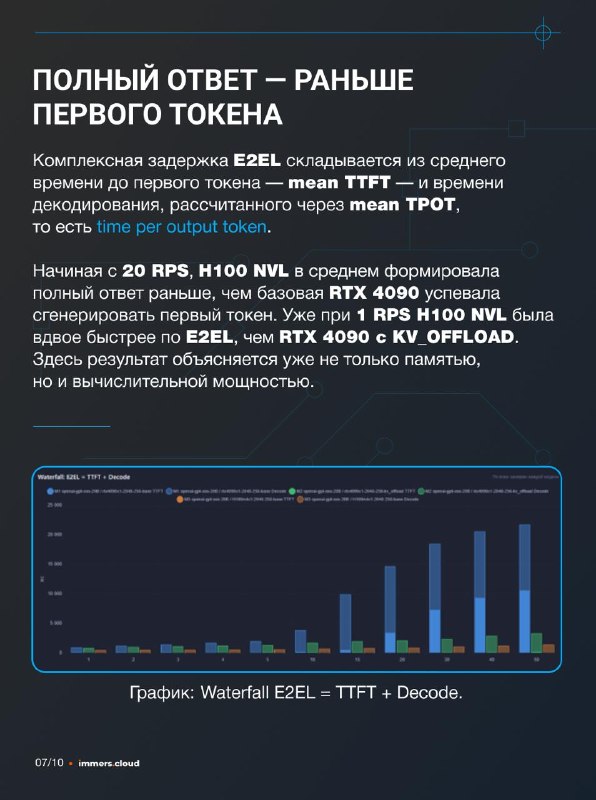
🟠 RTX 4090 достигает предела масштабирования пропускной способности на уровне ~15 RPS. Объема VRAM хватает для одновременного размещения не более двух контекстов максимальной длины (131k токенов) и при одновременной обработке более 200 запросов начинается вытеснение (preemption) данных из KV-кэша (фактически удаление).
Это приводит к необходимости повторного вычисления значений KV для вытесненного запроса с первого токена, что увеличивает показатели TTFT, ITL и E2E latency.
🟠 KV_OFFLOAD снижает негативный эффект вытеснения путем сохранения уже рассчитанных значений для вытесняемых запросов на хосте, но вносит дополнительные задержки из-за передачи данных между GPU и CPU.
🟠 H100 NVL не допускает вытеснения и обеспечивает линейное масштабирование пропускной способности (запросов / сек) с увеличением RPS благодаря четырехкратному преимуществу в объеме доступной памяти под KV-кэш и при этом обладает гораздо более мощными вычислительными возможностями.
▶️ Арендовать сервер с Н100 NVL
📬 Подписывайтесь на нас в МАХ
Post #1377
375




- 👏 3
- ⚡ 2
- ❤ 1
- 🔥 1