TGViewer
Channel Public Channel
iGaming Text Lab - блог про контент в iGaming

iGaming Text Lab - блог про контент в iGaming

@igamingtextlab

Skills, гайды и чек-листы по iGaming-контенту.

Пишем про SEO, AI и локализацию для казино, букмекеров и аффилиатов.

Дарим $40 на тестирование Human-Assisted AI: https://igamingtextlab.com/ru/human-assisted-ai

Связь: @igamingtextbot
Subscribers
804
Photos
328
Videos
55
Links
138

Showing posts older than #567 · Back to latest

Older Posts 12 shown
Post #565 266
Audit в Human-Assisted AI: как проверить, какие требования ИИ действительно выполнил?

В одном из предыдущих постов я рассказывал про Editorial Policy: клиент загружает редполитику, а мы подключаем её к каждому новому проекту.

Только мы уже выяснили, что наличие правил в контексте ещё не означает, что модель соблюдёт каждое из них. Одно требование она может пропустить, другое понять слишком широко, а третьим пожертвовать ради более связного текста.

Когда мы проектировали Human-Assisted AI, я довольно быстро упёрся в практический вопрос: что должен увидеть редактор после генерации?

Абстрактная оценка вроде «качество текста — 65 из 100» здесь бесполезна. Она не объясняет, где находится проблема, почему система снизила балл и что теперь исправлять.

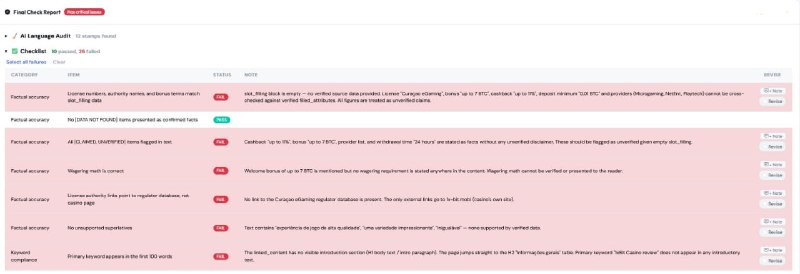
Поэтому мы сделали отдельный Audit, который запускается после генерации и проверяет текст по шести группам маркеров: фактическая точность, соответствие ключам, E-E-A-T, требования конкретного GEO и языка, качество контента и типичные ИИ-паттерны

На выходе редактор получает отчёт с конкретными фрагментами текста. Не просто «есть проблемы со стилем», а, например:

— три последовательных предложения одинаковой длины;
— одно и то же утверждение повторяется в нескольких разделах;
— заявленная лицензия не подтверждается;
— ключ отсутствует в нужной части страницы;
— в тексте для Бразилии используется информация или формулировка для другого рынка.

У каждого пункта есть статус, пояснение и цитата из материала. Редактор сразу видит, что именно не прошло проверку и где находится проблема.

Но Audit всё равно не заменяет человека.

Система может слишком буквально применить правило или выдать false positive. Например, пометить лицензию как неподтверждённую, потому что в собранных данных нет ссылки на реестр регулятора, хотя сама лицензия существует. Возможна и обратная ситуация: несколько вторичных источников повторяют одно и то же устаревшее значение, и автоматическая проверка не видит причины ему не доверять.

В таких случаях оператор возвращается к первоисточнику, проверяет контекст и решает, действительно ли текст нужно исправить.

Контроль человека и Audit закрывают разные участки процесса. Оператор проверяет промежуточные результаты и не даёт ошибке перейти из ресёрча в структуру, а затем в текст. Audit системно прогоняет уже готовый материал по заданным критериям. Финальное решение принимает человек.

Естественность языка, локальные речевые нормы и конструкции, которые формально правильны, но не используются носителями, — уже другой уровень проверки. Для этого подключаем вычитку нейтивами+LQA.

Хотите попробовать Human-Assisted AI на своих задачах? Пишите в бот 👉 @igamingtextbot

Владимир,
Founder iGamingTextLab
  • ❤ 6
  • 🔥 4
  • 🦄 2
  • 🐳 1
Post #564 311
Кстати, по поводу "восстания из пепла ядерного огня" — решила освежить в памяти цитату и посмотреть оригинал.

Однако. Действие первой сцены происходит в 2029 году 🌚

Короче, надо продержаться 3 года до возвращения старого доброго SEO :)

👻 — кнопка для переписи олдов тут
  • 👻 4
  • 😎 3
  • ❤ 1
Post #563 289
А помните старые добрые времена, когда ТЗ можно было верить?

Конечно, бывали разные казусы, но они случались редко, были понятны и решались за пять минут.

А потом появился ИИ. "И восстали машины из пепла ядерного огня, и пошла война на уничтожение нормальных ТЗ" 🤡

Теперь наш обычный рабочий день выглядит так:

— Здравствуйте, присылаю вам ТЗ
— Здравствуйте, принимаем в работу. Постойте, но такого сайта не существует. А ещё вы говорите, что нужно подробно описать раздел «Покер», которого на сайте нет. Хулио Иглесиас почему-то указан как лицо этого казино, хотя это неправда. И лицензия в ТЗ одна, а на сайте регулятора — другая. Можете, пожалуйста, уточнить, о чём нам всё-таки нужно писать?

Мы и раньше перепроверяли факты. Но если раньше клиентское ТЗ обычно можно было использовать как надёжную отправную точку, то теперь сначала приходится проверять уже его. А затем выяснять, что было реальным требованием проекта, а что модель нашла, придумала или перепутала.

В результате огромное количество времени уходит на фактчекинг входных данных и дополнительную коммуникацию с клиентом.

А теперь представьте, сколько таких ТЗ просто уходят в работу без проверки. Ведь не все работают с редакторами/копирайтерами. А ещё представьте, какие тексты по ним получаются.

Вообще, получается любопытный парадокс.

Чем больше неточной информации появляется в интернете, тем больше этой информации попадает в генеренный контент.

А чем больше ее оказывается в генерации, тем важнее становится человеческая проверка. Ведь кто-то же должен писать хорошие тексты с корректными данными и попадать в топы 😎

Алина,
Head of Content iGamingTextLab
  • 🔥 5
  • ✍ 2
  • 🤔 2
Post #559 320
🇷🇸 У iGamingTextLab с Сербией особая связь: здесь живёт значительная часть наших ключевых сотрудников.

И в последнее время мы всё чаще получаем от людей из нашей индустрии вопросы о местном рынке труда: кого нанимать, сколько платить сотрудникам и как перевезти команду.

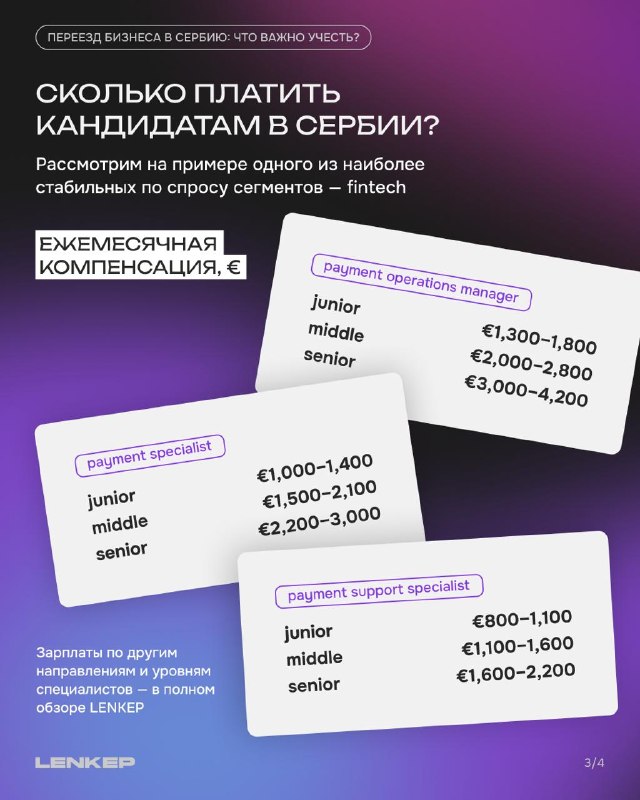
Поэтому на основе обзора LENKEP мы подготовили материал с главными фактами о релокации бизнеса в Сербию.

➡️ Полный обзор «Переезжаем в Сербию. Обзор заработных плат и рынка труда для iGaming, FinTech и Affiliate от LENKEP» можно бесплатно скачать ТУТ.
Переходите и изучайте — внутри много полезных данных и практических рекомендаций.
  • ❤ 5
  • 👍 4
  • 🔥 4
  • 🤡 1
Post #555 349
🔥 Клиенты прислали первые результаты по страницам с контентом от Human-Assisted AI

Самая ранняя тестовая группа поделилась с нами вот такими скринами. GEO: Индия, Греция и Венгрия.

Все проекты на скринах успешно пережили июньский Google Update 🎉

Сейчас у разных клиентов страницы набирают показы, клики и органический трафик. В одном из проектов материалы начали расти практически с нуля, в другом уже принесли 416 кликов при CTR 14,7%.

Причём всё это происходит в период заметной турбулентности поисковой выдачи. Для нас это хороший сигнал, что выбранный подход работает.

Спасибо всем, кто доверился протестировать Human-Assisted AI одним из первых ❤️

Сейчас готовы взять ещё несколько страниц на бесплатный тест.

Пишите 👉
@igamingtextbot
  • 👍 6
  • ❤ 5
  • 🔥 5
  • 🤡 2
Post #554 294

This post (sticker, poll or similar) has no web preview. Open in Telegram

  • 🔥 6
  • 👍 5
  • 🤡 1
Post #553 307

This post (sticker, poll or similar) has no web preview. Open in Telegram

  • ❤ 7
  • 🙏 2
Post #552 293
🔍 Рубрика — FAQ о Human-Assisted AI
Почему мы не даем в открытый доступ наш инструмент, а продаем как услугу?

Отвечает наша любимая Head of Content — Алина, которая стояла у истоков создания инструмента.

Задавайте ещё вопросы в комментариях — на всё постараемся ответить :)
  • 🔥 4
  • ❤ 2
Post #551 339
Как заставить ИИ запоминать правила проекта и не искажать их со временем?

Это был один из первых вопросов, которые мы решали на уровне архитектуры, когда собирали инструмент под наш Human-Assisted AI.

Проблема знакома всем, кто много работает с моделями: и в массмаркетных ИИ, и в кастомных инструментах. Со временем модель начинает трактовать правила проекта по-своему или терять их. А когда требования дорабатываются по ходу, становится хуже: в одном растущем чате самая свежая правка стоит ближе всего к генерации и по факту перевешивает, даже если по важности она второстепенна. Модель читает её как уточнение, а не как дополнение. Новое требование молча продавливает старое, более значимое.

Корень в том, где эти правила живут. Если они лежат в истории переписки, модель каждый раз собирает картину проекта заново из растущего контекста сообщений и достраивает пробелы своим дефолтом (каким — всегда сюрприз). При этом внимание модели распределяется неравномерно: в приоритете начало и конец контекста, а середина проваливается.

То есть правило, брошенное в чат десятым сообщением из шестидесяти, попадет в мёртвую зону. А когда чат становится слишком длинным, история сжимается, и правило не просто теряет вес, а сохраняется лишь в пересказе, тогда как часто нам нужны именно дословные формулировки.

К тому же, часто сами того не замечая, мы даем противоречащие друг другу инструкции. Получается что-то вроде:
"Абзац про лицензию напиши максимально подробно"

а потом где-то добавим:
"Не делай абзацы больше 50 слов"

И еще в каком-нибудь контексте:
"Лицензию напиши в точности, как написано у регулятора"

В итоге у регулятора там будет два слова, и никаких абзацев мы не получим. Либо получим нечто среднее.

Чинить это руками можно ровно одним способом: каждый раз прописывать всё заново, от редполитики до последних правок клиента. Много ручной работы, и при масштабировании такую схему ждёт коллапс. Автоматизацию мы затевали ради обратного.

Поэтому в нашем внутреннем инструменте генерации Редполитика (Editorial Policy) вынесена в отдельный слой.

Ключевая мысль: бриф, ресёрч, голос и правила проекта — это разные типы информации с разным сроком жизни, и держать их в одном промпте ошибочно. Мы разводим их по отдельным полям:

— Brief описывает конкретный материал и живёт один текст;
— Research даёт фактическую базу на сейчас;
— Tone of Voice и персона задают голос;
— Editorial Policy хранит постоянные редакционные правила целого проекта и переживает каждый материал.

По ходу работы требования проекта дополняются. Клиент оставляет новые комментарии, а редактор отделяет разовые замечания от общих и добавляет в Editorial Policy только те правки, которые должны учитываться в следующих материалах.

Так, знания о проекте не остаются внутри отдельного чата. Они хранятся в системе, обновляются по мере работы и заново передаются модели при работе над каждым новым материалом.

На небольшом объёме это избавляет команду от постоянного повторения одних и тех же вводных. На сотнях и тысячах материалов помогает удерживать единые редакционные требования.

Правда, остаётся ещё одна проблема: наличие правила в контексте не гарантирует, что модель его выполнит. О том, как мы проверяем результат, расскажу отдельно.

Кстати, скоро будут первые отзывы по нашему новому сервису:)

Если хотите попробовать бесплатно, набор ещё открыт 👉 @igamingtextbot

Вова,
Founder iGamingTextLab
  • ✍ 4
  • ❤ 2
  • 🔥 2
  • 👏 1
Post #550 265
⬆️ Это я наслушалась советов из Интернета и пытаюсь относиться к ИИ как к джуну-человеку.

Результат — примерно как на видео. Хотя, будем честны, у всех нас поначалу случались именно такие первые рабочие дни.

Но есть одно важное отличие. Мы учимся.

ИИ, конечно, тоже. Но это не отменяет того, что в самый ответственный момент он может забыть важное правило, вернуть запрещённую формулировку или переиначить вводные на свой лад.

Почему так происходит?

Модель не формирует устойчивого понимания проекта, как человек. При каждой генерации она заново собирает задачу из доступного ей контекста: текущего запроса, предыдущих сообщений, примеров и инструкций.

Чем больше всего накапливается, тем сложнее становится эта конструкция. Старые правила соседствуют с новыми правками, общие требования — с замечаниями к одному конкретному тексту. И модель каждый раз заново решает, что из этого важнее и как всё это связано между собой.

Поэтому даже правило, которое вы уже несколько раз обсуждали, может потеряться среди других вводных или получить неожиданную интерпретацию.

В итоге при работе в чатовых моделях контекст приходится регулярно собирать и передавать заново.

Джунам, конечно, тоже иногда нужно что-то повторить. Но всё-таки не в таких масштабах :)

Сталкивались с такой проблемой? Как решали?

Алина,
Head of Content iGamingTextLab
  • 😁 5
  • ❤ 3
  • ⚡ 1
  • 🤝 1
Post #546 290
⚽️ Итоги ЧМ-2026: мы в плюсе!

Уже писала, что наша команда беттинг-авторов активно готовила прогнозы на ЧМ, а мы решили заодно проверить их на виртуальном банкролле. Со временем к ЧМ добавились прогнозы UFC, Формулы-1 и финалов Уимблдона.

Первоначальный виртуальный банкролл — $2000, флэт — 5%, то есть на каждый исход ставили $100. Наша команда выбрала довольно агрессивный подход: коэффициенты от 2 и выше.

Итоговый баланс — $3649 🔥

То есть +82% к первоначальному банкроллу.

Кстати, хотя почти вся команда активно болела за своих фаворитов, собственными советами по ставкам мы не пользовались. Может, зря :)

Но главное во всём этом всё-таки эмоции. Мы получили огромное удовольствие от этого проекта и ещё раз порадовались тому, какая же у нас классная команда под беттинг :)
  • 🔥 6
  • ❤ 3
  • 👏 2
Older posts →
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →