TGViewer
Channel Public Channel
Горизонт сингулярности

Горизонт сингулярности

@horizon_singularity

Горизонт сингулярности — пространство для общения специалистов в сфере ИИ и данных. Обсуждаем модели, пайплайны, алгоритмы, этику и будущее технологий. Без флейма, с уважением к знаниям и опыту друг друга. Учимся, делимся, строим сингулярность вместе.
Subscribers
378
Photos
302
Videos
79
Links
286

Showing posts older than #516 · Back to latest

Older Posts 20 shown
Post #515 206
Дашборд — не украшение для совещания. Это интерфейс принятия решений.

Cloud.ru собрали большое практическое руководство: 10 шаблонов управленческих дашбордов для топ-команды — от генерального и финансового директора до CTO, CIO и CDO.

Внутри не просто примеры графиков, а почти готовый конструктор системы управления:

— какие показатели должен видеть каждый руководитель;
— как рассчитывать метрики;
— как часто обновлять данные;
— какие значения считать тревожными;
— в каком виде лучше показывать результат;
— какое управленческое решение должна поддерживать каждая цифра.

Например, CEO предлагается смотреть не только на выручку и EBITDA, но и на запас денежных средств, концентрацию клиентов, риски и долю дохода от новых продуктов.

CFO получает финансовый радар: денежный поток, дебиторка и кредиторка, стоимость капитала, эффективность CAPEX и валютные риски.

COO — скорость процессов, выполнение SLA, загрузку ресурсов, стоимость операции и уровень автоматизации.

CTO и CIO — доступность систем, частоту сбоев, скорость доставки изменений, технический долг, инфраструктурные расходы и восстановление после аварий.

А CDO — полноту, точность и свежесть данных, lineage, доверие пользователей, использование каталога, drift и качество ML-моделей.

И здесь есть важная мысль: десять независимых дашбордов не создают data-driven компанию.

Настоящая ценность появляется, когда метрики связаны между собой:

маркетинг влияет на продажи,
продукт — на удержание,
операции — на маржинальность,
ИТ — на устойчивость процессов,
а качество данных — на достоверность всех управленческих решений.

Отдельно отмечу здравый подход авторов: приведенные пороги являются референсными. Их нельзя бездумно переносить в любую компанию — значения необходимо адаптировать под отрасль, бизнес-модель и зрелость процессов.

Хорошая основа, чтобы перестать начинать BI-проект с вопроса «какой график нарисовать?» и перейти к более правильному:

«Какое решение должен принять руководитель и какие данные ему для этого нужны?»

Первоисточник: презентация Cloud.ru в первом комментарии.

https://t.me/horizon_singularity

#BI #DataDriven #Дашборды #DecisionIntelligence #DataGovernance #УправлениеДанными
  • 🔥 1
Post #514 248
Токеномика: почему дешёвая модель может оказаться дорогой

Когда компании оценивают стоимость ИИ, обычно смотрят на цену миллиона токенов и стоимость генерации ответа.

Но для ИИ-агентов такая арифметика работает плохо.

Модель не «помнит» предыдущий разговор как человек. При каждом новом запросе ей приходится снова обрабатывать системный промпт, историю диалога, документы, результаты работы инструментов и другие данные, накопленные в контексте.

Поэтому короткое сообщение «продолжай» после часа работы может стоить значительно дороже полноценного запроса в новом чате.

Автор статьи Дмитрий Гуреев проанализировал работу своей агентской системы и получил среднее соотношение:

38 входных токенов на 1 выходной.

То есть для генерации миллиона токенов полезного ответа агенту приходится обработать около 38 миллионов токенов контекста. Это не универсальная константа для всех систем, а результат конкретных измерений, но масштаб проблемы она показывает очень хорошо.

Для предварительной оценки автор предлагает формулу:

реальная стоимость ≈ 38 × цена входа + цена выхода

И здесь рейтинг моделей начинает выглядеть совершенно иначе.

Модель с дешёвой генерацией может оказаться дорогой из-за высокой стоимости обработки входного контекста. А небольшая или локальная модель способна выиграть не качеством финального ответа, а дешёвым «перечитыванием» накопленной информации.

Особенно заметно это в агентских сценариях, где модель выполняет десятки последовательных шагов:

— анализирует документы;
— вызывает инструменты;
— получает результаты;
— корректирует план;
— снова обращается к контексту.

Чем длиннее история, тем дороже становится каждый следующий шаг.

Отсюда несколько практических выводов.

1. Большое контекстное окно не всегда преимущество

Лимит в миллион токенов выглядит впечатляюще, но если агент постоянно переносит весь этот объём между шагами, расходы растут очень быстро.

2. Контекстом нужно управлять

Завершённые этапы стоит суммировать, ненужные документы — выгружать, а данные — подгружать только тогда, когда они действительно нужны.

3. Кэширование становится частью архитектуры

Если системный промпт и начало контекста не меняются, провайдер может не обрабатывать их заново. По приведённым в статье данным, prompt caching способен заметно снизить эффективную стоимость входа. Но кэширование требует стабильной структуры контекста: изменение ранней части истории может привести к повторному расчёту всего последующего блока.

4. Не все задачи требуют фронтирной модели

Рутинные операции, классификацию, извлечение данных и простые преобразования можно передавать компактным или локальным моделям. Более дорогие модели стоит оставлять для этапов, где действительно требуется сложное рассуждение.

5. Считать нужно стоимость результата, а не запроса

Главная метрика — не цена одного ответа, а стоимость выполнения всей бизнес-задачи до приемлемого результата.

Фактически токен становится единицей прямых переменных затрат. Мы можем увидеть, сколько стоит не только инфраструктура в целом, но и конкретный агент, процесс или пользовательский сценарий.

И это уже не просто вопрос выбора модели.

Это вопрос архитектуры памяти, маршрутизации запросов, кэширования, ограничения контекста и распределения задач между моделями.

Главная мысль статьи: в агентских системах мы часто платим не за то, что модель написала, а за то, что она была вынуждена снова прочитать.

Полный материал:
https://nukonechno.ru/i-iisledovaniya/tokenomika-pochemu-my-nepravil-no-schitaem-zatraty-na-ii

https://t.me/horizon_singularity

#ИИ #Токеномика #AIАгенты #LLM #FinOps #АрхитектураИИ
  • 🔥 5
  • 🐳 1
Post #513 241
Попробуйте небольшую игру с ChatGPT: не выбирайте способность самостоятельно, а попросите ИИ проанализировать ваш характер, привычный способ решать задачи и роль, которую вы обычно занимаете среди других людей.

Скопируйте этот запрос:

Представь, что я могу стать героем из вселенной мутантов и получить одну суперспособность.

Сначала задай мне 7 вопросов, чтобы понять:
— как я принимаю решения;
— как веду себя в сложных ситуациях;
— что у меня получается лучше всего;
— какую роль я занимаю в команде;
— что меня раздражает и ограничивает;
— что я хотел бы изменить в мире;
— какую цену готов платить за использование силы.

Задавай вопросы по одному и дождись каждого ответа.

После интервью предложи мне:

одну основную суперспособность;
объяснение, почему она мне подходит;
сценарии её применения;
обязательное ограничение или слабость;
имя героя;
внешний образ и костюм;
девиз героя.

Не предлагай банальные способности случайным образом. Свяжи результат с моими реальными качествами и способом мышления.

У меня получился NEXUS — Архитектор систем.

Его способность — видеть скрытые связи между данными, людьми, процессами, технологиями и решениями. Не просто предсказывать будущее, а перестраивать систему так, чтобы нужный результат становился наиболее вероятным.

А после определения героя можно загрузить свою фотографию и написать:

Используй мою фотографию как основу. Создай кинематографический плакат моего героя. Сохрани узнаваемые черты лица и очки. Покажи суперспособность визуально, добавь имя героя, название способности и девиз. Стиль — реалистичный постер фантастического фильма, без копирования существующих персонажей.

Получается одновременно игра, необычная самодиагностика и способ посмотреть на свои сильные стороны через образ героя.

Какая суперсила получилась у вас? Делитесь именами героев и результатами в комментариях.

https://t.me/horizon_singularity

#ChatGPT #ИИ #Промпты #Супергерой #ГенерацияИзображений #ИскусственныйИнтеллект
  • 🔥 2
  • 😁 1
  • 🐳 1
  • 👾 1
Post #511 180
Неожиданно отметился в декхаузе
Очень приятно !
  • 🔥 1
Post #510 212
Cursor выложил набор скиллов своей команды

Я люблю Cursor и много чего с ним делаю. Для меня это давно уже не просто редактор кода, а полноценная рабочая среда, в которой можно проектировать архитектуру, разбирать проекты, автоматизировать рутину и доводить задачи до результата.

А теперь разработчики Cursor выложили Cursor Team Kit — отличный набор скиллов, основанный на внутренних сценариях работы их собственной команды.

В комплект входят 18 скиллов, 2 субагента и 2 правила для Cursor. Это не абстрактная подборка промптов, а готовые процессы для разработки, проверки и выпуска изменений.

Что есть внутри:

⚡️ контроль CI и автоматическое исправление ошибок;

⚡️ ревью кода, создание коммитов и подготовка Pull Request;

⚡️ проверка веб-интерфейсов, Electron-приложений, CLI и TUI;

⚡️ запуск smoke-тестов через Playwright;

⚡️ разрешение конфликтов при слиянии веток;

⚡️ проверка ошибок компиляции и типов;

⚡️ очистка кода от типичного AI-generated slop;

⚡️ формирование отчётов о выполненной работе;

⚡️ превращение истории чатов в постоянные правила, документацию и новые скиллы.

Особенно понравился workflow-from-chats. Он позволяет проанализировать накопленную работу с Cursor, выделить повторяющиеся предпочтения и превратить их в правила или собственные скиллы.

То есть система постепенно адаптируется не только к вашему проекту, но и к вашему способу работы.

Устанавливается набор прямо из Cursor:

/add-plugin cursor-team-kit

Команда разработчиков отдельно подчёркивает, что Team Kit рассчитан на использование без обязательного подключения сторонних сервисов.

Главная ценность скиллов в том, что они сохраняют не просто знания, а методику выполнения задачи:

что проверить → какие инструменты использовать → как оценить результат → что делать при ошибке → в каком виде выдать итог.

Именно в эту сторону сейчас развивается работа с AI-редакторами: от отдельных запросов к воспроизводимым агентским процессам.

Отличная база, которую можно использовать как есть или разобрать и адаптировать под собственные проекты.

Cursor Team Kit:
https://cursor.com/marketplace/cursor/cursor-team-kit

Исходный код:
https://github.com/cursor/plugins/tree/main/cursor-team-kit

https://t.me/horizon_singularity

#Cursor #AgentSkills #AIAgents #Программирование #Разработка #Автоматизация
  • 👍 3
Post #509 187
🚀 AI WEEKLY | 12–19 июля 2026

Неделя оказалась богата новостями про снятие барьеров: от быстрого запуска моделей и локального инференса до обучения сотрудников работе с ИИ.
Параллельно исследователи уточняют границы агентности - в роботах, симуляциях и самой физической среде.

На этой неделе:

1. Hugging Face и vLLM победили очень неприятную проблему в прошлом - убирают ручной портинг: модели из Transformers теперь получают скорость продакшен-инференса — команды в свою очередь быстрее выводят их в сервисы и снижают затраты на адаптацию.

2. Сбер открывает Speech AI для языков СНГ (богатый набор) и длинных аудиозаписей — это основа для локального распознавания и поиска нужных эпизодов в звонках по таймкодам.

3. Anthropic показывает: в роботах решает не только модель, но и интерфейс управления — LLM разумнее отдавать высокоуровневые задачи, все-таки оставляя движение надежному контроллеру.

4. Kyutai и Epic превратили Rocket League в многопользовательский тест для world model (модель мира) — подход важен для симуляторов и проверки устойчивости агентов в интерактивной среде.

5. PrismML сжимает Bonsai 27B до смартфона: локальный AI выходит из облака — это открывает офлайн-анализ документов и изображений без передачи чувствительных данных в API.

6. Sakana переносит ИИ в материалы: кубики сами распознают форму и повреждения — ранний, но показательный путь к самодиагностике модульных конструкций.

7. METR и университеты показывают: до экономически устойчивого самоулучшения ИИ ещё есть разрыв (детали в статье) — это помогает отделять "прогресс в лаборатории" от готовности к автоматизации R&D.

8. Honda платит за ИИ-навыки: внедрение начинается с измеримой "грамотности сотрудников" — обучение, тестирование и грамотные стимулы помогают вывести ИИ за пределы отдельных энтузиастов.

Мой выбор недели — интеграция Transformers с vLLM: она сокращает самый частый инженерный разрыв между моделью и продакшеном.

🔗 Hugging Face — https://huggingface.co/blog/native-speed-vllm-transformers-backend
🔗 arXiv: GigaAM Multilingual — https://arxiv.org/abs/2607.10371
🔗 Anthropic — https://www.anthropic.com/research/claude-plays-robotics
🔗 MIRA — https://mira-wm.com/
🔗 PrismML — https://prismml.com/news/bonsai-27b
🔗 Sakana AI — https://sakana.ai/smart-cellular-bricks/
🔗 Elasticity.institute — https://elasticity.institute/rsi-paper.pdf
🔗 Nikkei Asia — https://asia.nikkei.com/business/technology/artificial-intelligence/honda-other-japan-companies-pay-workers-to-spearhead-ai-use

#AI #AIWeekly #LLM #AIAgents
  • ❤ 4
Post #508 196
Локальные ИИ-агенты становятся действительно удобными

16 июля LM Studio представила Bionic — отдельное приложение для работы с ИИ-агентами на открытых моделях. Модели можно запускать локально через движок LM Studio, подключать с другого устройства через LM Link или использовать облако для более сложных задач.

Я попробовал Bionic на небольших локальных моделях. Как по мне, это отличное решение для простых, понятных и повторяющихся задач.

Особенно радует нативная работа с рантаймом LM Studio. Не нужно отдельно собирать окружение, настраивать агентский фреймворк, подключать API и разбираться с десятком зависимостей. Выбираете модель, создаёте проект и начинаете работать.

Главное отличие от обычного чата — агент не просто отвечает, а пытается дойти до результата.

Он может исследовать файлы, выполнять последовательность действий, вносить изменения и продолжать работу в рамках проекта, сохраняя его контекст. Это особенно удобно для задач, к которым приходится возвращаться несколько раз.

В Bionic доступны два основных сценария.

Code Project подключается к локальной папке с кодом. Агент может изучать структуру проекта, искать нужные файлы, объяснять код, исправлять ошибки и показывать внесённые изменения в формате inline diff.

Work Project предназначен для работы с документами, PDF, презентациями и таблицами. Файлы обрабатываются в изолированной среде, а автоматические контрольные точки позволяют проверить изменения или откатиться назад. Есть и встроенный веб-поиск для добавления внешнего контекста.

Также появился Voice Keyboard — локальный голосовой ввод на базе модели Voxtral от Mistral. Транскрипция выполняется непосредственно на устройстве, а надиктовывать текст можно практически в любое приложение.

Для тяжёлых задач можно переключиться на открытые модели в LM Studio Secure Cloud. Компания заявляет режим Zero Data Retention: облачные запросы обрабатываются временно и не сохраняются после завершения. Но это уже не локальный режим, поэтому важно понимать, где именно выполняется модель.

Практический совет: если агент начинает забывать инструкции, теряет структуру проекта или не может завершить длинную задачу — увеличьте контекстное окно в настройках модели. При этом учитывайте, что большой контекст потребует больше оперативной или видеопамяти.

Маленькие модели пока не заменят Claude Code или Cursor в сложной разработке. Но для типовых изменений, работы с файлами, подготовки документов, классификации и других регулярных операций локальный агент уже может быть вполне полезен.

На мой взгляд, LM Studio сделал важный шаг: локальные агенты постепенно перестают быть конструктором для энтузиастов и превращаются в нормальный пользовательский инструмент.

LM Studio:
https://lmstudio.ai

Анонс Bionic:
https://lmstudio.ai/blog/introducing-lm-studio-bionic

https://t.me/horizon_singularity

#LMStudio #Bionic #ИИагенты #ЛокальныеМодели #LocalAI #OpenSourceAI
  • 🔥 3
  • ❤ 2
Post #507 201
🚀 OPEN SOURCE AI WEEKLY | 9–16 июля 2026

На этой неделе:

1. Transformer Lab объединяет обучение и кластерные эксперименты в единый open-source control plane — упрощает внедрение внутренних LLM-пайплайнов, централизует эксперименты, модели и вычислительные ресурсы.

2. Destructive Command Guard ставит предохранитель между AI-агентом и опасной командой — помогает безопаснее внедрять coding-агентов в разработку, блокируя рискованные действия в коде, БД и инфраструктуре.

3. Сodex Skill, который превращает продуктовую идею в список первых клиентов — ускоряет поиск ICP, квалификацию лидов и подготовку обоснованных первых касаний для стартапов и продаж.

4. Движок Сolibri обещает запуск сверхкрупных моделей на CPU без Python и GPU — может снизить зависимость от GPU и поддержать приватный локальный inference для отдельных внутренних задач.

5. GhostCommit показывает, как PNG может незаметно направить coding-агента на кражу секретов — даёт командам сценарий для усиления политик доступа, ревью изображений и песочниц.

6. MuScriptor открывает путь от готового трека к редактируемым MIDI-партиям — полезен студиям, музыкальным сервисам и creator-инструментам для аранжировки, ремиксов и подготовки MIDI-контента.

🔗 Transformer Lab — https://github.com/transformerlab/transformerlab-app
🔗 Destructive Command Guard — https://github.com/Dicklesworthstone/destructive_command_guard
🔗 First Customer Finder — https://github.com/Kappaemme-git/codex-first-customer-finder-skill
🔗 Colibri — https://github.com/JustVugg/colibri
🔗 GhostCommit — https://github.com/asset-group/ghostcommit
🔗 MuScriptor — https://github.com/muscriptor/muscriptor

#opensource #AI #AIAgents #GitHub #LLM
  • ❤ 1
  • 🔥 1
Post #506 428
Хотите разобраться, как эффективно пользоваться ИИ-чатами?

Или уже работаете с ChatGPT, Qwen, DeepSeek и другими сервисами, но пока действуете скорее интуитивно?

Пишете запросы методом проб и ошибок, используете один чат для всех задач и не всегда понимаете, почему результат получается слабым?

Тогда начинаем с базы.

Старт программы — Блок 1

«ИИ-инструменты и результативная постановка задач»

Этот семинар поможет уложить в голове основные методы работы с ИИ, закрепить фундамент и перейти от случайных экспериментов к осознанному использованию разных инструментов.

Блок подойдёт тем, кто:

— только начинает работать с ИИ-чатами;
— уже использует их, но хочет делать это эффективнее;
— хочет понять, какой сервис выбирать под конкретную задачу;
— устал бесконечно переписывать промпты;
— хочет получать более точный и предсказуемый результат;
— стремится систематизировать накопленный опыт.

На семинаре разберём

— чем отличаются AI-чаты, поиск, Deep Research и агентные инструменты;
— какие сервисы подходят для текстов, документов, исследований и презентаций;
— как выбирать инструмент под задачу, а не использовать один чат для всего;
— как задавать роль, цель, контекст и исходные данные;
— как формулировать требования и ограничения;
— как управлять форматом ответа;
— как проверять качество результата;
— почему длинный промпт не всегда означает хороший промпт.

Главная задача блока — сформировать понятную рабочую систему:

задача → выбор инструмента → постановка → результат → проверка.

Что изменится после семинара

Вы сможете:

— увереннее пользоваться ИИ-чатами;
— быстрее и точнее формулировать запросы;
— понимать причины слабого ответа;
— осознанно выбирать разные инструменты для разных задач;
— создавать повторяемые шаблоны для своей работы;
— экономить время на уточнениях и переделках.

Когда


15 июля 2026 года
20:30–22:00

Формат — живая Zoom-сессия продолжительностью 90 минут.

Запись и учебные материалы будут доступны в течение одного месяца.

Стоимость


7 000 ₽ — первый блок

Весь курс из трёх блоков — 15 000 ₽.

Условия и оплата:
https://anisimovvp.com

Группа обучения:
https://t.me/+XY0limD3dJlhYWVi

Полный анонс тут:
https://t.me/horizon_singularity/497

Ссылка на группу действует до 18 июля 2026 года.

Начинаем 15 июля с первого блока — с базы, на которой строится вся дальнейшая работа с ИИ.
  • 🔥 2
Post #505 220
🚀AI WEEKLY | 5 июля – 12 июля 2026

На этой неделе:

1. OpenAI выпустила GPT-5.6, GPT-Live и ChatGPT Work. Фокус смещается с отдельных моделей на полноценную рабочую AI-платформу.

2. Anthropic обнаружила внутри Claude структуру J-Space — первый практический шаг к интерпретируемости внутренних рассуждений LLM и мониторингу скрытых намерений моделей.

3. Сразу две новые атаки (GhostCommit и GitLost) показали, что главной целью становятся уже не модели, а AI-агенты. Prompt Injection теперь может быть спрятан даже внутри PNG-файла.

4. Databricks, Hugging Face и Google практически одновременно представили инфраструктуру нового поколения для AI-агентов: оркестрацию, песочницы, observability и инженерную дисциплину. Новый фронтир — не LLM, а AI Harness.

5. Tencent, MiniMax и власти Китая продолжают строить собственную AI-экосистему — от обучения моделей на пользовательском трафике до возможных ограничений экспорта передовых моделей.

6. DoorDash, Thinking Machines и RightNow AI в очередной раз пришли к одному выводу: конкурентное преимущество теперь определяется не выбором модели, а качеством AI Harness — системы оценки, оркестрации и управления агентами.

🔗 GPT-5.6 — https://openai.com/index/gpt-5-6/
🔗 Anthropic J-Space — https://www.anthropic.com/research/global-workspace
🔗 GhostCommit — https://github.com/asset-group/ghostcommit
🔗 Omnigent — https://github.com/omnigent-ai/omnigent
🔗 Hugging Face Sandboxes — https://huggingface.co/docs/huggingface_hub/en/guides/sandbox
🔗 AI Harness (Lilian Weng) — https://lilianweng.github.io/posts/2026-07-04-harness/

#AI #AIWeekly #LLM #AIAgents #OpenAI #Anthropic #EnterpriseAI #AIArchitecture
  • 🔥 1
Post #504 247
Kubernetes без боли: Lens K8S IDE

Мне очень нравится Lens — полноценная IDE для управления Kubernetes-кластерами.

Работа с Kubernetes часто превращается в постоянное переключение между kubectl, терминалом, логами, Grafana, YAML-файлами и десятком открытых вкладок. Lens собирает всё это в одном интерфейсе и позволяет быстрее понять, что происходит внутри кластера.

Что можно делать прямо из IDE:

🔹 подключать несколько кластеров через kubeconfig;
🔹 просматривать pods, deployments, services, nodes и другие ресурсы;
🔹 отслеживать события, логи и метрики в реальном времени;
🔹 открывать shell внутри pod;
🔹 редактировать YAML-манифесты;
🔹 запускать port forwarding;
🔹 работать с Helm-чартами;
🔹 использовать встроенный терминал с контекстом выбранного кластера.

Особенно мне нравится, что Lens не пытается полностью спрятать Kubernetes за красивыми кнопками. Можно визуально разобраться в состоянии кластера, а затем сразу перейти к терминалу и привычному kubectl.

Отдельный интерес представляет Lens Prism — встроенный ИИ-ассистент. Он учитывает контекст кластера, помогает диагностировать проблемы и объясняет происходящее обычным языком.

Для корпоративного использования тоже есть важный плюс: Lens работает на компьютере пользователя, подключается через стандартный kubeconfig и учитывает существующие ограничения RBAC. Для базовой работы не требуется устанавливать в кластер отдельного привилегированного агента.

На мой взгляд, это один из лучших инструментов для разработчиков, DevOps- и SRE-инженеров, которым нужно не просто смотреть на дашборды, а действительно управлять Kubernetes.

kubectl Lens, конечно, не заменяет. Но количество ситуаций, когда приходится вспоминать длинную команду или вручную искать нужный ресурс, сокращает очень заметно.

Смотреть и тестировать:
https://lenshq.io/products/lens-k8s-ide

Больше материалов про ИИ, данные и цифровую инфраструктуру — в канале «Горизонт Сингулярности»:
https://t.me/horizon_singularity
  • 🔥 2
  • 🥰 1
Post #503 230
🚀 AI WEEKLY | 28 июня – 5 июля 2026

На этой неделе:

1. Alibaba запретила Claude Code после обнаружения скрытого механизма идентификации китайских пользователей
2. Palantir призвал компании отказаться от зависимости от облачных API крупных компаний/лабораторий
3. Huawei продолжает строить полностью независимый стек ИИ — от чипов Ascend до собственных моделей OpenPangu.

Важная тенденция, которая набирает обороты — обучении агентов прямо в процессе работы.

4. ByteDance показала, что агент способен улучшать свои навыки непосредственно во время эксплуатации
5. Thinking Machines и Bridgewater доказали, что качественно размеченная корпоративная экспертная база позволяет небольшой специализированной модели превосходить GPT и Claude в профессиональных задачах.
6. NVIDIA и Palantir представили инфраструктуру, где открытые модели непрерывно адаптируются на данных организации внутри изолированного контура.
7. Вместе с этим Anthropic выпустила Sonnet 5, сделав основной акцент уже не на бенчмарках, а на надежной работе ИИ-агентов с инструментами и длинными процессами.

🔗 Alibaba vs Claude Code — https://www.reuters.com/world/china/alibaba-ban-claude-code-workplace-over-alleged-backdoor-risks-source-says-2026-07-03/
🔗 Palantir × NVIDIA Sovereign AI OS — https://www.palantir.com/sovereignaios/
🔗 Thinking Machines × Bridgewater — https://vc.ru/ai/3010277-miry-murati-ii-bridgewater-uluchshaet-finansovuyu-analitiku
🔗 Claude Sonnet 5 — https://www.anthropic.com/news/claude-sonnet-5
🔗 EdgeBench (ByteDance) — https://github.com/ByteDance-Seed/EdgeBench
🔗 Google TabFM — https://research.google/blog/introducing-tabfm-a-zero-shot-foundation-model-for-tabular-data/
🔗 Huawei OpenPangu 2.0 Flash — https://huggingface.co/openpangu/openPangu-2.0-Flash

#AI #AIWeekly #LLM #AIAgents #Anthropic #Huawei #Palantir #OpenPangu #EnterpriseAI #SovereignAI
  • 🔥 5
Post #502 210
Фундамент ИИ трансформации.pdf5.5 MB
Неожиданно зрелый подход к внедрению ИИ в государственном управлении: в Липецкой области замминистры пишут код, а боты следят за ЖКХ

Когда слышишь "ИИ в госуправлении", обычно ожидаешь очередной чат-бот с ответом "Ваше обращение очень важно для нас" 😁

А тут заместители министров сами собирают ИИ-агентов в n8n (по крайней мере - так оно на картинке).

Показывают, что бот анализирует 3600 домовых чатов. OCR с LLM разбирает распоряжения Правительства, а документы автоматически получают саммари.

Пожалуй, самый неожиданный слайд в презентации — не про LLM и даже не про агентов.
А про то, что сначала нашли 3200 процессов, сделали аудит, 165 вообще решили убрать, а уже потом начали внедрять.

Неожиданно практичный подход.
  • 🔥 7
  • 🥰 1
Post #501 213
Мало подключить LLM. Ей ещё нужен харнес

Когда мы говорим об AI-агентах, чаще всего обсуждаем модели: Claude, GPT, Gemini или Qwen. Но модель — это только «мозг» системы.

Чтобы этот мозг мог выполнять реальные задачи, ему нужен харнес.

Харнес — это программная оболочка вокруг языковой модели, которая связывает её с инструментами, памятью, данными и средой выполнения.

Если совсем просто:

LLM решает, что нужно сделать.
Харнес обеспечивает, как именно это будет сделано.

Само слово harness можно перевести как «обвязка», «упряжь» или «система управления». В AI-разработке харнес превращает языковую модель в полноценного работающего агента.

Модель может решить, что ей необходимо:

— найти информацию;
— открыть документ;
— изменить код;
— выполнить команду;
— обратиться к базе данных;
— вызвать другой инструмент или агента;
— проверить полученный результат.

Но сама по себе LLM не выполняет эти действия — она только формирует текст и инструкции.

Именно харнес:

— подключает инструменты и MCP-серверы;
— передаёт модели необходимый контекст;
— управляет памятью и сессиями;
— запускает команды и программный код;
— организует цикл «подумал → сделал → проверил»;
— обрабатывает ошибки и повторные попытки;
— ограничивает права доступа;
— запускает действия в изолированной среде;
— координирует работу нескольких агентов;
— сохраняет состояние длительных задач.

Поэтому два агента на одной и той же модели могут показывать совершенно разные результаты.

Модель определяет интеллект агента.
Харнес определяет его реальные возможности и надёжность.

Для погружения в тему можно изучить открытый Harness Engineering Guide.

Это практическое руководство по разработке исполнительных сред для AI-агентов: от простого харнеса на нескольких десятках строк Python до контекстной инженерии, памяти, guardrails, Docker-песочниц, навыков, субагентов и долгоживущих агентных процессов.

https://github.com/nexu-io/harness-engineering-guide

Но создать харнес недостаточно. Нужно ещё проверить, насколько хорошо он работает.

Для этого команда Red Mad Robot R&D выпустила Harness Bench — открытый фреймворк для тестирования и сравнения агентных сред.

Он позволяет запускать разные харнесы на одинаковых задачах, оценивать результаты, сохранять историю прогонов и сравнивать конфигурации.

В проекте предусмотрены проверки:

— фактической точности;
— вызова функций и инструментов;
— генерации и исправления кода;
— долговременной памяти;
— поиска информации в большом контексте;
— решения GitHub Issues;
— выполнения прикладных корпоративных задач.

https://github.com/redmadrobot-rnd/harness-bench

Это важный сдвиг в развитии AI-агентов.

Мы постепенно переходим от вопроса:

«Какую модель выбрать?»

к более зрелым вопросам:

«В каком харнесе эта модель будет работать?»
«Как агент использует память и инструменты?»
«Как мы проверим результат и можем ли доверить ему реальные действия?»

Вполне возможно, что именно Harness Engineering станет следующим большим направлением после prompt engineering и context engineering.

Больше материалов об AI-агентах, локальных моделях и новой архитектуре ИИ — в канале «Горизонт сингулярности»:

https://t.me/horizon_singularity
  • 🔥 3
Post #500 170
ИИ заговорил как пещерный человек — и сократил расход токенов на 65%

Caveman — бесплатный навык для ИИ-агентов, который заставляет модель отвечать предельно кратко: без приветствий, повторов, лишних объяснений и словесного шума.

Мозг остаётся большим. Речь становится короче.

Как это выглядит на практике

Было:

«Для того чтобы снизить расходы на использование языковой модели, рекомендуется обратить внимание на объём генерируемых ответов. Чем больше текста создаёт модель, тем больше токенов расходуется, что приводит к увеличению стоимости каждого запроса. Поэтому стоит формулировать инструкции так, чтобы модель отвечала кратко и не добавляла лишних пояснений».

Стало:

«Короткие ответы расходуют меньше токенов и снижают стоимость запросов. Уберите повторения и лишние пояснения».

Смысл сохранился. Текста стало в несколько раз меньше.

Что умеет Caveman:

🕤 сокращает объём ответов в среднем на 65%, а в отдельных тестах — до 87%;

🕤 поддерживает Claude Code, Codex, Gemini, Cursor, Windsurf, Cline, Copilot и другие инструменты;

🕤 предлагает несколько режимов сжатия: lite, full и телеграфный ultra;

🕤 сохраняет команды, код, пути, сообщения об ошибках и язык пользователя;

🕤 умеет сжимать файлы памяти и проектные инструкции;

🕤 показывает статистику сэкономленных токенов и их стоимость.

Важно: Caveman не делает модель менее умной и не сокращает её внутренние рассуждения. Он оптимизирует прежде всего то, что агент пишет пользователю.

Результат:

— ниже стоимость запросов;
— быстрее ответы;
— меньше расход контекста;
— больше полезной информации на один токен.

Простая, но практичная идея: не делать ИИ менее умным — научить его говорить только по делу.

https://github.com/juliusbrussee/caveman

Горизонт Сингулярности
@horizon_singularity
  • 👍 5
  • 🥰 1
Post #499 213
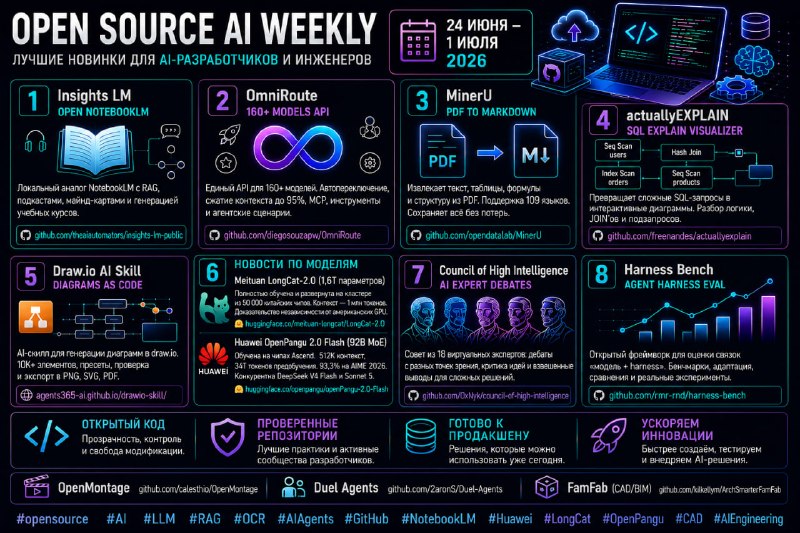
🚀 OPEN SOURCE AI WEEKLY | 24 июня – 1 июля 2026

На этой неделе open source развивается сразу в двух направлениях. С одной стороны, появляются полноценные AI Workspace: локальный аналог NotebookLM с поиском по знаниям, подкастами, майнд-картами и генерацией учебных курсов, OmniRoute объединяет более 160 моделей через единый API, а MinerU становится одним из лучших инструментов извлечения структуры из PDF и научных документов.

С другой стороны, все интереснее становится рынок открытых моделей. Meituan представила LongCat-2.0 (1,6T параметров), полностью обученную и развернутую на китайской вычислительной инфраструктуре без использования американских GPU. Huawei выпустила OpenPangu 2.0 Flash (92B MoE), обученную на Ascend и приблизившуюся по ряду агентных задач к современным frontier-моделям. Это уже не просто очередные open-source релизы, а сигнал того, что Китай строит полностью независимую экосистему — от AI-чипов до собственных больших моделей.

Для инженеров также вышло несколько сильных инструментов: actuallyEXPLAIN визуализирует сложные SQL-запросы, AI Skill для draw.io автоматически строит архитектурные диаграммы, Council of High Intelligence превращает LLM в совет виртуальных экспертов, Harness Bench позволяет объективно сравнивать не только модели, но и агентские harness, а FamFab показывает, как генеративный ИИ приходит в CAD/BIM.

🔗 LongCat-2.0 — https://huggingface.co/meituan-longcat/LongCat-2.0
🔗 OpenPangu 2.0 Flash — https://huggingface.co/openpangu/openPangu-2.0-Flash/blob/main/README_EN.md
🔗 Insights LM (Open NotebookLM) — https://github.com/theaiautomators/insights-lm-public
🔗 actuallyEXPLAIN — https://github.com/freenandes/actuallyexplain
🔗 Draw.io AI Skill — https://agents365-ai.github.io/drawio-skill/
🔗 OmniRoute — https://github.com/diegosouzapw/OmniRoute
🔗 Council of High Intelligence — https://github.com/0xNyk/council-of-high-intelligence
🔗 MinerU — https://github.com/opendatalab/MinerU
🔗 OpenMontage — https://github.com/calesthio/OpenMontage
🔗 Duel Agents — https://github.com/2aronS/Duel-Agents
🔗 Harness Bench — https://github.com/rmr-rnd/harness-bench
🔗 FamFab — https://github.com/kilkellym/ArchSmarterFamFab/releases/tag/v1.0

#opensource #AI #LLM #OpenSourceAI #GitHub #NotebookLM #AIAgents #Huawei #LongCat #OpenPangu #OCR #CAD
  • 🔥 2
  • 🥰 1
Post #497 325
Меня давно просили сделать небольшой практический курс про ИИ.

Про меня тут https://Anisimovvp.pro

Прошу любить и жаловать!

От промпта к управляемому ИИ-агенту

Три вечерних Zoom-семинара, на которых мы пройдём путь от выбора подходящего ИИ-инструмента до проектирования управляемого AI-агента.

Без программирования.
На примере реальных рабочих задач.

Блок 1. ИИ-инструменты и результативная постановка задач

15 июля, 20:30–22:00

— выбор ИИ-инструмента под задачу;
— сильный промпт;
— контекст, данные и ограничения;
— критерии качества и проверка результата.

Результат: рабочий промпт, шаблон задачи и чек-лист проверки.

Блок 2. ChatGPT как виртуальный компьютер

22 июля, 20:30–22:00

— работа с файлами, браузером и сервисами;
— отличие агента от обычного чата;
— Markdown для инструкций;
— JSON для структуры данных;
— Mermaid для схем процессов.

Результат: инструкция, JSON-контракт и схема собственного AI-процесса.

Блок 3. Decision Intelligence и управляемая автономия

29 июля, 20:30–22:00

— какие решения можно делегировать ИИ;
— уровни автономности агента;
— ограничения и правила эскалации;
— Human-in-the-loop;
— контроль, аудит и безопасный пилот.

Результат: модель делегирования, правила контроля и план запуска AI-агента.

Формат

— три Zoom-сессии по 90 минут;
— встречи по средам с интервалом в неделю;
— записи и материалы доступны один месяц;
— все организационные детали — в закрытой Telegram-группе.

Стоимость

7 000 ₽ — один блок

15 000 ₽ — весь курс

При покупке трёх блоков отдельно стоимость составит 21 000 ₽. Экономия за полный курс — 6 000 ₽.

Условия, оплата и
Программа тут

https://anisimovvp.com

Группа обучения

https://t.me/+XY0limD3dJlhYWVi

Ссылка на группу действует до 18 июля 2026 года.

Старт курса — 15 июля 2026 года.

Перестаньте просто задавать ИИ вопросы.

Начните управлять цифровым исполнителем.
  • 🔥 7
  • 👍 2
  • 🐳 1
Post #496 239
Китайцы отключили цензуру в модели на базе Fable 5

Команда Huihui AI выпустила Huihui Gemma 4 12B Coder Fable 5 Abliterated — локальную нейросеть с максимально ослабленными механизмами отказа.

Важно: это не оригинальная Fable 5, а модель на базе Gemma 4 12B, дополнительно обученная на решениях и цепочках рассуждений Fable 5 и Composer 2.5.

После обучения разработчики применили технологию abliteration — вмешательство во внутренние механизмы модели, отвечающие за отказы и ограничения.

Доступны две версии модели:

— стандартная версия с исходными механизмами безопасности;

— abliterated-версия, в которой механизмы отказа и ограничения максимально ослаблены.

Что внутри:

— отвечает на значительно более широкий круг запросов по сравнению со многими популярными ИИ;

— специализируется на программировании, алгоритмах и сложных технических задачах;

— работает полностью локально, без обязательной отправки данных на внешние серверы;

— поддерживает большой контекст и работу с крупными массивами кода;

— может запускаться через Transformers, vLLM, llama.cpp, Ollama и LM Studio;

— доступна в нескольких форматах и квантизациях под разное оборудование.

Фактически разработчики взяли открытую модель, передали ей часть подходов Fable 5 к решению задач, а затем выпустили отдельную версию с максимально ослабленными ограничениями.

Но есть и обратная сторона.

Модель может выдавать ошибочные, небезопасные или спорные ответы. Поэтому контроль результатов, настройка среды и ответственность за использование полностью остаются на пользователе.

Предохранители отключили. Ответственность оставили человеку.

https://huggingface.co/huihui-ai/Huihui-gemma-4-12B-coder-fable5-composer2.5-v1-abliterated
  • ❤ 1
Older posts →
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →