TGViewer
Channel Public Channel
Градиентное погружение

Градиентное погружение

@gradientdip

Обсуждаем новости, рассказываем про ML с кодом и колабом, выигрываем соревы 🏆

Контакты: @Cene655, @Cucu_LaPraline
Subscribers
4.2K
Photos
179
Videos
11
Links
163

Showing posts older than #202 · Back to latest

Older Posts 11 shown
Post #201 2.6K

Forwarded from Градиент обреченный

#nlp #colab

⭐️ Сделал простой colab с визуализацией мультиязычного пословного выравнивания.

Выравнивание происходит при помощи mBERT эмбеддингов. Авторы статьи дообучили его на дополнительных задачах (objectives), чтобы улучшить качество (parallel sentence identification, consistency optimization, etc.).

В GitHub'е есть скрипты для дообучения на своем параллельном корпусе, так что можно расширить под ваш язык (в изначальном mBERT'е было 100+ языков).

Визуализацию сделал на graphviz.

👉 Colab | GitHub | Huggingface
  • 👍 22
  • ❤ 2
Post #190 5.2K
1. A yellow book and a red vase.
2. Hovering cow abducting aliens.
3. One cat and one dog sitting on the grass.
4. A black apple and a green backpack.
5. A banana on the left of an apple.
6. A sign that says 'Deep Learning'.
7. A wine glass on top of a dog.
8. A small blue book sitting on a large red book.
9. A brown bird and blue bear.
10. A panda making latte art.

Новая top1 text2image модель не может сгенерировать большую часть drawbench
  • 😁 15
  • 👍 4
  • 😢 4
  • 🔥 2
  • 🎉 2
  • 👎 1
Post #189 1.92K
stable diffusion
  • 😁 21
  • 👍 1
Post #188 2.01K
tqdm-joblib

Любите прогресс бары? А многопоточный парсинг?

joblib - хорошая библиотека для удобной работы с многопроцессорностью, а также кешированием в питоне.

joblib.Parallel позволяет в пару действий запустить парсер, но при этом предоставляет ограниченный вывод информации о состоянии процесса.

Так вот, ребята со stackoverflow написали костыль, который в 2 клика делает более удобный вывод, формата обычного tqdm. Причем tqdm-telegram тоже работает 👀.

Все что нужно:
pip install tqdm_joblib

Нужная в хозяйстве вещь.

stackoverflow
  • 👍 28
  • 🔥 2
Post #185 3.53K
Про текстовые аугментации

Нашел классную статейку, в которой автор разобрал и визуализировал методы аугментаций текста, начиная от тех, что базируются на TF-IDF, заканчивая генерацией нейронками.

Лично для себя подчеркнул wordMixup и Instance Crossover Augmentation, думаю вам тоже понравится.

Статья 🔥
NLP AUG [полезное]
TextAttack [полезное]
Amit Chaudhary A Visual Survey of Data Augmentation in NLP An extensive overview of text data augmentation techniques for Natural Language Processing
  • 🔥 22
  • 👍 5
Post #184 2.51K

Forwarded from schizo machine learning 🎹🔫🤡 (accelotron)

pull.gif17.9 MB
🔥MineDojo🔥
NVIDIA выпустила фреймворк для создания автономных агентов, которые могут играть в Minecraft, обучаясь на видео, текстах с вики и реддита.

Кроме того, команда MineDojo выложила свои датасеты:
- YouTube Database, на ~300 тысяч часов видео по майнкрафту, видео содержат английские субтитры.
- Wiki Database, ~7 тысяч страниц.
- Reddit Database, более 340 тысяч постов.

Страница проекта
  • 👍 22
  • 🔥 8
Post #183 2.82K
BetterTransformer

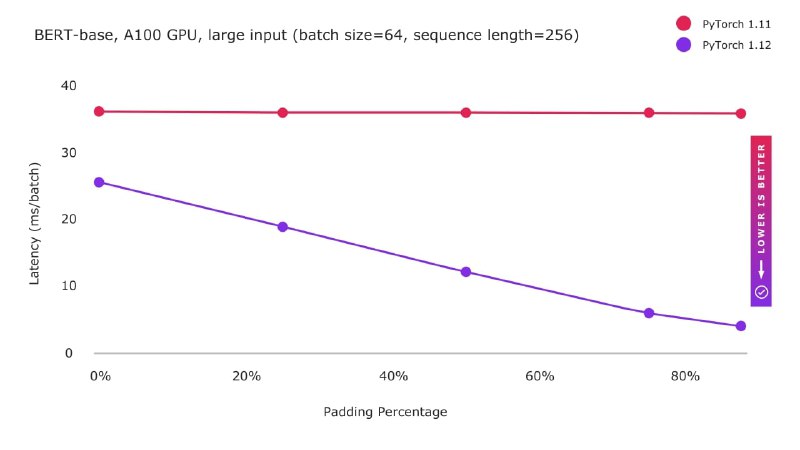
🔥 Ускорение инференса трансформеров в 2 раза из коробки

Совсем недавно PyTorch получил обновление 1.12, нам завезли nested tensors, способные хранить в себе тензоры разного размера и через некотрое время после этого представили их использование в TransformerEncoder, а также MultiHeadAttention.

Разработчики интегрировали их в TorchText, причем для использования новой фичи не нужно переучивать или переделывать модели, достаточно указать один (!) параметр - enable_nested_tensor.

Фича работает как на GPU, так и на CPU.

В будущем добавят: TransformerDecoder для работы Seq2Seq моделей, использование новых тензоров для обучения и интеграцию в HuggingFace (!).

Кст, есть вроде как рабочий PR от разработчика из команды PyTorch в котором реализована работа для BERTа в HF.

@gradientdip

Блогпост
Колаб
Туториал
Issue
Pull Request
Nested Tensors
  • 👍 28
  • 🔥 6
  • 😱 2
Post #182 2.06K
Про изменение языка

Не секрет, что мы стремимся к упрощению и автоматизации. Причем не только бизнес процессов, но и нашей речи.

Во многом это происходит из-за интернета: мы сами не замечаем как в наш обиход врываются заимствования, сокращения, мемы.

Это не хорошо и не плохо, это естественный процесс, ведь общество развивает язык (хотя и физиологические особенности надо учитывать).

Отражение этого можно увидеть и в данных. В чатах - короткие сообщения, а в разговорах по телефону: "да", "нет", "не знаю".

По сути это естественный датадрифт, который, вероятно, больше всего заметен в машинном переводе. Там и так есть свои проблемы с разными трактовками одной и той же фразы, а тут ещё и это.

Быть может старые модели вовсе не так плохи как кажутся?

Быть может результаты, что есть сейчас некорректно сравнивать и нужно переобучать каждую модель?

Быть может новые архитектуры просто учатся на "свежих" наборах и становятся SOTA?

Или же проблема немножко в другом? В том что данные подвергаются "временной коррозии" (устаревание слов, изменение конструкций текстов, тренды)?

Очень интересно узнать, что вы думаете про изменение языка в контексте нынешнего NLP.

И что думают Kali Novskaya, DL in NLP
Telegram Kali Novskaya Нейросети, искусство, мысли. Поехали! Разрабатываю LLM и веду команды chatGPT, GPT-3, GPT-4
  • 👍 11
  • 🤔 3
Post #181 1.49K

Forwarded from Время Валеры

Мой близкий друг Саша Сахнов - человек который на мой взгляд лучше всех разбирается в а/б тестах

Еще в далеком 2018 году мы с ним и рядом других людей начали писать на Хабр про А/Б.
Сейчас он запустил цикл статей про А/Б, где каждая статья будет сложнее предыдущей - первая довольно базовая статья про Бутстрап (Обратите внимание на центральный доверительный интервал)

Еще интересен небольшой разбор стратификации для повышения чувствительности тестов
Еще можно посмотреть это видео
  • 👍 15
  • 👎 1
Older posts →
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →