
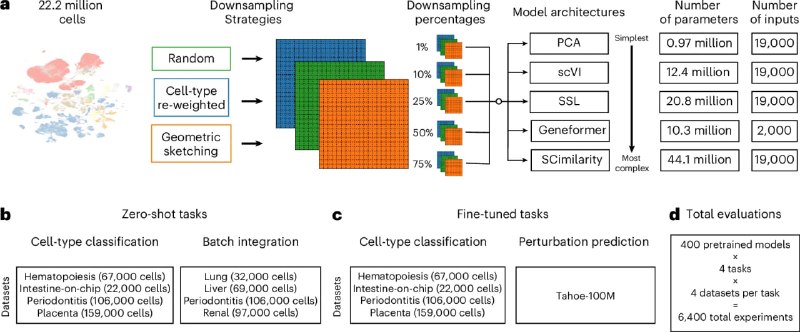
Вкратце, статья показывает, что с увеличением размера и сложности модели, а также при увеличении количества данных для обучения, качество решения задач single-cell транскриптомики практически не меняется. И довольно большие модели работают не намного лучше простых методов вроде метода главных компонент.
Этот результат вызывал много критики по отношению к создателям больших моделей от корифеев области - Sasha Gusev, Anshul Kundaje и других. Очевидно, что нам нужны новые архитектуры, режимы тренировки и, возможно, данные (хотя лично я считаю, что данных достаточно).
Но я уверен, что решать задачи геномики при помощи AI возможно - и тот, кто придумает это решение, совершит огромные прорыв. Цитирую пост Anshul Kundaje
On the other hand, if u provide a model that consistently delivers what it promises, everyone will keep their mouths shut & happily use it. Quite easy to make the case. The model should be able to speak for itself.