
Post #698
1.06K
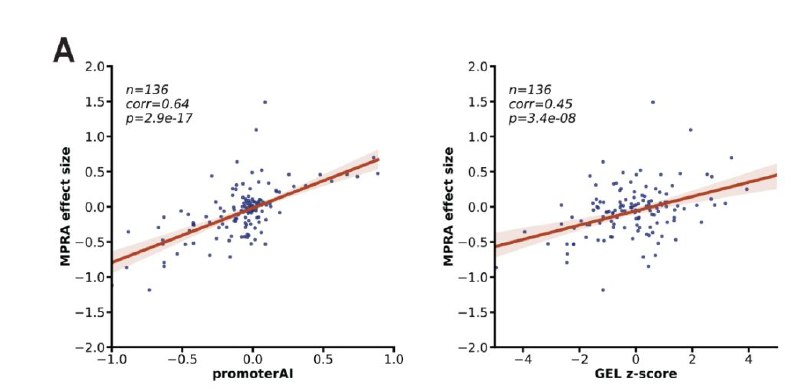
Во-первых, результаты модели лучше коррелируют с экспериментальными данными по анализу транскрипции, чем MPRA-эксперимент, в котором тестируют те же варианты. В какой-то степени это объяснимо, потому что модель видит большой регион вокруг старта транскрипции, а в MPRA - только 200 букв в чужом контексте. Ну очень круто что модели добрались до такого качества, что их предсказания более точные, чем не очень 'удачный' эксперимент
- 🔥 5
- 👀 5
- 👎 1