TGViewer
Channel Public Channel
Практики FinOps

Практики FinOps

@finops_ru

Сообщество для тех, кто хочет понимать и контролировать затраты на ИТ-инфраструктуру. Разбираем FinOps, аллокации, оптимизацию, кейсы, подкасты и опыт команд.


Стать участником комьюнити: https://finopshub.ru/
По вопросам: @finops_admin
Subscribers
569
Photos
335
Videos
36
Links
241
Recent Posts 15 shown
Post #476 220
⚡️ FinOps по фасттреку: как снизить облачные расходы и не сломать сервис

В идеальном мире компания спокойно проходит весь цикл FinOps: Inform, Optimize, Operate, выстраивает роли, процессы, отчётность и регулярную работу с затратами.

В реальности запрос часто звучит проще: «мы много платим за облако, помогите быстро понять, где можно снизить расходы».

⚪️ В новом выпуске поговорили с Вячеславом Бессоновым, генеральным директором Hilbert Team.

Разобрали, как работает FinOps по фасттреку: с чего начинать, если бизнесу нужен quick win, почему биллинга провайдера обычно недостаточно, как проверять гипотезы оптимизации и когда экономия превращается в полноценный IT-проект


Темы выпуска:
🟥 почему FinOps в России часто начинается с запроса «порезать косты»
🟥 зачем считать ROI оптимизации, если нужно менять архитектуру
🟥 когда можно получить быстрые 5–10%, а когда 20–30% требуют отдельного проекта
🟥 почему нельзя просто срезать ресурсы без проверки влияния на сервис
🟥 как работают резервы и бронирование ресурсов
🟥 почему теги всё ещё скорее исключение, чем правило
🟥 как делить общую инфраструктуру между продуктами
🟥 что меняется в FinOps из-за гибридной инфраструктуры, workload first и AI-токенов

Смотреть выпуск:
🎞 YouTube
📺 Rutube
📺 VK Видео

Слушать выпуск:
💬 Telegram Player (Mave)
🎵 Яндекс. Музыка
🎵 VK Музыка

💬 Практики FinOps
  • 👾 4
Post #475 199
🟩«Раз, два, три, четыре, пять — вышел зайчик посчитать»

А как посчитал косты — прослезился.

Потому что в биллинге редко лежит аккуратная правда. Чаще там набор загадок: чья это виртуалка, почему выключенная ВМ все еще стоит денег, кто оставил снапшоты двухлетней давности и почему dev внезапно живет как production.

Во второй статье FinOps-цикла разбираем ручной пилот: биллинг на уровне ресурсов, разметку owner / project / environment, зомби-диски, старые снапшоты, dev/test как production и ловушку «нашли потенциал, но это еще не экономия».

FinOps-пилот заканчивается не отчетом. Отчет можно показать и забыть. А чтобы деньги не расползлись обратно через пару месяцев, нужны правила: кто владеет ресурсом, что можно трогать, как проверять эффект и что делать с инфраструктурой без владельца.


Читать продолжение на Хабр

💬 Практики FinOps
  • 👾 5
Post #474 196
🟢 Какая часть облачного счета уже управляется?

Разбираем метрику, которая показывает, какая часть облачных затрат уже привязана к понятному владельцу: команде, продукту, сервису, проекту или ЦФО.

Формула:

Покрытие аллокации = затраты с назначенным владельцем / общие облачные затраты × 100%


Если показатель низкий, часть счета остается в серой зоне. Финансы видят расход, но не могут точно объяснить, кто его создал. Инженеры видят ресурсы, но не всегда понимают, как они легли в бюджет.

Что попадает в числитель:
🟥ресурсы с корректными тегами владельца, продукта, среды или приложения
🟥аккаунты, проекты и подписки, привязанные к бизнес-юниту или ЦФО
🟥общие сервисы, распределенные по согласованному правилу
🟥затраты, связанные с владельцем через CMDB, каталог сервисов или внутреннюю модель аллокации

Важно считать показатель на одной базе затрат.

Если используете Amortized Cost, значит и распределенные, и общие затраты считаются в Amortized. Если компания работает в Net-Net с учетом договорных скидок, покрытие тоже нужно считать в этой логике.

Зачем это нужно:
🟥видно, какая часть счета уже управляется
🟥проще найти неразмеченные ресурсы и общие расходы без правил
🟥появляется база для showback, chargeback и продуктовой экономики
🟥команды начинают видеть не абстрактный облачный счет, а свои реальные затраты

На этапе Crawl не нужно сразу идеально распределять каждый рубль. Сначала важно закрыть самые крупные и управляемые блоки: аккаунты, проекты, дорогие окружения, общие платформы и ресурсы с высокой долей расходов.

Главный принцип простой: сначала понять, кто потребляет ресурс и по какому правилу расход попадает в модель. Только потом можно говорить о зрелой оптимизации.


Источник: FinOps Foundation, Allocation

#FinOps_Inform #FinOps_Crawl
  • 👾 3
Post #473 181
🟥 FOCUS: когда AI-затраты перестают быть набором несвязанных счетов

Классические облачные ресурсы компании уже научились считать: инстансы, диски, сеть, базы данных, контейнеры.

С AI-инфраструктурой сложнее. Расходы складываются из разных слоев: API-вызовы, токены, GPU, векторные базы, оркестрация, хранение данных и сетевой трафик.

Для российского рынка это особенно заметно в гибридных сценариях


Часть нагрузки может жить в публичном облаке. Часть, на своем железе или в ЦОДе. Часть, у внешнего LLM-провайдера. Отдельно появляются GPU-инстансы, управляемые Kubernetes-кластеры, объектное хранилище, сетевой трафик и SaaS-сервисы.

Финансовая команда получает несколько отчетов с разной детализацией и разными правилами учета. В одном месте видны часы работы GPU, в другом, токены, в третьем, инфраструктура под хранение и обработку данных.

В итоге понятно, что деньги потрачены. Но сложнее ответить на управленческие вопросы:

🟥какой AI-сценарий потребляет больше всего ресурсов
🟥где расход связан с продуктом, а где с экспериментом
🟥что дешевле в конкретном случае: внешний API или собственная инфраструктура
🟥кто владелец затрат и по какому драйверу их распределять

Здесь появляется FOCUS, FinOps Open Cost and Usage Specification.

Это не платформа оптимизации и не готовый дашборд, а открытая спецификация, которая приводит cost and usage данные к единому формату


Что это дает на практике:

🟥 единый язык для разных источников затрат
Можно сопоставлять расходы по облаку, AI-сервисам, SaaS и data center в одной структуре данных.
🟥базу для аллокации
Проще связать расход с командой, продуктом, сервисом или средой, если данные приведены к общей модели.
🟥меньше ручной склейки
Финансовой и инженерной команде не нужно каждый раз заново разбирать, как называется один и тот же тип расхода у разных поставщиков.
🟥основу для мониторинга
FOCUS сам по себе не ловит cost-спайки. Но без нормализованных данных сложно построить надежные правила, витрины и алерты.

Главная ценность FOCUS в том, что он убирает часть технического шума из биллинга


Команда начинает обсуждать не то, как склеить очередной отчет, а что именно потребляет ресурсы, кто за это отвечает и как меняется экономика AI-сценария.

Если AI-затраты сейчас сводятся вручную в таблицах, первый вопрос не про оптимизацию. Сначала нужно понять, можно ли привести данные к единой модели.

Источник: FinOps Foundation, FOCUS

💬 Практики FinOps
Post #472 215
🟢У Максима Качинского вышла большая техническая статья на Хабре про KEDA, Kubernetes и FinOps

Максим Качинский, Head of Ops в Rocketdata и эксперт комьюнити Практики FinOps, разобрал KEDA как production-инструмент для workloads с непостоянной нагрузкой.

В статье не только про scale-to-zero. Внутри есть конфиги, сценарии и проверки перед раскаткой:

🟣очереди RabbitMQ, Kafka, SQS;
🟣cron scaler для dev/staging и сервисов с рабочими часами
🟣Prometheus scaler для RPS, latency и custom-метрик
🟣HTTP Add-on для кратких пиков трафика
🟣maxReplicaCount как технический лимит и финансовый гардрейл
🟣cold start, flapping, downstream-лимиты, алерты, rollback plan и troubleshooting

Главная ценность материала в том, что KEDA рассматривается не как «поставили автоскейлер и сэкономили», а как инженерный механизм, который нужно проверять через пилот: pod-hours, cost-метрики, SLA, latency, ошибки и поведение scale up / scale down.

Полезно DevOps, SRE, platform-инженерам и всем, кто отвечает за Kubernetes-инфраструктуру и хочет снижать холостой простой без ручного scale и bash-скриптов.


📝 Читать статью на Хабр по ссылке

💬 Практики FinOps
  • 👾 7
Post #471 254
⚡️ Как считать инфраструктуру, если у компании есть и свои ЦОДы, и публичные облака?

В теории FinOps часто начинается с облачных счетов. В реальности у крупных компаний картина шире: on-prem, colocation, Kubernetes, сервисные команды, закупки железа, лимиты, ФОТ, лицензии и новые AI-проекты.

В новом выпуске Практики FinOps поговорили с Дмитрием Деевым, руководителем отдела ИТ-инфраструктуры и сервисов «ВсеИнструменты.ру».

🟢 Разобрали, как перейти от общего бюджета к модели аллокации, зачем считать on-prem через ежемесячную стоимость, почему команды не сразу привыкают к лимитам и как IT-департамент может перестать выглядеть только затратным подразделением.

Темы выпуска:

🟣 чем ITFM отличается от классического FinOps
🟣 как считать гибридную инфраструктуру: ЦОДы, облака, colocation
🟣 почему on-prem нужно приводить к ежемесячной стоимости
🟣 как работают лимиты, пулы ресурсов и служба единого окна
🟣 зачем нужны теги, метаинформация и дашборды для владельцев бюджета
🟣 почему FinOps не всегда про экономию
🟣 как считать AI-затраты, GPU и новые инфраструктурные сценарии
🟣 куда может прийти FinOps через автоматизацию, алерты и LLM

Смотреть выпуск:
🎞 YouTube
📺 Rutube
📺 VK Видео

Слушать выпуск:
💬 Telegram Player (Mave)
🎵 Яндекс. Музыка
🎵 VK Музыка

💬 Практики FinOps
  • 👾 4
Post #468 160
👀 Давайте немного познакомимся

Нас читают люди с разным опытом и задачами: финансы, DevOps, SRE, ITSM, архитектура, продуктовые и технические команды.

Хотим лучше понимать, кто вы и что вам интереснее видеть в канале: FinOps-практики, инфраструктурные разборы, ITSM-связки или кейсы.

Ниже будут два коротких опроса. Будет супер, если отметитесь: именно ваша обратная связь помогает нам развиваться.
Post #467 207
С чего начинается FinOps

«Мяу», — говорит кошечка.

«Гав», — говорит собачка.

«Дедлайн — вчера. Бюджет — ноль», — говорит начальство.


И вот ты сидишь, не знаешь, с чего начать. То ли платформу выбирать, то ли дашборды на коленке клепать, то ли лезть в инфраструктуру руками, то ли пойти ещё статей почитать — вдруг там ответ.

Спойлер: ни с того, ни с другого, ни с третьего.

Новый цикл статей про FinOps на практике — как раз про то, с чего надо начинать на самом деле. Так что залетай к нам на Хабр почитать.

Никакой теории из методичек, только изнанка: с кем встречаться, о чём и кого спрашивать, что собирать и почему первая попытка посчитать косты почти наверняка ни к чему толком не приведёт.

💬 Практики FinOps
  • 👾 5
Post #465 209
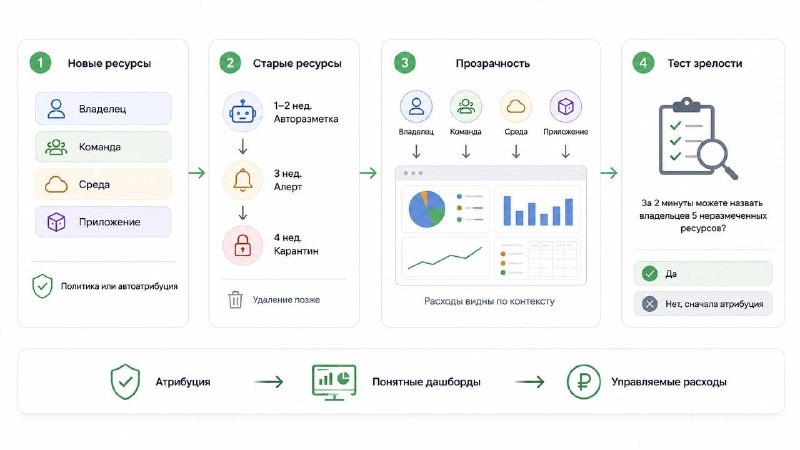
🟢 Как перейти к автоматизации и проверить инфраструктуру на зрелость (часть 3)

Мы начали с GPU-инстансов и постепенно вышли на общий вопрос: как сделать дорогую инфраструктуру управляемой.

Возвращаемся к инфраструктуре.

Чтобы такая модель работала не только в отчетах, каждому ресурсу нужны понятные атрибуты: владелец, команда, среда и приложение.

➡️ В первой части Александр разобрал, почему ручная очистка инфраструктуры быстро ломается.


➡️
Во второй части
, почему дашборды без владельцев, среды и приложения не дают управляемости.


Теперь главный вопрос: откуда возьмутся корректные метки?

Административным приказом проблему не решить. Инженеры запускают ресурсы под задачу, переключаются на другой приоритет, а разметка часто остается на потом.

Значит, процесс нужно закреплять на уровне инфраструктуры.

Первый шаг, обязательные теги для новых ресурсов.

Создание ресурса без владельца, команды, среды и приложения должно либо блокироваться политикой, либо закрываться автоматической атрибуцией.

Например, ресурс может наследовать теги от проекта, рабочей области, сервисного контура или автора задачи. Тогда команда меньше зависит от ручного заполнения полей.

Но здесь важны исключения.

Жесткий запрет не должен ломать системные аккаунты, CI/CD-пайплайны, автоскейлинг и сервисные ресурсы. Поэтому во многих случаях гибкая автоматизация атрибуции безопаснее, чем правило «запретить все без тегов».

Второй шаг, регламент для старых ресурсов.

Новые ресурсы можно размечать по правилам сразу. Но старые неразмеченные объекты никуда не исчезнут. Для них нужен отдельный процесс.

Примерная логика может быть такой:

🟣1–2 неделя, автоматическая разметка

Скрипт помечает ресурсы как unassigned и отправляет уведомления потенциальным владельцам: «Мы нашли этот ресурс в вашей подсети, подтвердите владение».


🟣 3-я неделя, общее оповещение

Неразмеченные ресурсы попадают в общий алерт: «Через неделю ресурсы без заполненных тегов будут остановлены».


🟣 4-я неделя, безопасный карантин

Ресурсы без владельца не удаляются сразу, а сначала останавливаются. Если ресурс нужен, владелец появится и исправит разметку.


Удаление возможно только после периода ожидания и отсутствия реакции.

Это важный принцип. Сразу удалять неразмеченные ресурсы рискованно. Остановка на несколько дней безопаснее: она помогает найти реального владельца без необратимых последствий.

Третий шаг, прозрачность для команд.

Когда у каждого расхода есть команда, владелец, среда и приложение, дашборды становятся рабочим инструментом.

Руководитель видит не общий счет провайдера, а расходы своего контура. В этот момент разговор меняется: команда сама видит тестовые среды, лишние мощности и ресурсы без понятной нагрузки.

Прозрачность часто работает лучше штрафов. Не потому что все сразу начинают экономить, а потому что у расходов появляется адрес и владелец.

Финальный тест на зрелость простой:

Можете ли вы за две минуты назвать владельцев пяти неразмеченных ресурсов в вашей инфраструктуре?

Если ответ «нет» или «нужно уточнять», начинать стоит не с новой аналитической платформы. Сначала нужны атрибуция, теги и порядок в данных.

Эффективный учет затрат держится на точной привязке ресурсов к владельцу, приложению, отделу и среде. Без этого любая оптимизация идет вслепую.


Так завершается цикл из трёх материалов: от ручного управления, через корректную атрибуцию, к автоматизации инфраструктуры.

🫨, если было полезно
🙂, если уже делаете что-то похожее или планируете внедрять

#finops #финопс #cloud #finops_эксперты

💬 Практики FinOps
  • 👾 7
Post #464 183

Forwarded from Аллокация расходов и драйверные модели · Claritech

Оргструктура плохо отвечает на каждый управленческий вопрос.
Финансовой команде часто нужен новый разрез.
P&L продукта.
P&L канала.
P&L региона.
P&L клиентского сегмента.
И тут появляется соблазн:
завести отдельный ЦФО под каждый такой вопрос.
Сначала это выглядит логично.
Есть отдельный объект - есть отдельный отчёт.
Но потом модель начинает спорить с реальностью.
Люди, площади, ИТ-системы и сервисы остаются общими.
Руководители управляют ими в одном контуре.
А расходы уже разложены по другому контуру.
В итоге подразделение выглядит легче.
Продукт может выглядеть дороже или дешевле.
А спор уходит не в решение, а в структуру учёта.
Проблема не в желании видеть продуктовую экономику.
Это нормальный вопрос для CFO.
Проблема в способе.
ЦФО отвечает на вопрос:
кто управляет ресурсом?
Аналитический разрез отвечает на другой вопрос:
кто потребляет ресурс и ради какого результата?
Если смешать эти вопросы, расчёт быстро теряет смысл.
Лучше оставить ресурс там, где им реально управляют.
А продукт, канал, регион или сегмент показать через связи и драйверы.
Например:
ресурс - в своём ЦФО,
правило распределения - в модели,
потребитель - в аналитическом разрезе,
результат - в P&L продукта.
Так можно видеть две картины одновременно.
P&L подразделения - кто отвечает за ресурс.
P&L продукта - кто этот ресурс потребляет.
В Claritech такая логика собирается через узлы, связи и правила.
Не нужно создавать новый ЦФО под каждый вопрос.
Нужно отделить ответственность от аналитики.
Хорошая модель не меняет оргструктуру ради отчёта.
Она показывает несколько разрезов одной экономики.
#Claritech #ClМетодика #управленческийучет #аллокациярасходов #драйверы
  • 👾 6
Post #463 259
🟩 После KEDA логично перейти от инженерных гардрейлов к правилам учета затрат

В Kubernetes мы говорили о технических ограничителях: когда поды поднимаются, когда уходят в ноль и где проходит верхняя граница масштабирования.

Но в FinOps этого недостаточно. Даже если инфраструктура масштабируется корректно, остается следующий вопрос: как эти расходы потом попадают в модель учета.

Когда начинаешь собирать модель расходов, быстро видно, что проблема почти никогда не в самой цифре. Она в правилах, по которым эта цифра появляется: что считаем ресурсом, кто его потребляет и по какому драйверу распределяем расходы.

Без этого любой инструмент автоматизации упирается в одно и то же. Система может масштабироваться и оптимизироваться, но спор о расходах остается на уровне интерпретаций.

Муратхан Эльдаров, автор канала про аллокацию расходов и драйверные модели и эксперт комьюнити Практики FinOps, разбирает эту же задачу со стороны управленческого учета: как меняется картина бюджета, когда правила фиксируют до расчета, а не после него.

В канале он показывает полный путь затрат: от процессов и ресурсов до конечного финансового результата, а также объясняет, что влияет на рентабельность.

💬 Практики FinOps

☁️ Стать голосом комьюнити
Post #454 177
После разговора о финансовых гардрейлах переходим к прикладному примеру, как эти правила работают на уровне Kubernetes.

👀 Разбор подготовил Максим Качинский, Head of Ops в компании Rocketdata и эксперт нашего комьюнити Практики FinOps.

В карусели Максим показывает, как KEDA помогает управлять затратами в Kubernetes: масштабировать сервисы по фактической нагрузке, не держать поды включенными «на всякий случай» и заранее ограничивать верхнюю границу масштабирования.

Разбираем, где стандартного HPA уже не хватает, как работает scale-to-zero и с каких сценариев безопаснее начинать пилот.

Завтра перейдем к управленческому слою: правилам учета, зонам ответственности и драйверам распределения затрат.

💬 Практики FinOps

☁️ Стать голосом комьюнити

#finops #финопс #cloud #kubernetes #keda
  • 👾 6
Older posts →

About this channel

How can I read @finops_ru without a Telegram account?
TGViewer shows the public web preview Telegram publishes for Практики FinOps: recent posts, photos, videos and the subscriber count, with no app, login or account.
How many subscribers does Практики FinOps have?
Практики FinOps (@finops_ru) has 569 subscribers on Telegram, refreshed roughly every 30 minutes.
Does Практики FinOps know I viewed it here?
No. Public channel previews carry no viewer identity, and TGViewer has no accounts or tracking of what you look up.
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →