TGViewer
Channel Public Channel
Московская группа экспериментального синтаксиса

Московская группа экспериментального синтаксиса

@expsynt

🔻Моделируем грамматические ограничения на основании экспериментальных данных.
🔻Здесь новости нашей группы.

Сайт: expsynt.com

VK: vk.com/expsynt

МАХ: https://max.ru/join/BcNMOjESPX2nB8X97j-BMFu_ZNPyOpFfy8BNANFhIkc
Subscribers
91
Photos
209
Videos
5
Links
42
Recent Posts 15 shown
Post #258
Московская группа экспериментального синтаксиса pinned «📺 ExpDay2026 — Результаты и материалы для всех! ПЛЕНАРНЫЕ ДОКЛАДЫ Доклад Dr. Дженнифер Калбертсон (про (не)естественный порядок в языке) Доклад Dr. Яны Виллер-Голд (про предсказание морфологической структуры слова) Доклад Dr. Эллен Лау (про альтернативы…»
Post #257 143
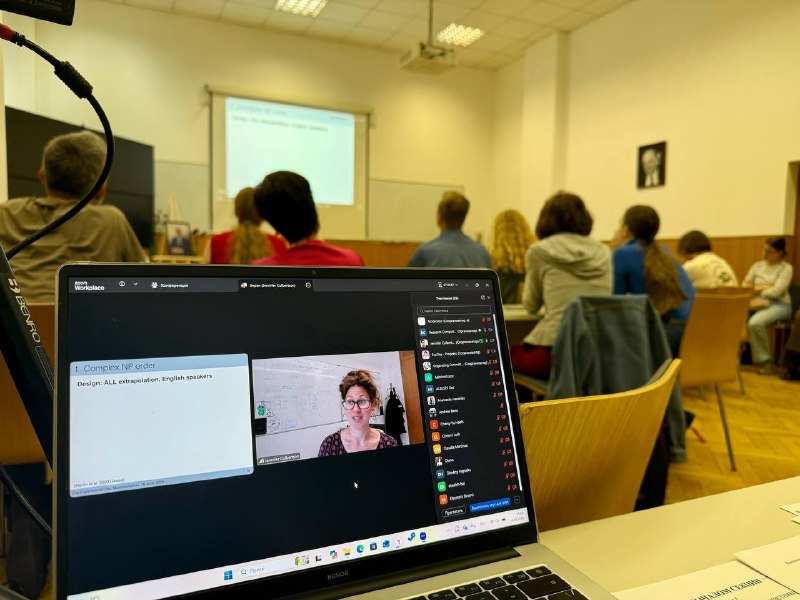
📺 ExpDay2026 —
Результаты и материалы для всех!


ПЛЕНАРНЫЕ ДОКЛАДЫ

Доклад Dr. Дженнифер Калбертсон (про (не)естественный порядок в языке)

Доклад Dr. Яны Виллер-Голд (про предсказание морфологической структуры слова)

Доклад Dr. Эллен Лау (про альтернативы лексикализму)

ШОУКЕЙСЫ

первый, второй, третий

ПРОГРАММА
(аннотации и хендауты)

expsynt.com/expday2026

____
#ОдинЭкспериментальныйДень2026 #ExpDay2026
  • ❤ 6
  • 👍 1
  • 🔥 1
  • 👏 1
Post #256 127
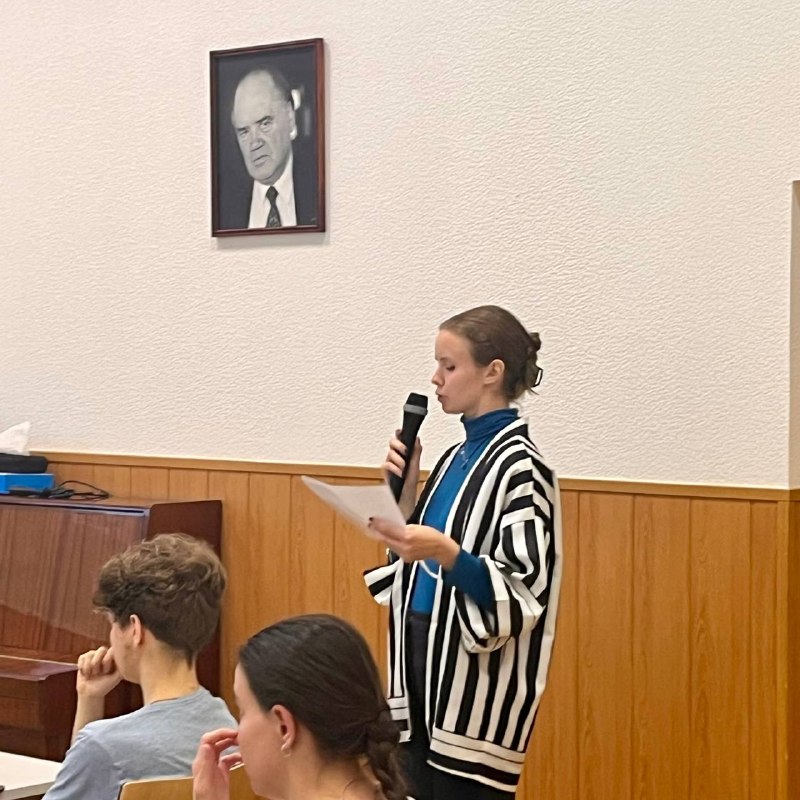
🆕 Также мы опробовали новый формат докладов для молодых исследователей – шоукейсы. Поскольку наша конференция изначально была направлена именно на молодых исследователей, мы сохранили для них площадку. Суть формата — представить свое исследование в течение 5 минут. Причем 5 минут дается на выступление и на вопросы, участники сами определяют, как распорядиться временем.
Участники отбирались по итогам рецензирования тезисов. В итоге получилось три секции по 6 докладов. Программа была динамичной! Многие участники подготовили расширенные хендауты с материалами своих выступлений, которые отправлялись в чат во время конференции (и уже опубликованы в программе на сайте). В чате активно шло обсуждение. Формат однозначно продуктивный. Краткость сообщений способствовала легкости восприятия, а охват тем и географии исследований получился широчайший!

🌏 Охват конференции был международный. Мы получили свыше 260 регистраций, к трансляции подключались более 100 участников. Треть слушателей составили исследователи из России; остальные участники представляли Австралию, Аргентину, Великобританию, Германию, Грецию, Египет, Израиль, Индию, Иорданию, Испанию, Италию, Китай, Марокко, Нигерию, Румынию, Сирию, США, Тунис, Уругвай, Францию, Хорватию, ЮАР и Японию — всего более двадцати стран. Половина шоукейс-докладов познакомила слушателей с работой российских лабораторий: география представленных исследований охватила Москву, Санкт-Петербург, Нижний Новгород и Томск.

Благодарим всех докладчиков и слушателей за то, что разделили с нами этот Один экспериментальный день!
Обязательно будем повторять.

____
#ExpDay2026
  • ❤ 10
  • 🔥 2
  • 👏 2
Post #250 90
«Один экспериментальный день» состоялся!

🌐 Как объединить всех, кто разделяет наш интерес к экспериментальной лингвистике? Ответом на этот вопрос стал «Один экспериментальный день» 18 июня 2026 г.

Программа включала три пленарных доклада ведущих лингвистов, ученых, чьи работы определяют облик современной экспериментальной лингвистики, и три динамичные шоукейс-сессии, в рамках которых молодые исследователи представили свои результаты в пятиминутном формате: коротко, ёмко и ярко.

🎯 Наши общие цели, воплощенные в программе – быть в авангарде экспериментальной лингвистики, понимать, кто и над чем работает прямо сейчас, в разных лабораториях и странах, и без промедления осваивать новые методы и концепции. Именно пленарные доклады сделали эти цели осязаемыми.

🔺 Доклад Дженнифер Калбертсон (Университет Эдинбурга, ведущий ученый, использующий методологию выучивания искусственных языков) был посвящен исследованию ограничений на порядок элементов в языках мира: указательных местоимений и прилагательных в именных группах и аффиксов в именных словоформах. Исследовательскую программу Дженнифер отличает исключительная последовательность и ясная внутренняя логика. Особое внимание в докладе уделяется семантике – тому, в какой мере значение связано с линейным положением слов и морфем и иерархической структурой языка.


🔺
Выступление Яны Виллер-Голд
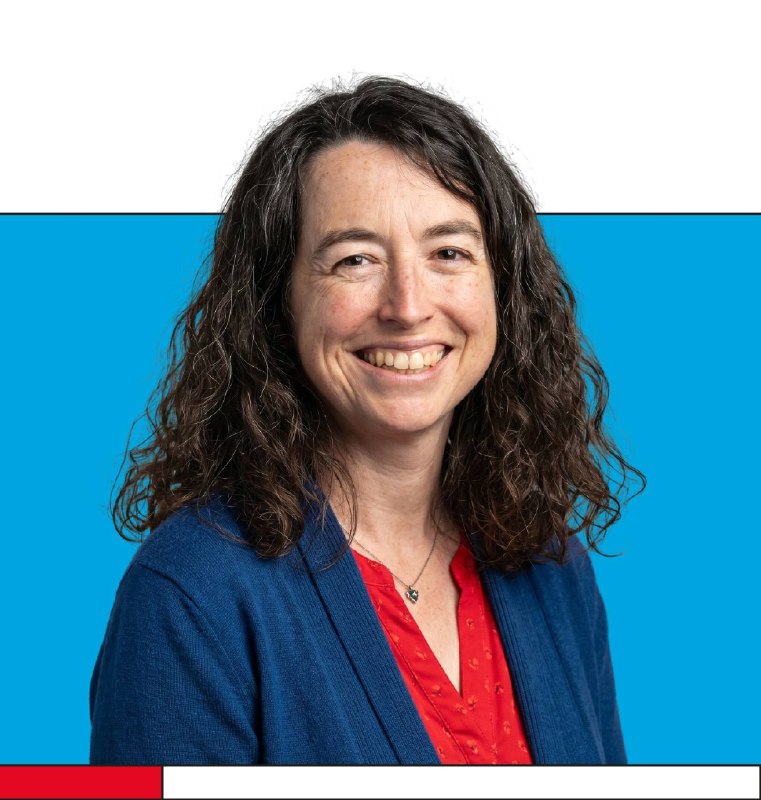
(Университет Оксфорда, автор масштабных исследований согласования на материале южно-славянских языков) отличалось очень убедительной постановкой проблемы. Известно, что при обработке языка возникают ожидания конкретных лексем или определенных грамматических признаков. Вопрос, который задает Яна: а есть ли у людей сходные ожидания насчет морфологической структуры слова? В поисках ответа привлекается материал count/mass nouns: Яна проводит эксперимент, в котором проверяется, кодируется ли в синтаксисе признак, связанный с тем, является существительное исчисляемым или нет. То обстоятельство, что данное направление является для Яны новым, делает её решение представить его именно на нашей конференции особенно значимым.


🔺
Доклад Эллен Лау
(Университет Мэриленда, ведущий исследователь в области нейролингвистики, чьи работы переосмысляют фундаментальные представления об обработке языка), носил глубоко теоретический характер и был посвящен вопросу о возможных альтернативах лексикализму. Эллен предложила слушателям порассуждать о том, что следует считать единицами в психолингвистических исследованиях и существуют ли такие единицы в принципе. Подобный тип научной работы — критическое осмысление самих оснований исследовательской практики — представляет собой эталонный образец фундаментальной науки. При этом подход Эллен далек от крайнего скептицизма и предполагает сопоставление различных вычислительных моделей, способных предсказать распределение коррелятов речевой деятельности (как время реакции, амплитуда N400 и др.), полученных в рамках экспериментов.
  • ❤ 7
  • 🔥 2
  • 👏 1
Post #249 111
🚀УЖЕ ЗАВТРА!
• Один экспериментальный день
•

📍 Ссылки на трансляцию и все детали уже отправлены на почту зарегистрированным участникам.

Весь завтрашний день наш англоязычный канал будет работать в режиме сопровождения программы: расскажем, что идёт прямо сейчас, что будет дальше, когда подключаться.

Начинаем завтра в 11:00 (МСК). До встречи!
  • ❤ 5
  • 🔥 2
  • 👌 1
Post #247 125
🧪 KEYNOTE: Ellen Lau (University of Maryland)
 
📌 How to study language processing without words: a case study in compound production
 
In recent decades, diverse frameworks in linguistic theory have come to the consensus that there is no common unit of representation that unites linguistic form, syntax, and meaning corresponding to the colloquial 'word' (e.g., Haspelmath 2011). However, most  psycholinguistic models and cognitive neuroscience of language models continue to assume that language processing is organized around such 1-to-1-to-1 mappings, whether they call them 'lexical items', 'morphemes', or 'lemmas'. This kind of approach discounts the great prevalence of so-called 'idiomatic' non 1-to-1 mappings across human languages, as well as the fact that phonology, like syntax and semantics, has a rich dependency structure in its own right that is not isomorphic to either (Krauska & Lau 2023). But even for psycholinguists who recognize this, it can be hard to resist adopting the well-trodden 1-to-1 framework when they just want to get on with studying their phenomenon of interest. In this talk I'll use a recent study from our group investigating the production of English compounds with EEG (Cuonzo et al. 2026) to illustrate how bread-and-butter language processing research can be designed and presented in a way that is more consistent with the known properties of natural (spoken or signed) human languages. 

 
🕒 June 18, 16:10 – 17:20 Moscow time (UTC +3)
 
________
#ExpDay2026
  • 🔥 4
  • ❤ 3
  • 💯 1
Post #246 102
🧪 KEYNOTE: Jana Willer-Gold (University of Oxford)
 
📌 Prediction-Enhanced Morphological Decomposition
 
The prediction-enhanced lexical processing where parser incrementally incorporates parsed lexical items to predict upcoming words is strengthened by anticipatory evidence especially when constrained by context across measures (N400, cloze probability, surprisal).
 
But what about prediction-enhanced morphological decomposition?, the parsing model where the parser uses contextually determined lexical predictions to guide how words are broken down into their constituent morphemes — roots, prefixes, suffixes, and inflections.
 
The core idea: instead of applying rule-based or statistical segmentation blindly, the model first generates a prediction about what the next item’s morphological-representation likely is given its context, then uses that expectation to build the most plausible morphological parse or representation. This matters because prediction enhanced morphological representations can facilitate decomposition to the root even when the root is not lexically matched to the contextually predicted lexeme but is to the morphological-representation of the upcoming noun.
 
Individuation-ambiguous roots such as family often have multiple plausible representations, and the correct parse changes the item's semantics substantially. The key insight is the feedback loop between prediction and decomposition. A pure morphological parser treats family as a sequence of morphemes in isolation. A prediction-enhanced parser knows from context that the word is being used as a individuated-mass noun as in “my family is numerous” or individuated-count noun as in “my family are numerous”, which in the latter case strengthens the parse “my family.PL” and supresses less compositional representation.
 
A model enhanced by morphological prediction can use predictive context to facilitate decomposition in languages with rich morphological representations and benefits substantially, since the prediction prior compensates for root-ambiguity.
 
The model is tested in Croatian using individuation-ambiguous (mass vs count) nouns in a self-paced reading and lexical decision task.

 
🕒 June 18, 12:35 – 13:45 Moscow time (UTC +3)
 
________
#ОдинЭкспериментальныйДень2026 #ExpDay2026
  • ❤ 4
  • 🔥 1
  • 👏 1
Post #245 93
🧪 KEYNOTE: Jennifer Culbertson (University of Edinburgh)

📌 Do language universals reflect universals of human cognition?
Cross-population experimental evidence


Human languages exhibit striking variation. At the same time, certain linguistic patterns crop up again and again, while others seem to be extremely rare. What these tantalising observations tell us about human language is one of the most contentious questions in linguistics. Do similarities between languages reflect a special capacity for language that has evolved only in humans? Do they reflect more general features of the human mind, potentially shared with our ancestors? Are they just down to accidents of history? Traditionally, linguists have argued for one or another of these answers based on limited sources of evidence. For example, it is common to base claims on small samples of languages, case studies of how a handful of languages change over time, or examples of how individual languages are learned. In this talk, I present the results of two case studies, focusing on morphology and syntax. These studies highlight how experimental methods across populations can bring crucial empirical evidence to bear on how language is shaped (or not!) by the human linguistic and cognitive system.


🕒 June 18, 11:05 – 12:15 Moscow time (UTC +3)

________
#ExpDay2026
  • ❤ 5
  • 🔥 4
  • 👍 1
Post #244 96
🚀 Мы на финишной прямой!

Событие, которого мы все ждали, совсем близко. Программа вот-вот будет опубликована, мы добавляем к ней финальные штрихи.

Чем мы занимаемся прямо сейчас?
✅ Расписание и тайминг выступлений пленарных докладчиков уже готовы. Завтра вы узнаете темы и аннотации докладов.
✅ Письма с результатами отбора на шоукейс разосланы. Все участники шоукейса получили важную информацию — проверяйте почту (и папку «Спам»!).
✅ Ждём неанонимные тезисы от участников шоукейса. В начале недели Вы увидите своими глазами многообразие экспериментальных исследований со всего мира.

Немного цифр:
🎤 На шоукейс поступило 45 заявок. Конкурс был серьезный. Уверены, что получилась динамичная программа, сбалансированная по темам и жанрам исследований.
👥 Более 200 человек уже хотят присоединиться к нам в качестве слушателей.

Мы невероятно рады такому высокому уровню заявок и вашему интересу. Уже совсем скоро поделимся подробной программой — следите за новостями!

________
#ОдинЭкспериментальныйДень2026 #ExpDay2026
  • ❤ 7
  • 🔥 2
  • 👏 1
Post #243 81
ONE EXPERIMENTAL DAY
| Пересматриваем положения лексикализма

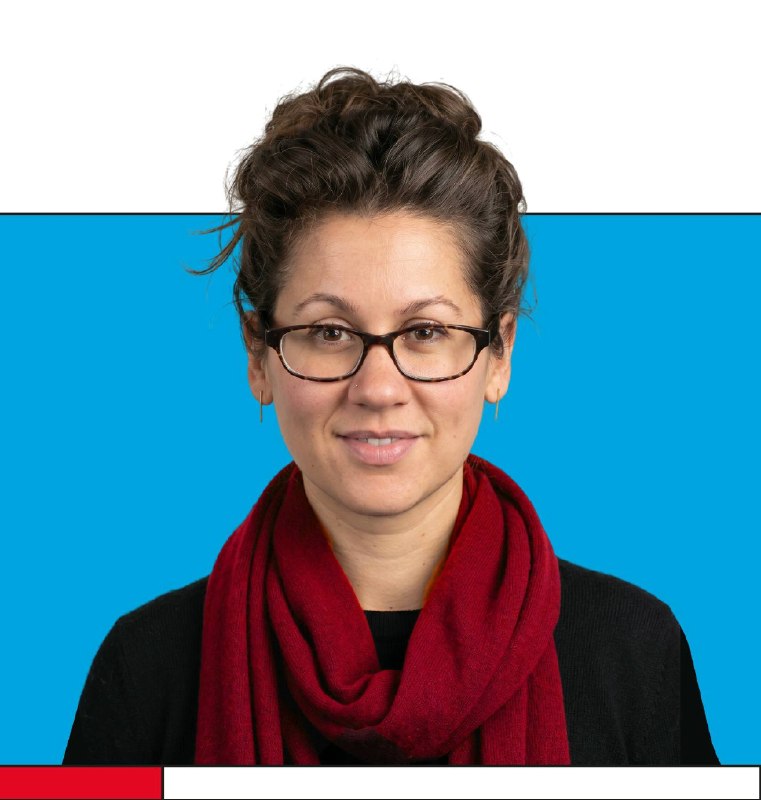
🎤 Наш третий приглашённый докладчик — Эллен Лау, доцент Мэрилендского университета и соруководитель исследовательского центра магнитоэнцефалографии KIT-Maryland. Её работы посвящены тому, как мозг обрабатывает язык в реальном времени. В исследованиях Эллен использует широкий набор методов — от поведенческих экспериментов до ЭЭГ, МЭГ и фМРТ. При этом её цель заключается не только в описании активируемых зон мозга, но и в построении теорий архитектуры языка.

🔠 Одно из ключевых направлений её работ связано с пересмотром базового допущения психолингвистики — идеи лексикализма. Согласно этой модели, в ментальном лексиконе хранятся леммы — «готовые блоки», объединяющие значение, грамматику и форму. Однако такая картина сталкивается с рядом проблем.

🌳 Например, в полисинтетических языках одна словоформа может соответствовать целому предложению, и тогда лексикалистская модель вынуждена постулировать огромные и избыточные словари. Идиомы тоже плохо вписываются в данную схему: их компоненты могут разрываться синтаксически, при этом значение сохраняется. Английские конструкции вроде pass a law, pass a test, pass a kidney stone демонстрируют, что интерпретация глагола зависит от контекста. Дополнительную трудность вносит супплетивизм: например, в языке яки (юто-ацтекская семья) глагол «убить» имеет разные формы (me’a и sua), выбор которых определяется числом объекта. Это означает, что информация о синтаксических свойствах аргумента должна быть доступна до его явной реализации в речи, что мало совместимо с представлением о строго последовательной лексикалистской архитектуре.

⚛️ В ответ на эти трудности Эллен вместе с коллегой предлагают отказаться от представления о лемме как об атомарной единице. Вместо этого они разрабатывают нелексикалистскую модель, в которой синтаксические объекты являются абстрактными и не содержат ни фиксированного значения, ни фонологической формы. Связь между смыслом, структурой и формой осуществляется посредством двух независимых отображений: (1) от смысла к синтаксической структуре и (2) от синтаксической структуры к формальной реализации.

➡️ В такой модели соответствия не являются однозначными: один смысловой элемент может отображаться на несколько синтаксических узлов, а один синтаксический узел может быть реализован несколькими формальными элементами. Например, в конструкции the alarm went off семантический компонент «зазвенеть» распределяется между элементами go и off, а прошедшее время выражается через морфему -ed, которая фонологически сливается с основой и реализуется как went. При этом элемент формы off соответствует синтаксическому узлу, не несущему самостоятельного значения. Таким образом, граница между внутрисловной и синтаксической структурами оказывается непринципиальной: правила композиции, действующие внутри слова, и правила, действующие на уровне предложения, рассматриваются как проявления одного и того же механизма структурной композиции.

Приходите послушать выступление Эллен Лау, чтобы из первых уст узнать о том, как современные экспериментальные методы позволяют пересматривать базовые положения теории языка.

Регистрация слушателей открыта до 15 июня!

____

#ExpDay2026
  • ❤ 7
  • 🔥 2
  • 🤯 2
Post #242 86
ONE EXPERIMENTAL DAY
| Продолжаем знакомиться с докладчиками

🎤 Следующий приглашённый докладчик — Яна Виллер-Голд, лектор и исследователь факультета лингвистики, филологии и фонетики Оксфордского университета. Её работы, органично сочетающие теоретический и экспериментальный подходы, посвящены изучению морфосинтаксической вариативности в согласовании, маркированности грамматических признаков и эллипсиса. Наиболее известны исследования Яны о согласовании с сочинительными конструкциями, — области, где даже в пределах одного языка наблюдается крайняя степень вариативности. Особенного внимания заслуживает тот факт, что научная группа под её руководством не ограничивается материалом одного языка и, более того, одной экспериментальной методикой.

🌐 В масштабном проекте на материале южнославянских языков команда Яны изучала, как предикат согласуется с сочинёнными подлежащими разного рода. Эксперименты с контролируемой элицитацией показали, что взаимодействие грамматических признаков не является равновероятным; напротив, оно подчиняется чёткой иерархии, в которой одни признаки систематически доминируют над другими. Говоря метафорически, признаки при «борьбе» за контроль согласования играют не в игру наподобие «камень, ножницы, бумага», а скорее в турнир, в котором есть явные фавориты с высоким рейтингом. Безусловным лидером оказывается мужской род, однако и средний род проявляет себя в качестве активного игрока, регулярно «одерживая верх» над женским родом. Полученные данные отчётливо свидетельствуют о том, что в согласовании с сочинительными конструкциями определяющую роль играет не иерархия, а линейный порядок: иерархическое согласование (с первым конъюнктом) встречается реже, чем линейное (с ближайшим).

💫 Яна и её коллеги также проверили гипотезу, согласно которой согласование с ближайшим конъюнктом представляет собой эффект эллипсиса. С этой целью были проведены эксперименты с использованием визуального стимульного материала: респондентам предъявлялись предложения типа «Сабли и копья столкнулись в битве», где глагол согласовывался с ближайшим подлежащим (в отличие от русского, в южнославянских языках во множественном числе возможно согласование по роду). Если бы в основе лежал эллипсис, участники должны были бы интерпретировать предложение как описание двух раздельных событий (отдельно столкнулись сабли и отдельно — копья). Однако эксперимент показал, что носители южнославянских языков уверенно выбирают для таких предложений изображения, описывающие единое событие (сабли скрещиваются с копьями). Такой результат позволяет сделать вывод о том, что согласование с ближайшим конъюнктом не может быть сведено к эллипсису.

❓ Наконец, в своих исследованиях Яна Виллер-Голд также искала ответ на вопрос, в какой момент деривации применяются т.н. правила разрешения — принципы, согласно которым при соединении элементов с конфликтующими грамматическими признаками (например, двух существительных разного рода) определяется результирующее значение для согласования. Для этого на материале хорватского языка, в котором результирующую функцию несет признак мужского рода, применялась другая методика — чтение с саморегуляцией скорости. Сравнивались две гипотезы: разрешение в пользу мужского рода происходит уже на уровне сочинительной конструкции (= цели согласования, ConjP), либо в процессе согласования с предикатом (= на уровне зонда согласования, например, при множественном согласовании с каждым конъюнктом). Оказалось, что уже при прочтении сочинительной конструкции носители языка «ожидают» согласования именно по мужскому роду: все прочие варианты вызывают значимую задержку в чтении. Это говорит в пользу того, что вычисление правила разрешение, по-видимому, происходит на уровне сочинительной конструкции.

🔬 Если вам интересно узнать, как эксперимент помогает обнаружить тонкие настройки грамматики, обязательно приходите на доклад Яны Виллер-Голд 18 июня. Это редкая возможность увидеть, как теоретические гипотезы о структуре грамматики проходят верификацию через точно спланированный эксперимент.

📝 Регистрация продолжается!

____
#ExpDay2026
  • ❤ 5
  • 🔥 3
  • 👍 1
Post #239 172
📰 Интервью Павла Валерьевича Гращенкова «Вечерней Москве»!

Представьте свою жизнь без прилагательных. Что будете делать? Если затрудняетесь с ответом, вам обязательно надо познакомиться с нивхским языком и ... прочитать интервью.

Павел Валерьевич рассказывает об одном из проектов нашей лаборатории автоматизированных лексикографических систем НИВЦ, который посвящен нивхскому языку.

Какие результаты уже есть:
— Создан прототип русско-нивхского переводчика.
— Собирается корпус текстов нивхского языка.
— Обучаются нейросети для разметки нивхских текстов.

Подробнее об устройстве нивхского языка и о том, почему так важно его сохранить, читайте здесь!
  • ❤ 8
  • 🔥 3
  • 👏 1
Post #238 176
ONE EXPERIMENTAL DAY
| Знакомство с экспертами


🎤 Первый приглашенный докладчик — профессор Университета Эдинбурга Дженнифер Калбертсон. Дженнифер работает в рамках методологии усвоения искусственного языка, artificial language learning (ALL). Суть подхода состоит в том, что участникам эксперимента предъявляется небольшой контролируемый фрагмент грамматики, а затем исследователи смотрят, как этот материал усваивается, воспроизводится и трансформируется. Такие эксперименты имеют межгрупповой дизайн: разные группы людей обучаются мини-языкам, которые отличают по определенному параметру.

📚В чем объяснительная сила метода ALL? Типология описывает, какие структуры встречаются в языках мира, а какие — нет. Но вопрос о причинах распределения остается открытым: насколько наблюдаемые закономерности связаны с тем, как человек воспринимает, распознает языковые единицы, упорядочивает их и воспроизводит? Метод ALL позволяет перейти от описаний к эксперименту, поскольку опирается на гипотезу: если носители разных языков демонстрируют сходные предпочтения при усвоении искусственной грамматики, это говорит о существовании определенных когнитивных ограничений.

🔎 В качестве примера можно взять исследование Дж. Калбертсон с соавторами, посвященное универсалии Гринберга 18. Согласно этому обобщению, если в языке представлен порядок «Прилагательное — Существительное», то в нем также представлен порядок «Числительное — Существительное». А вот комбинация «Прил — Сущ» + «Сущ — Числит» крайне редка: по данным атласа WALS, она встречается только в 4% языков. Участникам экспериментов предъявлялись искусственные мини-языки с одним из четырех возможных порядков слов, который определялся взаимным расположением существительного и прилагательного или числительного. Результаты показали, что даже при наличии того самого, крайне редкого порядка в обучающем материале участники систематически меняли свои ответы в сторону типологически более распространенных структур. Что важно, результат повторялся для носителей языков с различным расположением модификаторов относительно существительного, что позволило говорить о когнитивной природе закономерности, а не простом переносе из родного языка.

📈 Важно, что это лишь один эпизод в масштабной и последовательной программе исследований. Дж. Калбертсон и ее команда применили ту же методологию к целому ряду лингвистических проблем. Они изучали, как люди усваивают системы лиц в местоимениях (например, почему в языках встречаются одни парадигмы, а другие — нет); как дети и взрослые по-разному выучивают системы классификации имен; почему в языках с богатой морфологией аффиксы числа и лица располагаются в определенной последовательности относительно корня и друг друга; а также почему суффиксы в языках мира встречаются чаще префиксов. Эксперименты с искусственными языками позволили приблизиться к возможным объяснениям закономерностей там, где раньше ограничивались только статистическими обобщениями.

❓ Здесь открываются горизонты для новых исследований — и одновременно возникают самые сложные вопросы. Если типологически частотное так легко усваивается, почему сохраняются редкие паттерны? Как взаимодействуют разные типологические особенности в ходе усвоения? Насколько усвоение в эксперименте походит на реальное усвоение языка (как первого, так и второго)? Уверены, к ответам мы приблизимся в ходе доклада Дженнифер Калбертсон 18 июня.

📝 Регистрируйтесь!

____
#ExpDay2026
  • 🔥 8
  • ❤ 4
  • 👍 1
Post #237 202
🏆 ЭТО ТРИУМФ!

Поздравляем участниц нашей научной группы Дарью Дмитриевну Белову и Ладу Игоревну Паско с получением стипендии Президента РФ для аспирантов!

В этом году конкурс стал рекордным: более 6 тыс. заявок из 79 регионов страны, и только 800 удостоились победы. Стипендия Президента РФ — это финансовая поддержка на всё время проведения исследования в аспирантуре. Она дает молодым ученым возможность полностью сосредоточиться на науке.

В рамках диссертационного исследования Дарья Дмитриевна изучает частновопросительный эллипсис в финно-угорских языках, а Лада Игоревна погружена в исследование конструкций с препозицией дополнения в русском — теперь есть надежная опора для этой теоретически значимой работы.

Поздравляем с безусловным успехом научного руководителя — Екатерину Анатольевну Лютикову!

Желаем победителям, чтобы вдохновение сопровождало на всем исследовательском пути! Смелых гипотез, легкого пера и ярких публикаций.
  • 🔥 13
  • ❤ 9
  • 🏆 2
Older posts →

About this channel

How can I read @expsynt without a Telegram account?
TGViewer shows the public web preview Telegram publishes for Московская группа экспериментального синтаксиса: recent posts, photos, videos and the subscriber count, with no app, login or account.
How many subscribers does Московская группа экспериментального синтаксиса have?
Московская группа экспериментального синтаксиса (@expsynt) has 91 subscribers on Telegram, refreshed roughly every 30 minutes.
Does Московская группа экспериментального синтаксиса know I viewed it here?
No. Public channel previews carry no viewer identity, and TGViewer has no accounts or tracking of what you look up.
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →