
Agent Assessment Framework или как оценивать агентов
В конце 2025 мало кого уже заинтересуют простые LLM apps, потому что все внимание перешло к агентам. Но есть нюанс: мы научились их запускать, но мало кто умеет делать исчерпывающую оценку качества. Так происходит из-за того, что текущие подходы чаще всего фокусируются на проверке выполнения итоговой цели (end-to-end). Но упускают довольно много важных вещей (например, нарушение политик безопасности, наличие низкой полноты поиска в памяти и другое)
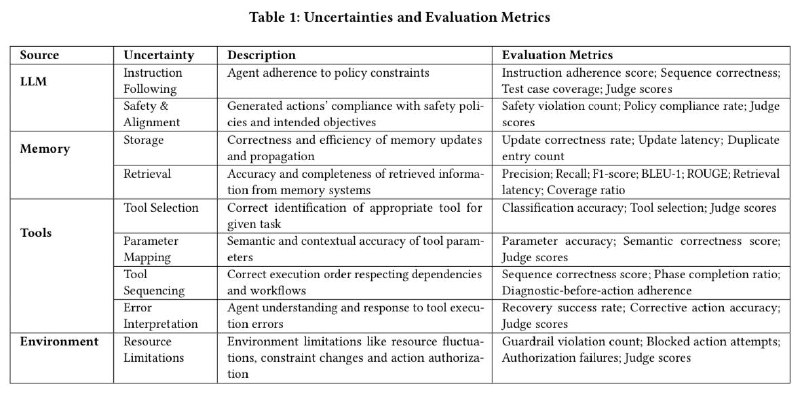
Поэтому хочу поделиться статьей, опубликованной 2 недели назад, которая описывает фреймворк для оценки агентов. Авторы предлагают отказаться от старых метрик и строить оценку вокруг следующих 4 компонент, из которых агент и состоит:
🟣Memory. Механизм хранения и извлечения информации. Оценивается корректность обновления и эффективность поиска
🟣Tools. Способность агента действовать в среде. Оценивается правильность выбора инструмента, параметров и последовательности их использования. Тут, кстати, обычно возникает пик ошибок, особенно в сложных сценариях
🟣LLM. Оценивается следование инструкциям и safety & alignment
🟣Environment. Операционный контекст. Оценивается соблюдение рабочих процессов, защитных ограничений (guardrails) и конфигурируемость
А суть фреймворка заключается в трёхуровневой проверке:
1️⃣ статика (соответствие спецификациям)
2️⃣ мониторинг в рантайме
3️⃣ judge-based evaluation (с помощью LLM или другого агента-аудитора)
🔬 Что показали тесты на трёх реальных CloudOps-кейсах
Эксперименты провели на платформе MOYA, моделируя реалистичные сценарии: от простой оптимизации затрат до сложного мультиагентного анализа инцидентов. И что заметили:
🟣 Агент может на 100% «исправить» уязвимость (публичный S3-бакет), но при этом полнота поиска в памяти (recall) была всего 13%
🟣 В сценарии оптимизации затрат агент формально завершил неиспользуемые инстансы (успех 100%), но соблюдал политики только в 33% случаев. Он работал, но неправильно
🟣 Чем сложнее сценарий (особенно с несколькими агентами), тем больше скрытых ошибок всплывает в оркестрации инструментов (Tools) и соблюдении ограничений среды (Environment)
Поэтому если вы запускаете агентов в prod, вам точно нужен аудит их поведения, а не просто проверка выходных данных (end-to-end). Только так вы сможете иметь полное представление о качестве работы вашего агента, быстрее делать дебаг и улучшать работу агента
Post #56
1.29K
- 🔥 10
- ❤ 5
- 👍 3