
Инструменты для оценки качества моделей и LLM-агентов
Вот вы взяли open-source LLM, натренировали свою модель (ну, вдруг, вы очень богаты) или же построили LLM агента: какие инструменты теперь использовать, чтобы узнать, а насколько хорошо работает это решение / безопасно / или что-то еще?! Конечно, в основе всего этого лежат качественные бенчмарки и датасеты, но сегодня речь пойдет об инструментах для замера качества, aka Evaluation Tools (ну или просто Evals).
Сразу скажу, что количество Eval-ов огромно. А большая часть функционала повторяется от решения к решению, потому что в базе лежит одна и та же идея: у вас есть датасет запросов, и вы хотите оценить результаты, получаемые с помощью LLM / агента. Поэтому расскажу о наиболее интересных и популярных решениях.
🟣DeepEval. Классная open-source библиотека, которая постоянно обновляется и позволяет оценивать различные вещи наиболее актуальными способами (уровень галлюцинаций, качество RAG, релевантность ответов, и т.д.). Также там есть свой RedTeamer для оценки рисков и поиска уязвимостей.
🟣LangSmith. Это платформа от LangСhain с библиотекой внутри, которая имеет ну просто потрясающую документацию. Там есть буквально все: Offline и Online Eval, unit-тесты, регрессионное тестирование и многое другое. И просто поиграться, кстати, можно бесплатно.
🟣OpenAI. Удобная библиотека, Eval-ы которой можно просто запускать через CLI. От вас нужно будет подготовить YAML-конфиг с нужными параметрами и, в целом, все!
🟣Autoblocks. Основная цель данной платформы — обеспечить высокие стандарты безопасности и соответствие нормативным требованиям при внедрении AI-решений. Для этого они сделали свой AI Trust Center, а также поддерживают сертификации HIPAA, SOC 2 Type 2 и другие.
🟣Snorkel. Кто-то наверняка знает эту библиотеку как фреймворк для разметки данных. Но и у них есть Eval: доступны почти все необходимые функции, а сам фреймворк позволяет облегчить процесс создания датасетов.
🟣braintrust. Идеальное решение с понятным и красивым UI для тех, кто не хочет писать код. Естественно, за красоту и удобство придется заплатить (хотя часть функционала доступна бесплатно).
🟣Langfuse. Не могу сказать, что их Eval какой-то особенный, но если вы используете саму платформу (а она хороша для трассировки, мониторинга и оценки производительности LLM-приложений), то интегрировать их Eval будет удобнее всего. Поиграться также бесплатно, но за использование в prod-продуктах придется платить.
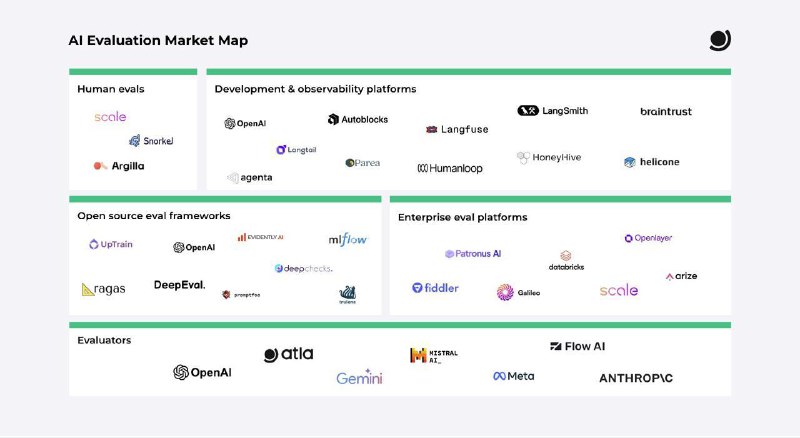
Как я и писала выше, Eval-ов, очень много. И если вам хочется поразбираться, а какие есть еще, рекомендую начать с картинки в посте.
Post #41
660
- 👍 12
- ⚡ 2
- ❤ 2