TGViewer
Channel Public Channel
Библиотека собеса по Data Science | вопросы с собеседований

Библиотека собеса по Data Science | вопросы с собеседований

@ds_interview_lib

Вопросы с собеседований по Data Science и ответы на них.

Учиться у нас: clc.to/GjjbkQ

По рекламе: @tproger_sales_bot

Учиться у нас: https://proglib.io/w/7dfb7235

Для обратной связи: @proglibrary_feeedback_bot
Subscribers
4.47K
Photos
533
Videos
16
Links
660

Showing posts older than #872 · Back to latest

Older Posts 20 shown
Post #871 1.11K
⚙️ Как работает API

Proglib рассказывает базу в формате рилса
Post #870 1.22K
В чем разница между Linear Regression, Random Forest и GBDT? Как их реализовать в распределенных вычислениях

🔹 В чем разница между Linear Regression, Random Forest и GBDT?

Linear Regression (LR) — простой и быстрый, но работает только с линейными зависимостями.
Random Forest (RF) — устойчив к выбросам и переобучению, но может быть медленным.
Gradient Boosting Decision Trees (GBDT) — обеспечивает высокую точность, но требует тонкой настройки и больше времени на обучение.

🔹 Как реализовать эти алгоритмы в распределенных системах?

RF — легко распараллеливается, так как деревья строятся независимо.
GBDT — сложнее, но можно ускорить построение деревьев в каждой итерации.
LR — можно параллелить через parameter server и асинхронные обновления.

Библиотека собеса по Data Science
Telegram Библиотека собеса по Data Science | вопросы с собеседований Вопросы с собеседований по Data Science и ответы на них. Учиться у нас: clc.to/GjjbkQ По рекламе: @tproger_sales_bot Учиться у нас: https://proglib.io/w/7dfb7235 Для обратной связи: @proglibrary_feeedback_bot
  • ❤ 1
  • 👍 1
Post #869 1.19K
Какова вероятность распределения количества подбрасываний монеты до первого выпадения орла

✅ Ответ:
Количество бросков, необходимых до появления первого орла, подчиняется геометрическому распределению.

Библиотека собеса по Data Science
  • ❤ 3
  • 👍 1
Post #868 1.13K
Как защитить модели от атак в машинном обучении?

✅ Аугментация данных и робастное обучение — добавление случайных шумов в данные для повышения устойчивости модели.
✅ Adversarial Training — специальное обучение модели на данных с атаками, чтобы она их распознавала.
✅ Дифференциальная приватность — техники, предотвращающие утечку информации о тренировочных данных.
✅ Мониторинг аномалий — выявление подозрительных входных данных и реагирование на них.

Библиотека собеса по Data Science
  • ❤ 2
  • 👍 1
Post #867 1.25K
Какие технические навыки нужны для перехода от небольшого анализа данных к крупным проектам в Data Science?

🔹 Хранение данных
1. Распределенные системы хранения: Hadoop HDFS, AWS S3, Azure Blob Storage, NoSQL
2. Data Lakes для обработки неструктурированных и сырых данных

🔹 Обработка данных
1. Фреймворки для работы с big data: MapReduce, Apache Spark
2. Методы параллельных вычислений для ускорения анализа

🔹 Реализация системы
1. Построение надежных data pipelines
2. Мониторинг и логирование моделей
3. Контейнеризация (Docker, Kubernetes) для развертывания и масштабирования

Библиотека собеса по Data Science
  • ❤ 2
  • 👍 2
Post #866 847

Forwarded from Proglib.academy | IT-курсы

🧮🔠 Математика в действии: решаем хитрые задачи по прогнозированию, оптимизации и логике

Статья, которая поможет развить навыки решения задач с помощью математики.

➡️ Вот что вас ждет

1️⃣ Прогнозирование численности населения — используем цепи Маркова для предсказания миграций между городом и пригородами.

2️⃣ Минимизация затрат — находим минимальное скалярное произведение векторов для оптимального распределения задач между работниками.

3️⃣ Машина времени — решаем задачу максимального числа пересекающихся временных интервалов с помощью заметающей прямой.

4️⃣ Алгоритм Целлера — вычисляем день недели по дате. Проверка на практике.

🔵 Хочешь прокачаться в математике для ML? Тогда разбирайся с этими задачами и не упусти вебинар: «Математика для ML: от теории к практике».

👉 Читать статью
  • 👍 1
Post #865 1.1K
В чем разница между Data Scientist и Machine Learning Engineer?

🔹 Data Scientist в первую очередь фокусируется на преобразовании бизнес-задач в задачи, основанные на данных, предлагает и прототипирует решения.
🔹 Machine Learning Engineer берет эти решения, превращает их в работающие алгоритмы и модели, развертывает и поддерживает их в продакшене.
  • ❤ 5
  • 👍 1
Post #864 1.19K
Какие существуют атаки на модели машинного обучения?

🔹 Атаки с изменением входных данных (Adversarial Attacks) — небольшие изменения в данных, которые заставляют модель ошибаться (например, изменение пикселей на изображении может заставить нейросеть принять панду за гиббона).
🔹 Атаки с отравлением данных (Data Poisoning) — внесение вредоносных примеров в обучающий набор, чтобы модель училась неправильно.
🔹 Извлечение модели (Model Extraction) — злоумышленник создаёт копию вашей модели, отправляя ей множество запросов и анализируя ответы.
🔹 Атаки на конфиденциальность (Membership Inference) — попытка определить, использовались ли конкретные данные в обучении модели, что угрожает приватности пользователей.
  • ❤ 5
  • 👍 2
Post #863 1.13K
  • 🥰 2
Post #862 1.11K
Что такое катастрофическое забывание (catastrophic forgetting) в нейронных сетях

Катастрофическое забывание — это явление, при котором нейронная сеть, обучаясь на новых данных, теряет знания, полученные из предыдущих данных. Это особенно критично для задач, где модель должна адаптироваться к изменяющимся условиям, например, в автономных системах, голосовых помощниках или адаптивных рекомендательных системах.

🔍 Причина проблемы:
Когда модель обучается на новых данных, её веса обновляются таким образом, что они начинают лучше соответствовать новым примерам, но при этом могут «перезаписать» ранее полученные знания, если нет механизма их сохранения.
  • ❤ 4
  • 👍 1
  • 🔥 1
Post #861 1.14K
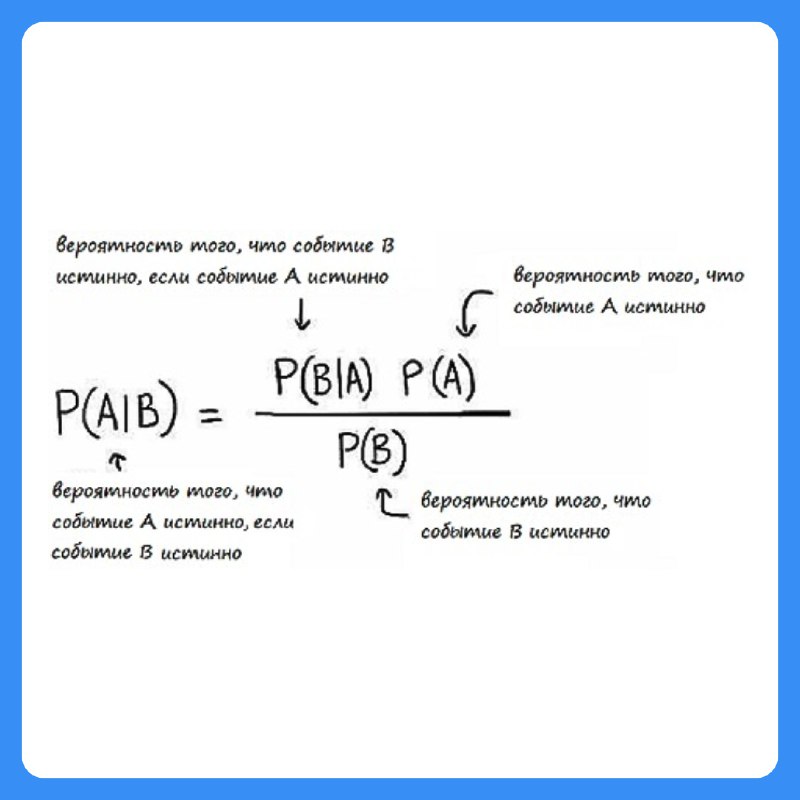
Как бы вы объяснили байесовский вывод человеку, который не знаком со статистикой

На собеседованиях по машинному обучению важно не только знать алгоритмы, но и уметь объяснять их простым языком.

Ключевые идеи байесовского вывода:

✔️ Мы начинаем с предварительных знаний о каком-то явлении (априорная вероятность).
✔️ Затем получаем новые данные, которые обновляют наше мнение.
✔️ Используем формулу Байеса для пересчёта вероятностей.

Представьте, что у вас есть зонт. Утром вы смотрите в окно: если идёт дождь, вероятность, что он продолжится, высокая. Но если в прогнозе написано, что дождь маловероятен, вы пересматриваете свою уверенность. Вы комбинируете предыдущие знания (погоду в это время года) и новые данные (прогноз, вид за окном), чтобы принять решение.
  • 🔥 4
  • 👍 3
  • ❤ 2
Post #860 1.02K
Как избежать чрезмерной оптимизации гиперпараметров (hyperparameter tuning)

Часто на этапе настройки гиперпараметров (например, с помощью Grid Search или Random Search) можно столкнуться с перенастройкой модели, что приведет к плохой её обобщающей способности на новых данных.

Как избежать переоптимизации гиперпараметров?
✅ Использовать кросс-валидацию для оценки производительности модели на разных поднаборах данных.

✅ Применять рандомизированный поиск вместо полного перебора всех вариантов гиперпараметров, чтобы ускорить процесс.

✅ Настроить ограничения на количество итераций или время оптимизации.
  • 🔥 3
  • 👍 1
Post #858 1K
🧑‍💻 Статьи для IT: как объяснять и распространять значимые идеи

Напоминаем, что у нас есть бесплатный курс для всех, кто хочет научиться интересно писать — о программировании и в целом.

Что: семь модулей, посвященных написанию, редактированию, иллюстрированию и распространению публикаций.

Для кого: для авторов, копирайтеров и просто программистов, которые хотят научиться интересно рассказывать о своих проектах.

👉Материалы регулярно дополняются, обновляются и корректируются. А еще мы отвечаем на все учебные вопросы в комментариях курса.
Post #857 980
Почему перемешивание данных может сломать модель

В машинном обучении перемешивание (shuffling) данных перед обучением модели часто считается хорошей практикой. Но в некоторых случаях это может привести к неожиданным ошибкам и ухудшению качества модели.

❗ Временные ряды → Если модель предсказывает будущее, перемешивание разрушит временную структуру. Решение: использовать time-based split.

❗ Группированные данные → Например, если данные по одному пользователю оказываются в train и test, это приведёт к утечке данных. Решение: делать групповую валидацию.

❗Последовательные зависимости → В задачах NLP или рекомендательных систем порядок данных может быть критичен.
  • ❤ 2
  • 👍 1
Post #856 705

Forwarded from Библиотека питониста | Python, Django, Flask

💾 10 способов работы с большими файлами в Python, о которых ты не знал

Годнота для всех, кто работает с данными. Статья раскрывает разные подходы к обработке больших файлов — от простых итераторов до распределенных вычислений.

👍 Сохраняй себе, точно пригодится в работе: https://proglib.io/sh/VOcgo7w0W1
  • ❤ 1
Post #855 992
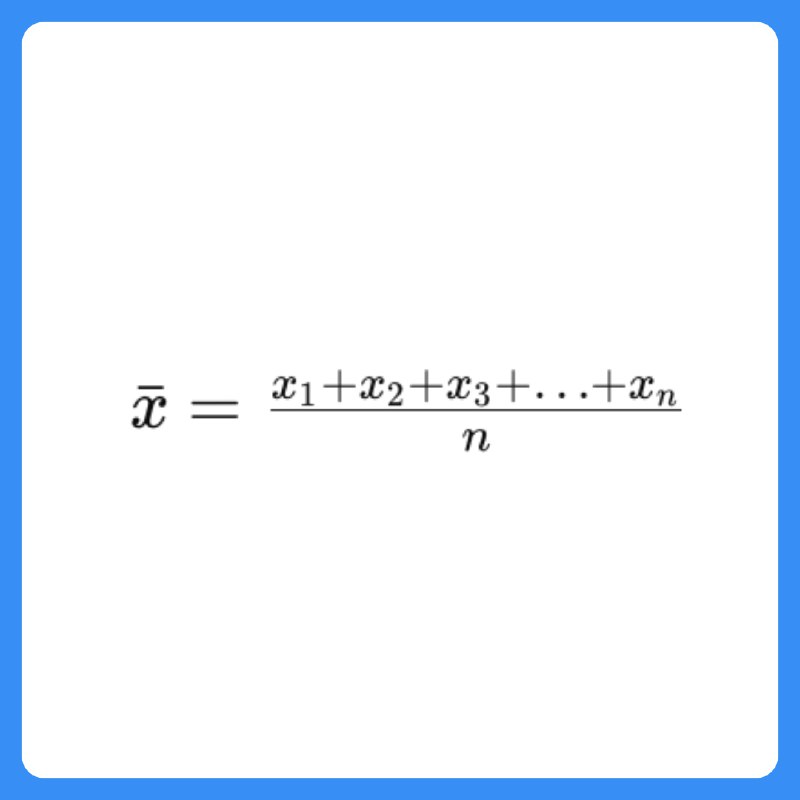
Почему среднее значение не всегда отражает суть данных

Среднее (mean) — одна из самых распространённых метрик в анализе данных, но его использование может привести к неверным выводам.

⚠️ Когда среднее вводит в заблуждение?
1. Выбросы сильно искажают результат (например, средняя зарплата в компании с одним миллиардером).
2. Смещение распределения — в асимметричных данных среднее может не отражать «типичное» значение.
3. Категориальные данные — нельзя усреднять, например, номера телефонов или географические координаты.

🔍 Что делать?
✅ Использовать медиану для устойчивости к выбросам.
✅ Смотреть на разброс данных (стандартное отклонение, IQR).
✅ Визуализировать распределение, а не полагаться только на одно число.
  • ❤ 4
  • 👍 1
Post #854 1.04K
🤔 Основы математики в Machine Learning / Deep Learning

🗓 6 марта приглашаем вас на прямой эфир, где мы подробно разберем ряд Тейлора, собственные векторы и другие ключевые понятия в ML.
(ссылка)

🌟 Спикер: *Мария Горденко* – Старший преподаватель ФКН НИУ ВШЭ, НИТУ МИСИС, аспирант департамента анализа данных и искусственного интеллекта ФКН НИУ ВШЭ, а также преподаватель на курсе Алгоритмы и структуры данных в proglib academy.


Место работы: Инженер-программист, ведущий эксперт НИУ ВШЭ, цифровой ассистент и цифровой консультант НИУ ВШЭ.


😮 На вебинаре вы узнаете:

🔵 Теорию вероятностей: обсудим случайные величины, вероятность, математическое ожидание и дисперсию.

🔵 Линейную алгебру: изучим векторы, матрицы, собственные векторы и собственные значения.

🔵 Математический анализ: разберем производные и разложение функций в ряд Тейлора.

🔵 Практику: применим полученные знания на реальных кейсах из области Machine Learning и Deep Learning.

🎯 Почему это важно?
Понимание математических основ помогает глубже разобраться в работающих под капотом алгоритмах ML/DL и эффективно применять их на практике.

👉 Присоединяйтесь к нам и совершенствуйте свои навыки в машинном обучении!

📌 Регистрация по ссылке: https://proglib.io/w/98cb734d
  • 🔥 1
Post #853 1.06K
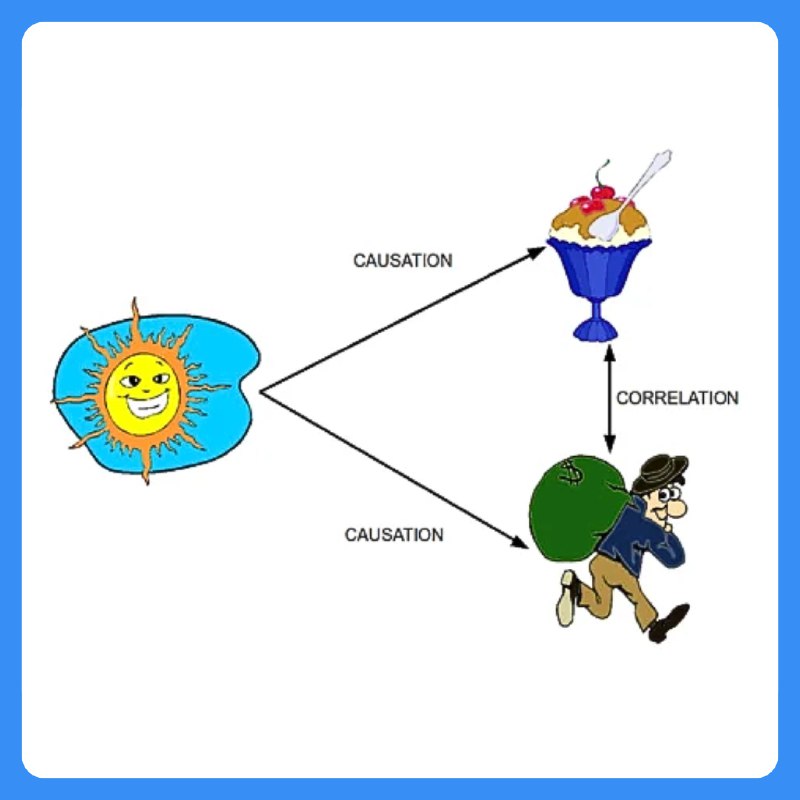
Почему корреляция не означает причинно-следственную связь

В анализе данных часто встречаются коррелирующие признаки, но это не значит, что один из них вызывает другой.

⚠️ Пример ловушки:
В жаркие дни продажи мороженого и количество утоплений растут одновременно. Их корреляция может быть высокой, но одно не вызывает другое — причиной является погода.

🔍 Как проверить причинность?
✅ Использовать эксперименты (A/B-тестирование).
✅ Применять каузальный анализ (например, метод двойных разностей).
✅ Изучать графовые модели зависимостей.
  • ❤ 6
Post #852 1.12K
Как улучшить производительность модели с помощью отбора признаков

Отбор признаков (feature selection) — это процесс выбора наиболее значимых признаков для построения модели. Это помогает улучшить её производительность и снизить сложность.

❗ Слишком много признаков может привести к переобучению и увеличению времени обучения.
❗ Неинформативные или шумные признаки могут ухудшить результаты модели.

🔧 Методы отбора признаков:
- Использование методов фильтрации (например, корреляция, тесты на значимость).
- Применение методов обертывания (например, рекурсивный отбор признаков).
- Использование методов вложений (например, Lasso или дерево решений).
  • ❤ 2
  • 👍 1
Post #851 1.13K
Почему AUC-ROC может вводить в заблуждение при несбалансированных данных

🔸 Не учитывает реальное соотношение классов — AUC-ROC показывает, насколько хорошо модель различает классы, но не отражает точность предсказаний для каждого из них. Если 99% данных — класс 0, модель может почти всегда предсказывать 0 и все равно получить высокий AUC.

🔸 Проблемы с интерпретацией — высокая AUC-ROC не всегда означает, что модель полезна. Например, если интересен именно редкий класс, важно понимать precision, recall и F1-score.
  • ❤ 6
  • ❤‍🔥 1
  • 😢 1
Older posts →
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →