TGViewer
Channel Public Channel
Библиотека собеса по Data Science | вопросы с собеседований

Библиотека собеса по Data Science | вопросы с собеседований

@ds_interview_lib

Вопросы с собеседований по Data Science и ответы на них.

Учиться у нас: clc.to/GjjbkQ

По рекламе: @tproger_sales_bot

Учиться у нас: https://proglib.io/w/7dfb7235

Для обратной связи: @proglibrary_feeedback_bot
Subscribers
4.46K
Photos
533
Videos
16
Links
660

Showing posts older than #1024 · Back to latest

Older Posts 20 shown
Post #1023 842
😱 Завтра цена на курс «AI-агенты для DS» вырастет

Пока вы думаете — другие уже покупают. Что вы теряете, откладывая решение? Как минимум — 10 000 рублей, именно столько вы переплатите завтра. Как максимум — шанс войти в топ-1% дата-сайентистов, которые умеют строить AI-агенты.

🎓 Чему вы научитесь на курсе:
— адаптировать LLM под разные предметные области и данные
— собирать свою RAG-систему: от ретривера и реранкера до генератора и оценки качества
— строить AI-агентов с нуля — на основе сценариев, функций и взаимодействия с внешней средой

Решение за вами.

👉 Купить курс по старой цене
Post #1022 749
🔎 В чём разница между доверительным интервалом и байесовским (достоверным) интервалом

Доверительный интервал (confidence interval) — это концепция из частотной статистики, где параметр считается фиксированным, а вариативность связана с данными. Например, 95% доверительный интервал означает, что при многократном повторении эксперимента 95% таких интервалов будут содержать истинное значение. Однако нельзя сказать, что с 95% вероятностью параметр лежит в этом конкретном интервале.

Байесовский достоверный интервал (credible interval) исходит из идеи, что параметр — это случайная величина. После наблюдений мы имеем апостериорное распределение, и 95% интервал означает, что с 95% вероятностью параметр лежит в этом интервале.

Библиотека собеса по Data Science
  • ❤ 3
  • 👍 1
Post #1021 788
🏃‍♀️ 1 день до конца спец предложения

У
спей впрыгнуть на курс «AI-агенты для DS» до завтрашнего повышения цены: 59.000 р. вместо 69.000 р.

🎙 Наш спикер — Никита Зелинский, Chief Data Scientist МТС, в своем канале рассказывает о RAG:

Про RAG слышали все — это уже два года самый массовый способ применения LLM в проде для бизнеса.

Это значит, что точность и надёжность такого решения достаточно предсказуемы для того, чтобы исключить человека из процесса аппрува выдачи LLM,
а связка «локально развернутая LLM + RAG над корпоративными документами» обеспечивает достаточную конфиденциальность, чтобы снять тревожность
«что наши данные попадут в OpenAI».

Эта история настолько популярна, что на рынке есть готовые RAG-решения,
а даже «маленькие» опенсорс-модели (до 5B) уже обзавелись своей RAG-ареной:
👉 https://huggingface.co/spaces/aizip-dev/SLM-RAG-Arena


Во время обучения на курсе «AI-агенты для DS» научим собирать автономные системы под реальные бизнес-задачи. На прошлой неделе мы рассказали о первом занятии.

➡️ вот что ждет слушателей курса на втором:

— Собираем свой RAG-пайплайн на своих данных
— Обсуждаем, почему качество такой системы нельзя измерять «на глаз»
— Разбираем схему LLM as a Judge и как подготовить для неё датасет
— Что такое guardrails и как они спасают от бреда
— Что делать, когда LLM не знает ответа
— Смотрим на агентский RAG и обсуждаем, можно ли использовать RAG как память агента

Если пропустили первое занятие, то вот ссылочка

❗️До повышения цены остался последний день — бронируйте место сейчас
Post #1020 756
👀 Почему one-hot encoding может быть неэффективен при большом количестве категорией

One-hot encoding создает по одному бинарному признаку на каждое уникальное значение категориальной переменной. Когда количество категорий очень велико (например, тысячи ID товаров или пользователей), возникают несколько проблем:

📍Взрыв размерности: матрица признаков становится разреженной и очень широкой, что увеличивает требования к памяти и может замедлить обучение.
📍Переобучение: модель может начать подгоняться под шум, если некоторые категории редко встречаются.
📍Потеря семантической связи: one-hot не учитывает близость между категориями — все они считаются равными и независимыми.

В таких случаях лучше использовать альтернативы:

📍Target encoding / mean encoding — замена категории на среднее значение целевой переменной для этой категории;
📍Embedding-слои — обучаемые векторные представления категорий, особенно популярны в нейросетях;
📍Frequency encoding — замена категории на частоту её появления.

Выбор метода зависит от модели и объема данных, но при большом количестве уникальных значений one-hot часто оказывается неоптимальным.

Библиотека собеса по Data Science
  • ❤ 4
  • 👍 1
Post #1019 759
👍 Когда стоит использовать логарифмирование признаков перед обучением модели

Логарифмирование признаков полезно, когда значения признаков распределены неравномерно или имеют сильную положительную асимметрию — например, в задачах с финансовыми, кликовыми или биомедицинскими данными, где часто встречаются очень большие значения рядом с малыми.

Такое преобразование:

📌 Снижает влияние выбросов, «сжимая» масштаб больших значений;

📌 Помогает сделать распределение более похожим на нормальное, что улучшает работу моделей, чувствительных к распределению данных (например, линейная регрессия);

📌 Выравнивает важность признаков, особенно если признаки входят в модель в виде произведений или степеней.

Библиотека собеса по Data Science
  • 👍 5
  • ❤ 2
Post #1018 741
😎 Пока все говорят об AI — мы учим строить системы, которые работают за вас

Что отличает топового дата-сайентиста от новичка? Умение не просто обучать модели, а создавать системы, которые принимают решения автономно. AI-агенты — это следующий уровень в DS, и мы запускаем курс по их разработке!

⚡️Если вы давно думали о прокачке скиллов или повышении грейда — сейчас самое время, потому что цена на курс вырастет уже 14 июня.

Спикер нашего нового курса — Никита Зелинский, Chief Data Scientist МТС. Его посты в канале @datarascals бьют в актуальные проблемы дата-спецов:

— Как за неделю окупить годовую зарплату одним COALESCE и получить свой quick win
— Разбор катастрофы с Precision@K или почему ваши метрики врут
— Комплексный гайд по антифроду

Поэтому на курсе «AI-агенты для DS» мы научим вас строить системы, которые не просто работают в демо, а выдерживают нагрузку реального бизнеса.

❗До повышения цены осталось 3 дня — забронируйте место сейчас
Post #1017 670
❓ Если признаки сильно коррелируют, как это влияет на Наивный Байес

Наивный Байес предполагает условную независимость признаков при заданном классе. При сильной корреляции между признаками это предположение нарушается, и модель может завышать или занижать оценки вероятностей, так как она фактически «считает» одинаковую информацию несколько раз. В результате вероятности могут быть переоценены, что снижает точность.

Тем не менее, на практике Наивный Байес часто работает достаточно устойчиво, если корреляции не слишком сильные и не искажают произведение вероятностей слишком сильно. Если известно, что признаки сильно связаны, лучше использовать более гибкие модели — например, логистическую регрессию или случайный лес. Также можно рассмотреть байесовские сети, которые позволяют явно моделировать зависимости между признаками.

Библиотека собеса по Data Science
  • ❤ 2
  • 👍 1
Post #1016 772
😡 А вас тоже бесят облачные сервисы?

Согласитесь, статус отношений с облаками — все сложно. Но что, если можно изменить правила игры?

Мы готовим нечто особенное в мире облачных технологий, но сначала хотим услышать правду от тех, кто реально работает с облаками каждый день.

❓Что мы хотим узнать:
— Для чего вы реально используете облако?
— Чего катастрофически не хватает прямо сейчас?
— Что бесит больше всего? (можно материться)
— Как выбираете провайдера — по цене или по любви?
— и тому подобное

По результатам опроса мы подготовим исследование без маркетингового мусора и вы узнаете, как обстоят дела у коллег.

⚡️Время на опрос: меньше, чем на кофе-брейк. Жмите → https://clc.to/nboYDA
Post #1015 755
👉 Почему обычно применяют dropout к выходам нейронов, а не к весам

Потому что отключение выходов нейронов (стандартный dropout) полностью исключает вклад этих нейронов в расчёты, что делает регуляризацию более надёжной и управляемой.

Альтернативный подход — занулять случайные веса (DropConnect) — может быть полезен в некоторых случаях, но он более сложен в реализации и менее распространён.

Dropout проще применить на практике и он стабильно работает во многих нейросетевых задачах.

Библиотека собеса по Data Science
  • ❤ 2
  • 👍 1
Post #1014 820
▶️ Можно ли использовать Tanh и ReLU в одной нейросетевой архитектуре

Да, в архитектурах нейросетей иногда смешивают Tanh и ReLU — и это может быть вполне оправдано.

🔹 ReLU хорошо работает в ранних слоях, способствуя разреженности и предотвращая затухание градиентов.

🔹 Tanh может быть полезен в более глубоких или специализированных частях сети — например, в рекуррентных слоях или на выходе генератора GAN, где нужно получить значения в пределах −1,1.

📌 Пример: в GAN’ах часто используют ReLU внутри генератора и Tanh на выходе — чтобы итоговые изображения были нормализованы.

Но без конкретной цели смешивать активации не стоит: это может запутать архитектуру и усложнить отладку. Всегда держите в уме, зачем вы используете каждую функцию активации.

Библиотека собеса по Data Science
  • 👍 4
  • ❤ 1
Post #1013 762
❗Вакансии «Библиотеки программиста»

Привет! Мы ищем контент-менеджеров, которые будут вести наши телеграм-каналы о разработке.

👾 Требования:
— знать принципы залетающего контента
— разбираться в темах, связанных с разработкой

Большим плюсом будет навык программирования на каких-либо языках.

✨ Условия:
— удаленка
— частичная занятость
— сдельная оплата в зависимости от количества задач

🔥 Оставляйте отклик, и мы свяжемся с вами: https://forms.gle/o4BZnsQ526JoqsCq9
  • ❤ 2
Post #1012 713
🤔 Можно ли задать одинаковые веса всем скрытым нейронам

На практике — почти никогда. В современных нейросетях это мешает обучению: все нейроны начинают вычислять одно и то же, градиенты одинаковы, и сеть не учится различать признаки. Такое поведение разрушает всю идею глубокого обучения.

Исключения есть:
• Смещения (bias) часто инициализируют нулём или 0.01
• Параметры нормализации (например, γ в BatchNorm) могут начинаться с 1

Но сами веса сети — всегда инициализируются случайно (например, Xavier или He), чтобы нарушить симметрию и позволить сети учиться.

Библиотека собеса по Data Science
  • 👍 3
  • ❤ 1
Post #1011 737
🥴 Средний разработчик меняет работу каждые 1,5 года

И это не потому, что мы такие непостоянные. Просто рынок показывает свое истинное лицо быстрее, чем успевают напечатать визитки.

Поэтому мы собираем инсайды от тех, кто находится в окопах digital-трансформации каждый день. От джуниоров, которые только въезжают в профессию, до сеньоров, повидавших всякого.

😳 О чем говорим откровенно:
— Job-hopping и что за этим стоит
— Red flags, которые мгновенно убивают мотивацию
— Реальные источники вакансий (не те, что рекламируют)
— Боль от общения с рекрутерами
— Сколько этапов отбора — норма, а сколько — издевательство

Когда мы объединим опыт сотен IT-специалистов, получится настоящая карта того, как устроена индустрия. Не по версии HR-отделов, а по версии тех, кто пишет код, тестирует продукты и двигает технологии вперед.

🚀 Участвовать в исследовании → https://clc.to/9aaXVg
  • 👍 3
Post #1010 703
✅ Как алгоритм EM оценивает параметры

Алгоритм EM (Expectation-Maximization) оценивает параметры модели в два чередующихся шага:

🔍 E-шаг (шаг ожидания):
— Рассчитывает апостериорные вероятности принадлежности каждой точки к каждому скрытому компоненту.
— То есть, на этом этапе мы «угадываем», как могла бы распределиться скрытая структура данных при текущих параметрах модели.


🔧 M-шаг (шаг максимизации):
— Обновляет параметры модели (например, средние, ковариационные матрицы, веса компонентов) так, чтобы максимизировать логарифмическую вероятность наблюдаемых данных, учитывая ожидания из E-шага.

🔁 Эти шаги повторяются поочерёдно до тех пор, пока логарифмическая правдоподобность не перестанет значительно меняться — то есть, пока не будет достигнута сходимость.

Библиотека собеса по Data Science
  • ❤ 1
Post #1009 740
😵‍💫 Как правильно выбрать LLM для использования в агентских системах

Модели могут выдумывать факты, ссылаться на несуществующие источники и уверенно врать. Особенно часто это происходит при работе с редкими языками или специфическими тематиками.

Поэтому на первом занятии курса «AI-агенты для DS-специалистов» разберем, как с этим бороться. И это только первый из пяти уроков!

🔍 Выбор правильной модели
Не все LLM одинаково полезны. Обсудим квантизованные модели, instruct-версии и мультилингвальные решения. Узнаем, где больше галлюцинаций — в базовых моделях или после дообучения.

💰 Токенизация и стоимость
Разные языки «съедают» разное количество токенов. Покажем, как это влияет на цену API и почему русский текст может стоить дороже английского.

⚡️ Температура и Guardrails
Настройка temperature помогает контролировать креативность модели. А системы Guardrails — отсекать неподходящие ответы еще до генерации.

🧠 Память vs контекст
Казалось бы, зачем RAG, если есть модели с контекстом более 10М токенов? Но не все токены равнозначны. Разберем, когда внешние источники все еще нужны.

В конце создадим простых агентов на LangChain с подключением к внешним источникам и инструментам поиска — и у вас уже будет кейс по созданию собственного AI-агента.

👉 Присоединяйтесь к курсу — приятная цена действует до 14 июня!
Post #1008 739
🗑 Нужно ли автоматически удалять один из признаков, если они сильно коррелируют

Не всегда — всё зависит от цели вашей модели.

🎯 Если важна точность предсказаний:
— Современные алгоритмы машинного обучения (например, Random Forest, градиентный бустинг, нейросети) достаточно устойчивы к мультиколлинеарности.
— Если оба признака способствуют улучшению метрик — удалять не обязательно.

🧠 Если важна интерпретируемость (например, в линейной регрессии):
— Сильно коррелирующие признаки могут делать модель нестабильной и затруднять интерпретацию коэффициентов.
— В этом случае удаление одного признака может упростить модель и сделать её более надёжной.

🔎 Как подойти на практике:
1. Проверьте через кросс-валидацию, ухудшается ли качество модели при удалении одного признака.
2. Используйте предметные знания, чтобы определить, не измеряют ли оба признака одно и то же.
3. Вместо удаления можно применить регуляризацию (например, L1 или L2), чтобы модель автоматически уменьшала влияние избыточных признаков.

Библиотека собеса по Data Science
  • ❤ 4
  • 👍 2
Post #1007 664
🫣 Устали от HR-сказок про «дружный коллектив» и «печеньки в офисе»?

Давайте честно поговорим о том, что действительно происходит на IT-рынке. Не в розовых презентациях, а в реальной жизни разработчиков, тестировщиков, аналитиков и всех, кто живет кодом.

🧐 Мы проводим исследование, чтобы выяснить:

— Как часто мы прыгаем между компаниями (и почему)
— Какие красные флаги заставляют бежать без оглядки
— Где реально находят работу
— Что бесит в HR больше всего
— Сколько кругов собеседований — это уже перебор

Результаты покажут реальную картину рынка. Без приукрашиваний. Может, компании поймут, что нужно менять, а специалисты — куда двигаться дальше.

😈 Опрос займет 5 минут, но результаты будут работать на всех нас → https://clc.to/9aaXVg
Post #1006 727
👇 Как обрабатывать крупномасштабные датасеты с иерархической кластеризацией, учитывая её высокую вычислительную стоимость

Иерархическая кластеризация в наивной реализации плохо масштабируется и становится крайне ресурсоёмкой при работе с большими объёмами данных. Однако существуют эффективные стратегии:

🔧 Приближённые или гибридные методы:
1️⃣ Использование mini-batch иерархической кластеризации, где анализируется не весь набор данных, а его небольшие случайные подвыборки.
2️⃣ Применение предварительной кластеризации (например, алгоритмом k-Means), чтобы разбить данные на подгруппы, а затем применить иерархическую кластеризацию только к центроидам этих кластеров. Это снижает объем вычислений, сохраняя структуру на высоком уровне.

⚙️ Оптимизированные структуры данных:
1️⃣ Использование KD-деревьев или Ball-деревьев может ускорить операции поиска ближайших соседей, особенно при агломеративной кластеризации.
2️⃣ Некоторые библиотеки, такие как Scipy или fastcluster, используют улучшенные алгоритмы и эффективное хранение расстояний, чтобы ускорить вычисления.

📉 Снижение размерности данных:
1️⃣ Применение методов снижения размерности (например, PCA, t-SNE, UMAP) перед кластеризацией может значительно уменьшить вычислительные издержки и упростить структуру данных.

Библиотека собеса по Data Science
  • ❤ 2
  • 👍 1
Post #1005 692
🤔 Почему ИИ-агенты — технологический тренд №1 в 2025 году?

Так заявил сам
Gartner, а эксперт нашего курса по AI-агентам Никита Зелинский @datarascals объяснил, почему:
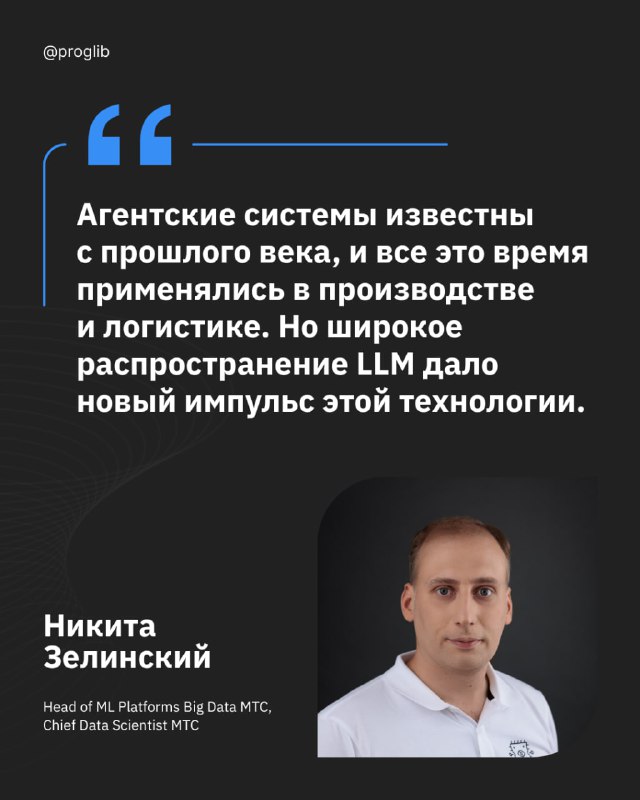
Агентские системы известны с прошлого века, и все это время применялись в производстве и логистике. Но широкое распространение LLM дало новый импульс этой технологии в двух направлениях.

Во-первых, LLM стали использовать как универсальный оркестратор агентов. Это означает, что под каждый входящий запрос система составляет последовательность действий — планирует пайплайн, который состоит из применения различных инструментов или обращения к другим агентам, с возможными циклами и обращениями к общей памяти (с возможностью не только чтения но и записи / удаления).

Во-вторых, LLM служат инструментом, который позволяет легко настраивать системы на тысячи агентов на естественном языке.


Поэтому на первом занятии курса «AI-агенты для DS-специалистов» мы рассмотрим, как выбрать конкретную LLM с учетом имеющихся ограничений и как оценить стоимость такого решения.

Остаться без денег неожиданно легко — Никита сам столкнулся с тем, что генерация всего 70 тестовых вопросов для RAG-системы через GPT-4o обошлась в 30 долларов... Будем разбираться, как этого избежать и не только!

🤓 В следующем посте расскажем, как правильно выбрать LLM для использования в агентских системах.

👉 А пока — приходите на наш курс по AI-агентам. Приятная цена действует до 14 июня!
  • ❤ 1
Post #1004 789
🌸 Как признаки, извлечённые автоэнкодером, соотносятся с другими методами выделения признаков

Признаки, полученные с помощью автоэнкодера, обладают рядом преимуществ и недостатков по сравнению с традиционными методами:

🛠 По сравнению с вручную созданными признаками (handcrafted features)

Преимущества:
✔️ Автоэнкодеры автоматически извлекают признаки из данных, без необходимости ручного проектирования.
✔️ Могут адаптивно подстраиваться под специфические закономерности в данных, что особенно ценно в сложных или плохо изученных предметных областях.
✔️ Хорошо работают с высокомерными и шумными данными.

Недостатки:
🙅‍♂️ Требуют большого объёма данных для эффективного обучения.
🙅‍♂️ Полученные признаки зачастую трудно интерпретировать, особенно без специальных визуализаций или декодеров.

📉 По сравнению с линейными методами, такими как PCA (анализ главных компонент)

Преимущества:
✔️ Автоэнкодеры способны выявлять нелинейные зависимости, в то время как PCA ограничен линейными проекциями.
✔️ Гибкость архитектуры позволяет моделировать сложные структуры данных, выходящие за пределы линейных подпространств.
✔️ Возможность применения модификаций (например, вариационных, спарс-, денойзинг автоэнкодеров).

Недостатки:
🙅‍♂️ Более трудоёмкие вычислительно, требуют настройки гиперпараметров и структуры сети.
🙅‍♂️ Чувствительны к переобучению и ошибкам в архитектуре.
🙅‍♂️ Могут запоминать вход, не извлекая полезных обобщённых признаков, если плохо обучены.

Библиотека собеса по Data Science
  • ❤ 3
  • 👍 2
Older posts →
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →