TGViewer
Channel Public Channel
C# Short Posts 🔞

C# Short Posts 🔞

@dimasshortposts

Здесь я, Дима Афонченко @Undermove1, публикую короткие заметки о разработке (и около). Я не претендую на правильность высказываний и открыт к дискуссиям, исправлениям и конструктивной критике. С любыми деструктивными вещами можно приходить в комменты)
Subscribers
306
Photos
206
Videos
7
Links
211

Showing posts older than #457 · Back to latest

Older Posts 11 shown
Post #455 442
🗄 Оперативное 1: shared_buffers — личный кэш Postgres

В обзорном посте про оперативку постгресса мы насчитали трёх «едоков» памяти. Начнём с первого: shared_buffers. Разберёмся, что это такое и почему он всегда выглядит занятым.

😂 Что это вообще
Как многие знают, Postgres не бегает на диск в каждом запросе. У него есть свой кэш — кусок оперативки, куда он складывает страницы (напомню, что это кусочки по 8 Kb), которые недавно понадобились, чтобы в следующий раз взять их из памяти. Вот этот кэш и есть shared_buffers.

Слово shared («общий») тут ключевое: буферы общие для всех соединений. Один запрос читает страницу с диска и кладет в shared_buffers, а следующий возьмёт её уже из памяти и диск не тронет. (Напомню, что даже на самых мощных SSD разница скорость чтения 10-20 микросекунд, тогда как из оперативки это 50-60 НАНОсекунд, то есть капец как дешево)

📏 Сколько его
Размер задаёт параметр shared_buffers, и фиксируется он при старте сервера. По умолчанию в Postgres это всего 128 MB — наследство времён, когда памяти было мало. На боевом сервере его обычно поднимают примерно до четверти всей оперативки. Текущее значение покажет команда SHOW shared_buffers;

⚙️ Почему он всегда «занят»
Эти 128 MB (или сколько ты выставил) Postgres резервирует под кэш сразу при запуске и держит за собой всё время работы. Поэтому в мониторинге shared_buffers всегда показывает себя занятой памятью. Это не утечка и не повод хвататься за сердце 😰: память заранее отведена под кэш и работает на тебя.

🔬 Что внутри
Что именно сейчас лежит в shared_buffers, показывает расширение pg_buffercache (его надо один раз подключить командой CREATE EXTENSION pg_buffercache).

На прогретой таблице users из миллиона строк (прогретой — значит по ней уже погоняли запросы, и её страницы успели осесть в кэше) у меня вышло так:

🟢 сама таблица заняла 47 MB
🟢 индекс по email — 39 MB
🟢 индекс первичного ключа — 21 MB.

Два индекса вместе съели больше кэша, чем данные! Это частый сюрприз: спрашиваешь «куда ушла память под базу», а ответ нередко оказывается простым — в индексы.

🅰️ Что унести с собой

🟢 shared_buffers — это собственный кэш Postgres в оперативке, общий для всех соединений.
🟢 Его размер фиксируется при старте: по умолчанию 128 MB, на проде обычно около четверти RAM.
🟢 Он всегда выглядит занятым, и это нормально: память заранее отведена под кэш.
🟢 Индексы живут в том же кэше, что и данные, и порой занимают даже больше места.

#бд #postgresql #инженерныештучки #heavywednesday
  • 🔥 3
  • 🙏 3
Post #454 365
Как стримить данные в ASP.NET и как их принять

Бахнул небольшую статейку про стриминг на хабр. Постарался чуть более подробно и просто рассказать про самые основные способы, которые есть.

➡️ Читать тут ⬅️

Немного в ней дополнил то, что было в постах и чуть лучше распиал и проанимировал объяснения.

Ну и накидайте плюсиков, если понравится, это меня очень промотивирует делать такие статьи и дальше 👍
  • ❤ 5
Post #453 562
Среда - маленькая пятница, так что отдыхаем, мои чуваки

#heavywednesday
  • ❤ 2
  • 👾 1
Post #452 646
☺️ А у меня локально не работает!

Если долго меня читаете, то может слышали, что есть у меня такой пет-проектик для изучения языков — тралебот.

Я его сейчас довольно активно развиваю, ну и разумеется, пользуюсь им сам. 🐶

Проснувшись однажды утром после беспокойного сна, я обнаружил, что у меня в постели тралебот превратился в страшный овощ, а конкретно в тыкву.

Мини-апп не грузится. Первая мысля — че-то не так с сертом. Зашел с браузера — с сертом все норм, но запрос таймаутит. При этом, что удивительно, все боты на сервере на мои запросы отвечают. С другой стороны подключитсья к нему по SSH не получается 🙁 Что еще страннее — панель Hostinger'а не показывала никаких смертельных аномалий ☢️ (опасных мутантов, анархистов и бандитов)

ТО есть сервак явно работает, но достучаться я к нему не могу. WTF?

Перед тем как расскажу, что там случилось, вот вам вопрос на засыпку, как думаете что случилось и как такое дебажить?

———

Подумали? Тогда погнали разгребать, потому что в то утро я честно прошёл все пять стадий принятия.

📓 Первым делом грешу на серт — ну а на что ещё. Проверяю, а он живёхонький, Let's Encrypt, до августа дышать и дышать. Окей.

DNS резолвится. А у меня все равно отвалилось разом всё: и 443, и 80, и SSH, и даже порт кубера.

Лезу через аварийную консоль Hostinger. А там... всё шикарно! Сетевуха поднята, IP на месте, файрвол выключен, в логах ядра тишина, аптайм месяц. Сервер здоров как бык 🐄

Короче, в такой ситуации на увроне интуиции хочется попробовать зайти из другого места. И это правильная интуиция. Но как?

🅰️А вот как! Есть такой сервис — check-host.net.

Скармливаешь ему свой домен, и он одновременно дёргает его из двух-трёх десятков стран разом: Германия, США, Бразилия, Япония, Сингапур, Турция, Казахстан, Израиль... пингует и стучится на 443 с каждой точки и рисует табличку — откуда открылось, а откуда нет.

Жму. И табличка показывает: 24 из 25 точек по миру открывают мой сайт. Германия — 13 миллисекунд, Нидерланды вообще 5. Не открывается ровно одна точка на всём глобусе — Грузия. Собственно та, где и нужен доступ к боту который учит грузинскому языку 😂

И проблема только у моего провайдера Silknet. На самом деле такое уже бывало, причем из разных локаций были проблемы с доступом.

Ок, разобрались, как можно такое детектить. Вопрос как такое чинить?

Вот тут самое вкусное лично для меня. Я ради такого и заводмл пет-проекты – чтобы сталкиваться с такими проблемами и учиться их решать. Так вот оказывается это можно решить с помощью Cloudflare!

1️⃣ Заводишь бесплатный аккаунт на Cloudflare, добавляешь свой домен — он сам сканит твои DNS-записи и подтягивает их. Там лимит 100к запросов в день. Мне за глаза хватит.

2️⃣ Проверяешь, что записи на месте (A на айпишник сервера и CNAME для www), и оставляешь их «проксируемыми» — это оранжевое облачко напротив записи, оно и значит «гнать трафик через нас».

3️⃣ У регистратора (у меня это Hostinger) меняешь NS-серверы на те два, что выдал Cloudflare. Дальше ждёшь, пока смена разъедется по миру — обычно меньше часа.

4️⃣ В разделе SSL/TLS ставишь режим Full — чтобы Cloudflare и с посетителем, и с твоим сервером общался по https. Всё.

🅰️ А что это в итоге даёт:

➕ Обход битых маршрутов. Посетитель теперь идёт не в мой дата-центр напрямую, а на ближайшую точку Cloudflare (их сотни по миру), и уже она тянется до сервера своей магистралью — мимо обрыва у Silknet. Ровно то, что мне было нужно.

➕ Бесплатный сертификат, который Cloudflare сам выпускает и сам продлевает — про ручной Let's Encrypt можно забыть.

➕ Спрятанный реальный IP сервера: снаружи виден только Cloudflare, прямой долбёж по айпишнику уже не прилетит.

➕ Бонусом — кэш статики и базовая защита от мусорного трафика, хотя мне сейчас был дорог именно обход.

Короче, абсолют синема! Теперь у меня тралебот ебать какой взрослый!

#petproject #devtools #devlife
  • 🔥 5
  • ❤ 2
Post #450 515
В прошлых постах мы довольно тщательно разобрали структуру индексов, и нам осталось разобраться, откуда происходит чтение как данных, так и индексов: из диска, или из оперативки, или «зависит»?

📚 Несколько кэшей
Представь, что ищешь нужную книгу: она может быть на твоём рабочем столе — прям под рукой, очень близко; или на полке рядом — на шаг дальше; или вообще в книжном шкафу в другой комнате — туда топать дольше всего. Память под страницы у СУБД устроена такими же уровнями, и за страницей она идёт по ним сверху вниз:

1️⃣ shared_buffers — рабочий стол. Собственный кэш СУБД, она сама им рулит. В Postgres по умолчанию всего 128 MB.
2️⃣ кэш ОС (page cache) — полка рядом. Операционка сама держит в RAM файлы, которые недавно читала; СУБД им не управляет, но пользуется.
3️⃣ диск — шкаф в другой комнате.

Глянула 1️⃣ shared_buffers → нет → 2️⃣ спросила ОС, та смотрит, что есть в RAM → нет → идем на 3️⃣ диск Найденную страницу обычно кладём обратно в shared_buffers, чтобы следующий запрос взял её уже оттуда.

🧩 Данные и индексы — в одном кэше
Тут есть контр-интуитивный момент: и куча с данными (heap — страницы, где лежат сами строки таблицы), и индексы (страницы с элементами дерева) лежат в одном shared_buffers, конкурируя за место. Отдельной «памяти под индексы» нет 🤯

🌳 Почему индекс будто всегда в RAM
Верхушка B-дерева (корень и внутренние узлы) — набор страниц, который дёргает каждый поиск. Из-за частых переходов по дереву верхние уровни почти всегда в кэше, так как с них начинается почти любой поиск, поэтому дочитывать чаще приходится только лист и/или саму страницу кучи.

🔬 Пощупаем (дикпик 1)
EXPLAIN (ANALYZE, BUFFERS): секция BUFFERS показывает, сколько страниц нашли в shared_buffers (hit), а сколько пришлось дочитывать (read).
Холодный поиск по PK на таблице в 1 млн строк, у меня в эксперименте: shared read=4 — три страницы индекса плюс одна кучи, всё мимо кэша.
Повтор: shared hit=4 — всё в shared_buffers диск не трогали, время заметно меньше.
Ищем другой далёкий id: hit=1 read=3 — корень уже в кэше с прошлого раза, поэтому он был переиспользован.

⚠️ Тонкость: read ≠ обязательно диск
«read» здесь значит лишь «не было в shared_buffers». Но страница могла прилететь мгновенно от ОС, а не из диска.
Отсюда неочевидное: два запроса с одинаковым read могут идти с разной скоростью — в одном случае страница пришла с диска, в другом уже лежала в кэше ОС.

🧑‍💻 Как это использовать в работе
1. Первый запрос после рестарта PostgreSQL (или сервера) обычно медленнее: кэш пустой, он наполняется заново. Это так называемый «холодный старт».
2. Index Only Scan (когда всё нужное есть в самом индексе и в кучу за строкой идти не надо) экономит не только чтения, но и кэш: чем меньше heap-страниц тащим в shared_buffers — тем больше места остаётся другим.

Команды из дикпика — в 👉 гисте 👈

Дальше разберём, куда девается оперативка, когда её внезапно «съели» под 99%, и как это диагностировать 👉

🧑‍💻dp 🥁
#бд #postgresql #инженерныештучки #heavywednesday
  • ❤ 2
Post #447 561
📘 На гребне листа. Стриминг вместо ToList. Часть 3: когда стримить НЕ надо

Прочитав оригинальную статью, хочется встать и переписать все свои ToList на IAsyncEnumerable — и будет тебе счастье. И действительно, если накидать бенчмарк — память реально падает. Ну как бы тут сомнений не было.

Лавочная марка (она же бенчмарк):
Потестил на одних и тех же данных через k6, 8 клиентов, 12 секунд, ответ ~47 МБ на каждый запрос у всех (пояснительный дикпик 1 👆):

🍑 Пик памяти: буфер (ToListAsync) — 1483 МБ, NDJSON — 557 МБ, SSE — 208 МБ
🍑 Время до первого байта: буфер — 1.34 секунды, стримы — десятки миллисекунд
🍑 Пропускная способность — у всех примерно одинаковая

Если залимитить рост памяти то буфер вообще падает с OutOfMemoryException, пока стримы спокойно отдают свои 117 МБ. Казалось бы — всё, бежим переписывать!

Но мне в голову пришло пару моментов.

1️⃣ Медленный консюмер. Пока он по чуть-чуть вычитывает ответ, сервер держит открытым соединение с базой всё это время. Пул в 3 соединения, 5 медленных клиентов — и стрим лёг: 3 отдались, 2 отвалились (пояснительный дикпик 2 👆).

Буфер же прочитет всё залпом и отпустит. Под медленного клиента он ведёт себя приличнее. И ещё важно, при стриминге на забыть AsNoTracking и выключить retry у EF — иначе «стрим» тихо превращается обратно в буфер.

Ну а если ответы повторяют свое сожержание, то тут как будто можно обойтись простым кэшированием.

2️⃣ Cтримить всё подряд и не надо. Если задача «отдавай по 10–20 статей по мере прокрутки», то обычная пагинация поверх ToList зайдёт куда лучше: нет никакой беды загрузить одну страницу в память, зато отдаётся быстро и мелко, даже если клиент тормозит. Бери keyset — курсор по последнему id, без OFFSET, прямо по индексу (пояснительный дикпик 3 👆).

Короч, статья подаёт стриминг, как оптимизацию памяти, которую как бы можно натянуть на каждый ToList. Но по сутивсе же стриминг — это не совсем «оптимизация памяти». Это один из способов реализовать бизнес-логику, которая заодно экономит память — но только если твой кейс под него заточен. Вот там у автора как раз так и было. Там типа логи стримились.

🅰️ Итого вот что я понил:

🦄 Стриминг реально снижает нагрузку на память — отдаём по строке, весь набор в куче не держим.

🦄 Но аккуратнее с медленными читателями: они форсят удержание соединения с базой, и пул недолго выжрать.

🦄 Пагинация — зачастую нормальный компромисс: и память не грузит, и пишется легко на голом ToList. И кэшики можно добавить если что. Для интерактивных списков это не зашвкарно короче. Но полезно понимать то как память с ними работает.

🦄 Стриминг стоит выбирать от бизнес-кейса (онлайн-логи, ответы LLM на лету, прогресс), а не «ради оптимизации памяти». Память он экономит — но это приятный бонус, а не повод.

#aspnet #dotnet #performance
  • 💯 3
  • 🤝 2
Post #444 513
Мы с тобой уже довольно сильно углубились в тему деревьев, главное - не забрести в дремучий лес (ба-дум-тсс🥁). Не переживай, скоро мы выберемся отсюда, а пока что:

🌳 Как B-дерево держит себя ровным и какая у него максимальная высота

⚖️ Balanced — это про что
Если помнишь, одно из толкований буквы B — Balanced, то есть их ещё называют сбалансированными деревьями. Эта сбалансированность заключается в том, что все листья лежат на одной глубине, любой путь от корня до листа одинаковой длины. Нет веток разной глубины, в которые можно надолго провалиться, — поэтому любой спуск к данным стоит одинаково 🟰

🤩 А как у других?
В двоичных деревьях (AVL, красно-чёрных) после вставки одна ветка может стать длиннее другой, и дерево «чинит» себя поворотом: берёт перекосившую тройку узлов и локально переставляет их — бывший потомок становится родителем, поддеревья перевешиваются, высоты выравниваются. Делает это сама структура, на каждой вставке и удалении. Поворот — это их способ оставаться ровными 🔁

🪨 Как поддерживается баланс (видео-дикпик 📱)
B-дерево балансируется без поворотов — делением переполненной страницы (split):
1️⃣ лист наполняется ключами, пока не переполнится;
2️⃣ переполнился — делится надвое (split), а пограничный ключ копируется наверх, к родителю, и становится новым разделителем (по нему потом и выбирают, в какую из половин спускаться);
3️⃣ если переполнился сам корень — он тоже делится на два узла, которые становятся внутренними, потому что сверху над ними встаёт НОВЫЙ корень (появляется новый уровень).
Таким образом дерево не удлиняет отдельные ветки, а растёт вверх равномерно. Возникает резонный вопрос:

📏 Сколько вообще может быть уровней?
Жёсткого лимита в Postgres нет, но из-за большого ветвления высота по int растёт еле-еле:
🔹 2 уровня — до ~100 тыс. строк
🔹 3 — до ~30 млн
🔹 4 — до ~8,5 млрд
🔹 5 — до ~2,4 трлн

А выше упирается в потолок физического хранения таблицы. У каждой строки есть физический адрес: номер блока + слот внутри блока. Номер блока 32-битный, значит блоков максимум ~4,3 млрд (2^32), а в один блок 8 KB влезает примерно 291 строка. Перемножаем 4,3 млрд страниц × 291 запись ≈ 1,2 трлн строк, и больше в таблицу не поместится: для новой строки просто не останется свободного адреса 📍

Пятиуровневое дерево может вместить до ~2,4 трлн ключей, а строк в таблице будет не больше ~1,2 трлн. Таблица кончится раньше, чем дерево заполнит пятый уровень и запросит шестой. Поэтому индекс по int на практике — это 2–5 уровней, и выше пяти не вырастет: столько строк в одну таблицу физически не положить 🛑

🔬 Посмотрим на живом примере (дикпик 1)
Растим таблицу с первичным ключом и смотрим высоту через bt_metap.

Рост в 10 000 раз добавил ровно ОДИН уровень. А точечный поиск всё ещё требует единицы чтений: «корень → ветвь → лист → строка». И столько будет как на тысяче строк, так и на десяти миллионах ✨

🎢 Что это даёт по скорости
Сложность поиска по такому дереву - O(log n), потому что поиск = спуск от корня до листа, то есть ровно столько шагов, сколько в дереве уровней (высота). А высота для дерева с ветвлением f и N записями — это примерно log по основанию f от N.
И в этом весь смысл баланса: если бы split не поддерживал все листья на одной глубине, дерево могло бы выродиться в почти линейную цепочку — и поиск стал бы O(n), то есть потребовались бы миллионы чтений, от которых индекс и спасает 🛟

🅰️ Что унести с собой
🔹 Поиск по индексу — O(log n), потому что большое ветвление держит дерево низким, а split гарантирует одинаковую глубину листьев.
🔹 Это гарантия худшего случая, а не «в среднем»: split держит все листья на одной глубине, поэтому длинных веток просто не бывает.
🔹 Точечный поиск по индексу почти «бесплатный» — что на тысяче строк, что на сотне миллионов это несколько уровней дерева.

Команды, чтобы самому замерить высоту на разных размерах, — в 👉 гисте 👈

🧑‍💻dp 🥁
#бд #postgresql #инженерныештучки #heavywednesday
  • 🔥 3
  • 👾 1
Post #443 314
🤖 C# стараются сделать удобнее для агентов чем для людей

Послушал тут новый выпуск дотнет подкаста. Никогда бы не подумал, что мне понравится слушать про изменения в unsafe, но тут оно действительно инетересное.

Если вдруг забыли то unsafe это такой оператор, который позволяет вам включить всякие фичи, которые работают с памятью напрямую.

Типа пишем unsafe и можем прям в память смотреть через stackalloc.


unsafe {
int* ptr = stackalloc int[3] { 10, 20, 30 };
Console.WriteLine($"{ptr[0]}, {ptr[1]}, {ptr[2]}");
}


Вы наверное думаете, что вам оно не нужно знать, что это такое и вы этим не пользуетесь. Но боюсь, что вы пользуетесь, просто не знаете об этом. Так или иначе, если юзаете ASP.NET, то там под капотом все unsafe-ное.

Так вот дело в том, что теперь код функций с ансейфом нужно будт помечать, что будет форсить компилятор предлагать вам помечать такой код блоком unsafe тоже.

И это круто, так как раньше вы могли запросто воспользоваться каким-то небезопасным методом, даже не зная про это и потом немного не понять, а что же там такое происходит.

Вот начиная с C# 16 можно будет включить проверку, которая запретит так делать.

Но самое припольное не сам факт безопасности! Самое интересное в том, а зачем это сделали! Дело в том, что сделали это не ради кожаных, а ради агентов. То есть идея такая, чтобы агент при использовании небезопасного метода получал ошибки компиляции, и сразу подмечал все особенности с этим связанные.

Помню как-то год назад видел дискусии на тему, а какой язык нужен для LLM? И там в основном говорили про Python так как типа на нем больше всего обучения было у моделек. Но в агнетном мире кажется, что побеждает язык у которого компилятор дает наибольшее количество информации о том, что что-то написано не по плану.

Прикольно что шарпик идет в эту сторону и база при этом у него довольно хорошая.
YouTube Обезопашивание небезопасности, освоение метрик, битва архитектур Подкаст RadioDotNet выпуск №137 от 8 июня 2026 года Разговоры на тему .NET во всех его проявлениях, новости, статьи, библиотеки, конференции, личности и прочее интересное из мира IT. В этом эпизоде вы можете услышать историю про наш совместный митап от…
  • 😱 4
  • ⚡ 2
  • 🦄 2
Post #442 285
Привет друзья! Вы наверное заметили посты помеченные зелеными жабами. Все дело в том, что мы решили заколбиться со Степой Гранкиным @drummer_programmer для ведения канала.

Степа сейчас активно погружается в БД и мне показалось, что будет прикольно обмениваться знаниями. Мы пообменивались, и пришла идея, что и делиться ими с вами тоже будет интересно)

Так что по средам тут теперь пропишется колонка Степы с названием Heavy Wednesday. Думаю, что со временем там будет не только про БД но и про всякое хардовое!

Ну и приятно, что канал начинает чтить традицию жабных сред. Мне она очень нравится, но я как-то не чувстовал в себе дисциплины на такое. Так что теперь жабам быть! 🐸
  • ❤ 5
  • 👍 3
Post #440 390
🧵На гребне треда. Стриминг вместо ToList. Часть 2: NDJSON

В прошлой части был SSE — белый человек: всё «из коробки», фронт даже не парится. Так вот NDJSON — его всратый, но обаятельный брат. Формат простой до неприличия, зато гибкий и лезет куда угодно. Только на фронте, не обессудьте, придётся изрядно повозиться.

Что это вообще. NDJSON = Newline-Delimited JSON, и весь «стандарт» умещается в одну фразу: один JSON-объект на строку, разделяем переводом строки. И более ничего-с. Строка — объект, \n, строка — объект. Так отдают логи, дампы, bulk-эндпоинты эластика и половина LLM-стримов. Гениально в своей простоте.

🔼 Как отдать с бэка

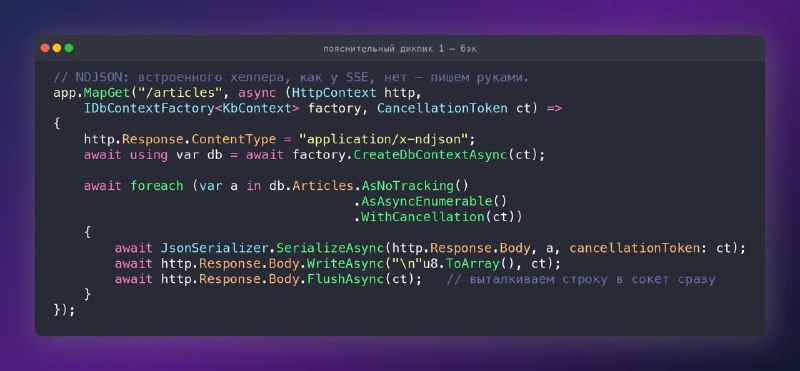
Тут, в отличие от SSE, хелпера тебе не завезли — извольте ручками. Но ручками — это буквально три строки в цикле: сериализовал → дописал \n → флашнул (пояснительный дикпик 1 👆). И этот ручной flush я даже зауважал: сам решаешь, когда строка улетает в сокет, и тут же предаёшь её забвению. Ничего не копится, совесть чиста.

⬇️ Как принять на фронтенде

Тут все плохо. Встроенного парсера, как EventSource у SSE, нет — браузер с поклоном сообщает «разбирайтесь сами-с». Берёшь fetch, у ответа есть body — это поток, читаешь кусками через getReader. Тут еще такой момент: сетевые куски прилетают как попало — может прийти полторы строки, может половина. Поэтому нужно копить в буфер, а потом резать по \n, целую строку — в JSON.parse, и так далее (пояснительный дикпик 2 👆).

В целом выглядит так что сами протоколы как бы не особо любят стриминг. Вроде есть мелкие либы вроде ndjson-readablestream, но у нее всего вот 17 звезд.

Зачем тогда NDJSON, если SSE удобнее?

Есть ряд плюсов:

➕ лезет куда угодно — обычный POST, любые заголовки, любой клиент. SSE через EventSource умеет лишь голый GET без хедеров (пожелал токен в заголовке — а вот вам, сударь, шиш с маслом). NDJSON-у же решительно всё равно, чем его потчуют.

➕ читается глазами — открыл curl-ом, видишь строки, дебажишь безо всякого камлания с бубном.

➕ не привязан к браузеру — мобилка, бэк-ту-бэк, питон-скрипт вкушают его одинаково охотно.

Но всегда есть какое-то НО. И у NDJSON это НО имеет довольго большие объемы.

➖ нет ни парсера, ни авто-реконнекта — всё сам либо библиотекой.

➖ нет именованных событий: угодно типы (мета / элемент / конец) — тегируй строки полем type собственноручно.

➖ не «стандарт», а джентльменское соглашение: клиент с сервером обязаны загодя условиться о мелочах, иначе всё рассыплется.

🅰️ ИТОГО: По памяти NDJSON выходит экономнее, но по удобству в общем так себе. SSE пока все же выглядит предпочтительнее, если стримить нужно на браузер. Однако для стриминга на что угодно это все же первый кандидат.

#aspnet #dotnet #performance
  • 💘 3
  • ⚡ 2
Post #437 539
🌳 B+-tree: что значит буква B и что значит «+»
В прошлых постах мы с тобой разобрали страницы (👉 раз), увидели, как индекс спасает от Seq Scan (👉 два), и пощупали B-дерево изнутри — корень, разделители, листья (👉 три). Дальше разберёмся, что значит «B», чем B+-дерево отличается от B-дерева, как оно держит себя ровным, и какая сложность поиска по нему🔎

🔤 Что значит 🅱️
Точного ответа нет💁 Структуру B-дерева придумали Рудольф Байер и Эдвард МакКрейт в Boeing Research Labs в начале 70-х, но что означает B — авторы так и не объяснили. Варианты: Balanced, Bayer (фамилия), Boeing (фирма), а ещё broad, bushy, и даже between. По воспоминаниям МакКрейта, Байер шутил: «чем больше думаешь, что значит B в B-tree, тем лучше понимаешь B-tree» (по крайней мере, такая история в вики). Так что «B = balanced» — логичное предположение, но оно не подтверждено разработчиками¯\_(ツ)_/¯

➕ А вот «+» — уже не загадка
Это и есть главное отличие от классического B-дерева, в котором данные могут находиться как во внутренних узлах, так и в листовых. B+-tree, на котором основаны индексы в популярных СУБД (PostgreSQL, MySQL, MongoDB, SQL Server), устроено немного иначе:

🟢 Данные (в случае PostgreSQL, ctid — указатели на строки) живут только в листьях. Внутренние узлы хранят одни ключи-разделители: чистое «оглавление», маршрут до листа. Те самые «≥ 367 → блок 2» из этого поста.
🟢 Листья сцеплены в связный список. Поэтому поиск по диапазонам (>, <, BETWEEN) работает достаточно быстро: спустился до листьев и побежал по ним подряд, не возвращаясь наверх (см. дикпик 3). Тот же список бесплатно даёт и упорядоченный обход: ORDER BY может выполняться через последовательный обход индекса без дополнительной сортировки (но оптимизатор не всегда выбирает индексный проход).
В классическом B-дереве упорядоченный обход тоже возможен, но для перехода к следующему ключу приходится регулярно возвращаться к внутренним узлам дерева. В B+-дереве листья уже связаны между собой, поэтому диапазонные запросы и последовательный обход выполняются проще и эффективнее📈

И ещё 🅱️онус: благодаря тому, что внутренние узлы хранят только ключи-разделители, они компактнее → в страницу 8 KB влезает больше разделителей → ветвление выше → уровней дерева меньше → меньше чтений с диска.
Насколько степень ветвления выше? В 8 KB-страницу влезают сотни мелких элементов. В листе элемент — это «ключ + ctid» (для int их 366, см. этот пост). А во внутреннем узле элемент — «ключ-разделитель + ссылка на дочернюю страницу», и таких ссылок тоже сотни, то есть сотни веток к дочерним узлам (см. дикпик 2).
Для сравнения, двоичные деревья (AVL, красно-чёрные) имеют всего по две ветви, из-за чего они высокие и заточены скорее под оперативную память, а не под диск, поэтому как основу для дисковых индексов их обычно не используют.

🧰 Как это использовать
🔹 «B» — историческая загадка, а «+» — это «данные только в листьях + листья связаны в список».
🔹 Индекс по столбцу ускоряет не только поиск по равенству, но и диапазоны (>, <, BETWEEN): БД спускается к началу диапазона и идёт по связанным листьям. Часто фильтруешь по диапазону — индекс окупается.
🔹 ORDER BY по индексируемому столбцу может пройти без отдельной сортировки, если порядок в запросе совпадает с порядком индекса. Повод согласовать ORDER BY с порядком столбцов в индексе.
🔹 Один B+-tree-индекс закрывает сразу три сценария: точечный поиск, диапазон и сортировку — поэтому индекс по «горячему» столбцу часто полезнее, чем кажется.

🧑‍💻dp 🥁
#бд #postgresql #инженерныештучки #heavywednesday
  • 👍 2
  • 🤩 2
Older posts →
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →