



🔍 Если искать в лоб
Представь, что ты хочешь найти в толстой книге по базам данных упоминание слова «дерево». Если в конце нет предметного указателя — придётся листать страницу за страницей и глазами выискивать нужное слово.
СУБД без индекса делает ровно то же самое: она прочитает все страницы таблицы подряд, проверит на каждой, есть ли подходящая строка, и оставит то, что нашла. Этот режим работы называется Sequential Scan, или просто Seq Scan — последовательное чтение.
Увидеть, что СУБД делает именно так, можно через
EXPLAIN — команду, которая покажет, как планируется выполнить запрос. Видишь в плане Seq Scan — значит СУБД проходит таблицу целиком.На таблице в 10 млн строк это будет довольно долго, потому что на каждый запрос будут выполняться сотни тысяч чтений страниц с диска ради одной нужной строки 💽
📖 Предметный указатель
В книге это решается просто: там есть предметный указатель — отсортированный по алфавиту список слов с номерами страниц. Открываешь, ищешь слово, прыгаешь на нужную страницу.
В СУБД роль такого указателя играет индекс. Это отдельная структура на диске, в которой ключи (например, значения id) лежат отсортированно, а рядом с каждым — указатель на конкретную страницу таблицы 🧿
Чаще всего первый индекс появляется в таблице автоматически: когда ты добавляешь, например, в свою таблицу users PRIMARY KEY на колонку id, Postgres под капотом создаёт уникальный индекс по этой колонке —
users_pkey; в psql его видно через метакоманду \d users как btree (id).🌳 Что такое btree
В большинстве СУБД (PostgreSQL, MySQL/InnoDB, SQL Server, MongoDB через WiredTiger) индекс по умолчанию — не просто отсортированный список, а B-дерево (точнее, его вариант B+tree).
Почему не список? Главное — число чтений с диска. Бинарный поиск по отсортированному списку из миллиона страниц — это около 20 чтений. И если ключ не монотонный (email, uuid, имя автора), любая вставка в середину означает переписать целый хвост.
B-дерево — это обычное дерево из корня сверху, внутренних узлов в середине и листьев снизу. Оно устроено так:
🟢 В каждом узле много ключей — не один-два, а сотни.
🟢 Все листья на одной глубине. Любой путь от корня до листа одинаковой длины.
🟢 За счёт большого ветвления глубина дерева смешная. Для индекса по сотне миллионов записей это 3–4 уровня. Найти строку = 3–4 чтения. Не миллионы, не тысячи. Три-четыре 🎉
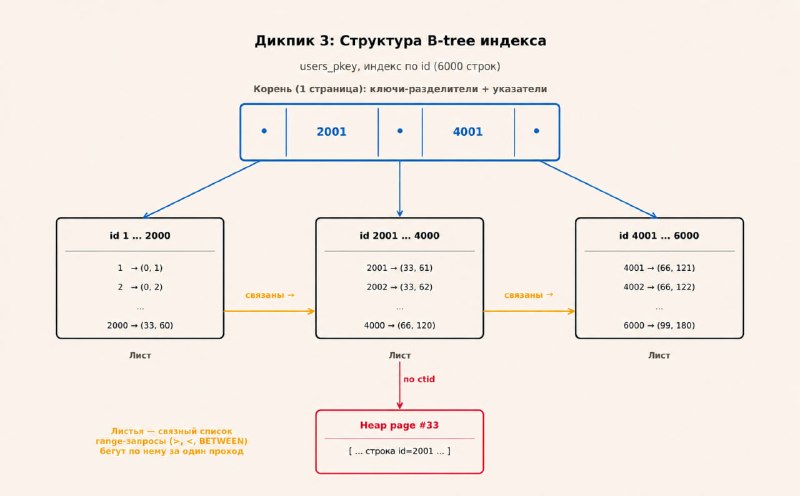
🟢 Листья связаны в список. Поэтому Range-запросы (>, <, BETWEEN) тоже летают: спустился до начала диапазона и пробежал листья подряд.
Аналогия — толстая энциклопедия: тома → главы → разделы. Три шага, и ты на месте 👍
📦 Как это лежит в Postgres (см. дикпик 3)
Структура B-tree один в один ложится на структуру страниц из прошлого поста:
⚪️ Один узел дерева = одна страница 8 KB.
⚪️ Внутренние узлы хранят пары (ключ, ссылка на дочернюю страницу). В одну страницу таких пар влезают сотни.
⚪️ Листья хранят пары (ключ,
ctid). Помнишь ctid из прошлого поста? Это указатель «страница такая-то, позиция такая-то» — он ведёт прямо на нужную строку в куче.⚪️ Индекс лежит отдельным файлом со своим
pg_relation_filepath — это не часть таблицы, это самостоятельная сущность.🔬 Пощупаем (см. дикпики 1 и 2)
Берём таблицу users из прошлого поста (6000 строк, без PRIMARY KEY) и ищем по id.
Seq Scan ... Rows Removed by Filter: 5999: прочитали всё, отбросили 5999, оставили одну.Добавляем первичный ключ. Тот же запрос — план сменился на
Index Scan using users_pkey. Сначала Postgres прошёл по B-дереву от корня до листа, там нашёл ctid, по нему сходил в нужную страницу таблицы и достал строку.🅰️ Что с этим знанием делать
Индекс — это отдельные страницы на диске. Каждый
INSERT/UPDATE/DELETE правит и таблицу, и все её индексы. Поэтому вешать их «на всякий случай» на каждое поле — плохая идея: платишь местом на диске, замедлением записи, обслуживанием дерева. При хорошо выбранном индексе взамен этих накладных расходов получаешь быстрый поиск⚡️dp
#бд #postgresql #инженерныештучки #heavywednesday