TGViewer
Channel Public Channel
C# Short Posts 🔞

C# Short Posts 🔞

@dimasshortposts

Здесь я, Дима Афонченко @Undermove1, публикую короткие заметки о разработке (и около). Я не претендую на правильность высказываний и открыт к дискуссиям, исправлениям и конструктивной критике. С любыми деструктивными вещами можно приходить в комменты)
Subscribers
306
Photos
206
Videos
7
Links
211

Showing posts older than #437 · Back to latest

Older Posts 8 shown
Post #435 465
🌊 На гребне волны. Стриминг вместо ToList. Часть 1: Server-Sent Events

Мы потихоньку улучшаем базу знаний и переводим в неё всё больше пользователей — и я начал задумываться, где и как её можно оптимизировать. Давно облизывался на стриминг: мне самому не западло написать ToListAsync там, где надо отдать кучу объектов, часто это норм. Но интересно же, как можно иначе.

Тут как раз попалась статья про IAsyncEnumerable, я и призадумался. Только мне в таких статьях вечно не хватает одного: рассказывают, как это ОТДАВАТЬ с бэка, и молчат, как это ПРИНИМАТЬ на фронте — насколько удобно, что вообще существует. А цепляет меня именно вторая половина. Так что сел и разобрал по-человечески, с обеих сторон. Начну с самого «из коробки» способа — Server-Sent Events.

💡 Для бэка идея простая: вместо «собрал всё и отдал одним JSON» открываешь одно долгоживущее соединение, по которому сервер капает события по мере готовности. Физически это обычный GET, на который сервер отвечает с Content-Type text/event-stream и просто не закрывает ответ — пишет в него «data: ...» по кусочку, а соединение висит открытым. Браузер видит каждый кусок сразу.

На бэке в .NET 10 это буквально одна строчка — TypedResults.ServerSentEvents, которому скармливаешь IAsyncEnumerable. Он сам сериализует каждый объект в data: и делает SSE-обёртку (дикпикосик 1).

За что можно полюбить SSE — это фронтендная часть. Не нужна вообще никакая библиотека: в браузере есть встроенный EventSource. Открыл, повесил обработчик, внутри JSON.parse(e.data) — всё (дикпикосик 2).

У событий есть имена, так что можно слать разнотипные: event: article на каждую статью, event: done в конце. И EventSource сам переподключится, если соединение оборвётся. Это, на минуточку, ровно та механика, на которой стримит ответы ChatGPT.

🔞 НО Пара важных «НО»:

🟢 axios сюда не умеет — он про обычные запрос-ответ, потокового чтения событий у него нет. Нужен либо нативный EventSource (для GET), либо @microsoft/fetch-event-source, если надо POST или кастомные заголовки. Сам EventSource умеет только голый GET без заголовков — авторизацию вешаешь на куку или токен в query.

🟢 не забываем CancellationToken на бэке. Соединение живёт долго, и если клиент отвалился, а ты токен не прокинул, сервер продолжит тянуть строки из БД в никуда и держать коннект. В минимал-апи токен прилетает в хендлер сам (это RequestAborted) — просто пробрось его через [EnumeratorCancellation].

🟢 авто-реконнект — палка о двух концах: когда стрим закончился, надо явно сказать клиенту «всё» (я шлю событие done и закрываю EventSource), иначе он радостно переподключится и начнёт качать заново.

🟢 SSE — это текст и только GET, плюс на HTTP/1 лимит соединений на домен. Для «сервер пушит данные клиенту» — отлично, для двунаправленного — это уже вебсокеты.

📝 По памяти: раз отдаём через IAsyncEnumerable по строке — весь список в куче разом не лежит, footprint ≈ одна строка. Каждую строку мы всё равно материализуем в объект и сериализуем, так что это не «zero-copy», но в памяти будет всего один объект, а не все пачки.

Дальше возьму NDJSON — более ручной и чуть экзотичный способ, где на фронте уже придётся повозиться руками.

#aspnet #dotnet #performance
  • ❤ 6
  • 🙏 2
Post #430 495
🌳 Индекс под капотом
Когда добавляешь к таблице индекс по id, физически на диске появляется файл индекса рядом с файлом кучи. Она держит данные в страницах (блоках по 8KB). В файле индекса тоже страницы, в которых и хранится то самое B-дерево.
В самом начале файла индекса (в блоке 0) находится служебная метастраница, просто «визитка», которая хранит указатель на корень дерева и пару параметров. Она не является частью дерева: у неё нет родителя/детей, она не участвует в навигации по уровням.

📏 Из чего состоит дерево (Дикпик 1)
Используем bt_metap - функцию из расширения pageinspect. Она читает метастраницу индекса и возвращает её содержимое: в каком блоке сейчас корень, на каком он уровне дерева, и пару служебных полей. У нас корень в блоке 3 внутри файла индекса users_pkey (по смещению 3 × 8 KB).
С пониманием level , то есть уровнем дерева, легко споткнуться: в PostgreSQL листья - это уровень 0, и нумерация растёт вверх, к корню. Поэтому level=1 означает «корень на один уровень выше листьев» → всего 2 уровня (листья на 0, корень на 1). Будь строк миллионы — стало бы level=2: корень → ветви → листья.
Следующий запрос показывает содержимое дерева: 1 страница корня (type: r) и 17 страниц листьев (type: l).

🧭 Что внутри корня (Дикпик 2)
Корень - это не данные, а «оглавление», которое содержит 17 записей вида разделитель (sep_id) → downlink (ссылка на дочерний лист (он же блок, он же страница)): «меньше 367 — блок 1; 367..732 — блок 2; …; от 5857 — блок 18». Числа 367, 733… - это границы маршрутизации.
Каждая запись в корне говорит: «вот сюда (downlink) идут ключи, начиная с такого-то значения». Самый верхний downlink должен ловить всё, что меньше первой реальной границы — а нижней границы у него нет.
Поэтому у первой записи корня нет разделителя (ключ усечён до нуля атрибутов), а её downlink ведёт в первый лист: он совпадает с любым ключом, каким бы маленьким тот ни был.
Разделители (sep_id) - это стыки между листьями, и их значения берутся из того, сколько ключей влезло в предыдущий лист. В один 8-килобайтный лист помещается 366 записей по int: лист 1 (блок 1) держит id 1…366. Когда он заполнился, 367-й ключ — первый, который туда уже не влез, — открывает следующий лист (блок 2). Вот это пограничное значение и поднимается в корень как разделитель: «ключи ≥ 367 → во второй лист, меньше → в первый».
То есть 367 = наименьший id второго листа.

🍃 Что внутри листа (Дикпик 3)
А тут живут настоящие записи: пара ключ id_key → heap_ctid, то есть указатель на строку в той самой куче. И смотри: id_key=1 → (0,1), id_key=121 → (0,121) — это ровно те же ctid, что мы видели в посте про страницы! То есть индекс хранит значения id по порядку и держит указатели на строки. Запись с itemoffset = 1 - это high key, то есть верхняя граница этой страницы.

🔗 Итоговая картина (Дикпик 4)
Как видно, индекс - это отдельный файл на диске, в котором метастраница и B-дерево - (корень + листья), итого 19 страниц. Куча users — другой файл, со своими 50 страницами. Связь односторонняя: листья держат ctid в кучу, но сама куча про индекс ничего не знает.

🏗 Любопытная деталь
Почему корень оказался в блоке 3? ADD PRIMARY KEY собирает дерево снизу вверх: блок 0 - мета, блок 1 - первый лист (пока без корня); он переполняется → создаётся второй лист (блок 2), и тут же рождается их общий родитель (корень) → ему достаётся блок 3.

🔎 Как в итоге ищется WHERE id = 5999
1) Метастраница индекса → корень (блок 3);
2) 5999 ≥ 5857 → последний лист (блок 18);
3) в листе берём heap_ctid;
4) читаем одну heap-страницу.

⚡️~3 чтения вместо 50⚡️

🅰️ Что унести с собой
- PK-индекс - это отсортированный справочник «id → ctid»
- Индекс и таблица - это разные файлы
- ctid на кучу живёт в листьях индекса
- Третий уровень (ветви между корнем и листьями) появляется лишь на сотнях тысяч строк - на 1 млн строк дерево уже трёхуровневое (корень → 10 ветвей → 2733 листа).
- Точечный поиск по PK - это 2–3 обращения к страницам, поэтому он «бесплатный» по ощущениям.
Команды, чтобы повторить и потыкать самому — в 👉гисте 👉
dp
#бд #postgresql #инженерныештучки #heavywednesday
  • ❤‍🔥 2
  • 🔥 1
Post #429 308
📺 Мама, я в телевизоре!

Моя статья про тестовые фреймворки попала в подкаст RadioDotNet!

В самой статье материала получилось много и с кучей кода, и мне было понятно, что осилят такое не все. Ребята в подкасте статью пересказали и прокомментировали, что по сути добавило аудио-формат.

Так что если вдруг хотите послушать, как работают тестовые фреймворки, то вот, пожалуйста, теперь в виде подкаста. А текстовый формат лежит вот тут.

Ну и вообще подкаст хороший — всем советую, если вы его еще вдруг не слушаете)

#тесты #подкаст
YouTube Улучшения в Process, запуск тестов, новинки в IDE Подкаст RadioDotNet выпуск №136 от 21 мая 2026 года Разговоры на тему .NET во всех его проявлениях, новости, статьи, библиотеки, конференции, личности и прочее интересное из мира IT. В этом эпизоде вы можете услышать историю про большие нагрузки от международного…
  • 🔥 10
  • ❤‍🔥 4
  • ❤ 3
Post #428 370
👁👁 Пятничный вечерний пост.

Замечали что пока работаете, все время хочется спать? При этом ваши умные часы показывают заветные 8 часов сна сегодня.

Так вот у меня было так же. И я не понимал в чем дело. Пока однажды коллега не поделился лайфхаком – он просто переехал на светлую тему и сонливость полностью прошла.

Сначала чуток непривычно, зато полностью снимает сонливость в рабочее время! Ну а для вечера можно настроить чтобы тема сама сменялась на темную и клонила в сон вместо того чтобы будоражить сетчатку и нервишки.

Вот уже 4 года живу в таком режиме – полет отличный!

Так что расщепериваем глазки и переходим на светлую сторону 💡

#лайфхаки #продуктивность
  • 🌚 6
  • 👍 2
  • 😎 2
  • ✍ 1
Post #426 369
🗞 Что было за последний месяц для ASP.NETёра

Решил ввести для себя новую механику в самообучении. Сажусь раз в месяц и делаю себе типа дайджест, что было полезного в дотнете для меня на почитать и узнать нового. Буду иногда такое и сюда выкладывать, если будет что-то интересное на мой личный взгляд.

1️⃣ HybridCache + Postgres вместо Redis

В .NET 10 HybridCache наконец релизнулась. Главная фишка — встроенный stampede-protection (про который есть отличная серия постов и статья на моем любимом шарповом канальчике) и L1-memory (в процессе) + L2-distributed (в базе или редисе) одним API.

В этой статье MS показывает связку HybridCache с пакетом Microsoft.Extensions.Caching.Postgres — то есть L2 живёт в Postgres-таблице с UNLOGGED-флагом для скорости записи. Сейчас стало хайпово заменять все на постгресс. Ну по крайней мере в моем инфопузыре эта тема встречается регулярно. И вот и в майрософтовый блог просочилось.

Кажется скоро мы в постгрессе и рилсы с тиктоками сможем посмотреть, и даже катку в доту скатать.

2️⃣ Union types в C# 15

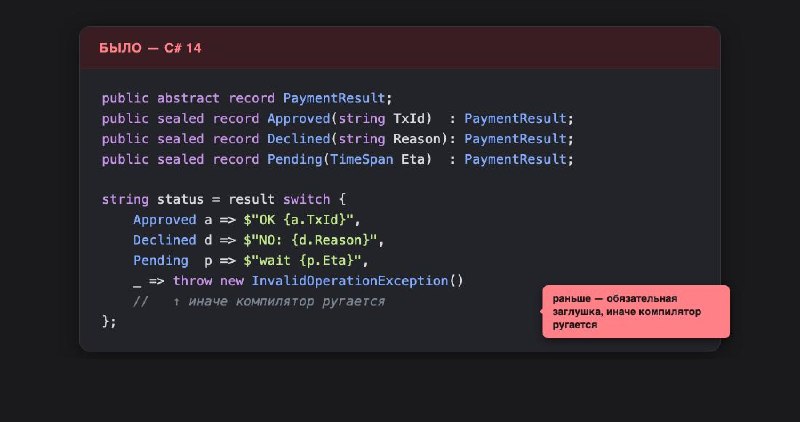
Про эту фичу много было хайпа. И уже давно. Я даже писал про тот функционал который по сути заменял эту функцию. Но теперь можно будте писать код, как на пояснительном дикпике.

Главный профит — если завтра в union добавится Refunded, все switch-выражения посыпятся в Build Output с ошибкой про неполноту, и ты гарантированно эти места найдёшь. Сегодня без помощи компилятора такие тихие «_ => throw» живут месяцами и ловят тебя за жопу в неподходящий момент. Хотя в целом можно тестами такое покрывать раньше было. Но теперь можно будет на компилятор положиться.

3️⃣ Node.js addons на C# через Native AOT

История: У команды C# Dev Kit был нативный Node.js аддон на C++

Что их бесило:

node-gyp требует Python — каждый разработчик в команде должен был ставить Python 3.x на свою машину, хотя в коде Python нет ни строчки.

Онбординг новых разработчиков — нужно настроить кучу тулзов, которые ты в работе никогда не трогаешь напрямую: C++ компилятор (MSVC / clang / gcc — у каждой ОС свой), node-gyp, Python, плюс ещё CMake местами.

CI/CD — пайплайны вынуждены провижнить и поддерживать в свежем состоянии тот же зоопарк: Python, C++ тулчейн, node-gyp.

Билды медленные — C++ компиляция аддона тормозила пайплайн, плюс надо ещё дёрнуть Python скрипты для генерации проектов.

Чуваки все переписали никогда не угадаете на Rust Go C# Native AOT!

В итоге:
- ❌ Питон — выпилили
- ❌ node-gyp — выпилили
- ❌ C++ тулчейн — выпилили
- ✅ Осталось dotnet publish → готовый .node файл

Статья из серии для общего развития. Мне оно не надо. Но где-то на подкорке мне хочется знать, что такая возможность у меня есть.

Такие вот у нас пироги. 🥧 В июне постараюсь продолжить эту серию.

#dotnet #aspnet #performance
  • ❤ 7
Post #421 455
👈 В прошлый раз мы выяснили, что обычно данные в СУБД лежат в страницах фиксированного размера. А как по этим страницам что-то быстро найти?

🔍 Если искать в лоб
Представь, что ты хочешь найти в толстой книге по базам данных упоминание слова «дерево». Если в конце нет предметного указателя — придётся листать страницу за страницей и глазами выискивать нужное слово.
СУБД без индекса делает ровно то же самое: она прочитает все страницы таблицы подряд, проверит на каждой, есть ли подходящая строка, и оставит то, что нашла. Этот режим работы называется Sequential Scan, или просто Seq Scan — последовательное чтение.
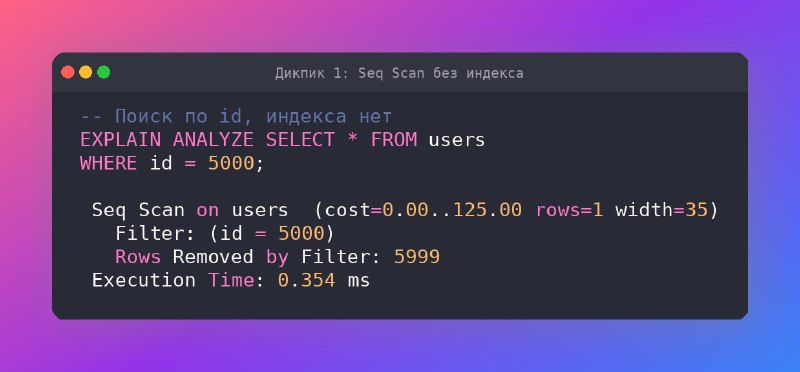
Увидеть, что СУБД делает именно так, можно через EXPLAIN — команду, которая покажет, как планируется выполнить запрос. Видишь в плане Seq Scan — значит СУБД проходит таблицу целиком.
На таблице в 10 млн строк это будет довольно долго, потому что на каждый запрос будут выполняться сотни тысяч чтений страниц с диска ради одной нужной строки 💽

📖 Предметный указатель
В книге это решается просто: там есть предметный указатель — отсортированный по алфавиту список слов с номерами страниц. Открываешь, ищешь слово, прыгаешь на нужную страницу.
В СУБД роль такого указателя играет индекс. Это отдельная структура на диске, в которой ключи (например, значения id) лежат отсортированно, а рядом с каждым — указатель на конкретную страницу таблицы 🧿
Чаще всего первый индекс появляется в таблице автоматически: когда ты добавляешь, например, в свою таблицу users PRIMARY KEY на колонку id, Postgres под капотом создаёт уникальный индекс по этой колонке — users_pkey; в psql его видно через метакоманду \d users как btree (id).

🌳 Что такое btree
В большинстве СУБД (PostgreSQL, MySQL/InnoDB, SQL Server, MongoDB через WiredTiger) индекс по умолчанию — не просто отсортированный список, а B-дерево (точнее, его вариант B+tree).
Почему не список? Главное — число чтений с диска. Бинарный поиск по отсортированному списку из миллиона страниц — это около 20 чтений. И если ключ не монотонный (email, uuid, имя автора), любая вставка в середину означает переписать целый хвост.
B-дерево — это обычное дерево из корня сверху, внутренних узлов в середине и листьев снизу. Оно устроено так:

🟢 В каждом узле много ключей — не один-два, а сотни.
🟢 Все листья на одной глубине. Любой путь от корня до листа одинаковой длины.
🟢 За счёт большого ветвления глубина дерева смешная. Для индекса по сотне миллионов записей это 3–4 уровня. Найти строку = 3–4 чтения. Не миллионы, не тысячи. Три-четыре 🎉
🟢 Листья связаны в список. Поэтому Range-запросы (>, <, BETWEEN) тоже летают: спустился до начала диапазона и пробежал листья подряд.
Аналогия — толстая энциклопедия: тома → главы → разделы. Три шага, и ты на месте 👍

📦 Как это лежит в Postgres (см. дикпик 3)
Структура B-tree один в один ложится на структуру страниц из прошлого поста:
⚪️ Один узел дерева = одна страница 8 KB.
⚪️ Внутренние узлы хранят пары (ключ, ссылка на дочернюю страницу). В одну страницу таких пар влезают сотни.
⚪️ Листья хранят пары (ключ, ctid). Помнишь ctid из прошлого поста? Это указатель «страница такая-то, позиция такая-то» — он ведёт прямо на нужную строку в куче.
⚪️ Индекс лежит отдельным файлом со своим pg_relation_filepath — это не часть таблицы, это самостоятельная сущность.

🔬 Пощупаем (см. дикпики 1 и 2)
Берём таблицу users из прошлого поста (6000 строк, без PRIMARY KEY) и ищем по id. Seq Scan ... Rows Removed by Filter: 5999: прочитали всё, отбросили 5999, оставили одну.

Добавляем первичный ключ. Тот же запрос — план сменился на Index Scan using users_pkey. Сначала Postgres прошёл по B-дереву от корня до листа, там нашёл ctid, по нему сходил в нужную страницу таблицы и достал строку.

🅰️ Что с этим знанием делать
Индекс — это отдельные страницы на диске. Каждый INSERT/UPDATE/DELETE правит и таблицу, и все её индексы. Поэтому вешать их «на всякий случай» на каждое поле — плохая идея: платишь местом на диске, замедлением записи, обслуживанием дерева. При хорошо выбранном индексе взамен этих накладных расходов получаешь быстрый поиск⚡️
dp
#бд #postgresql #инженерныештучки #heavywednesday
  • 🤝 2
  • ⚡ 1
Post #417 635
В жизни каждого шарписта наступает момент, когда надо разобраться, наконец, как работает СУБД, которой он каждый день пользуется.
Прежде чем написать этот короткий пост, я погрузился в тему баз данных и в какой-то степени они стали для меня открытой книгой, буквально, потому что в них слишком много аналогий с книгами. Оказывается, что концепция, на которой стоит вообще всё хранение данных, одна и та же что в PostgreSQL, в MySQL, и даже в MongoDB — страницы 📄

📖 Что такое страница и зачем она
Когда ты делаешь INSERT INTO users (...), в голове картина обычно простая: «строчка просто легла куда-то в таблицу». Физически — нет. Ни одна нормальная СУБД (что реляционная, что документная) не пишет каждую строку или документ отдельно. Вместо этого данные складываются в страницы (pages) — блоки фиксированного размера.
У PostgreSQL и SQL Server страница — 8 KB, у MySQL/InnoDB — 16 KB, у MongoDB через WiredTiger — настраивается, но того же порядка. Любая операция чтения или записи — это работа с целой страницей, а не с одной строкой.
Почему так? Потому что диск и RAM физически работают блоками, а не байтами. Один поход на диск всё равно вытаскивает целый блок килобайт на восемь — хочешь ты того или нет. СУБД этим пользуется: складывает в одну страницу столько строк или документов, сколько влезет. Берёшь одну строку — получаешь рядом «соседей» бесплатно 💋

🔬 Давай потрогаем руками
Самое классное — это всё можно пощупать, если поднять, например, PostgreSQL в Docker. Полный список команд для последовательного выполнения сможешь найти 👉вот здесь👈 (а то пост получится уже не таким коротким) 🥖

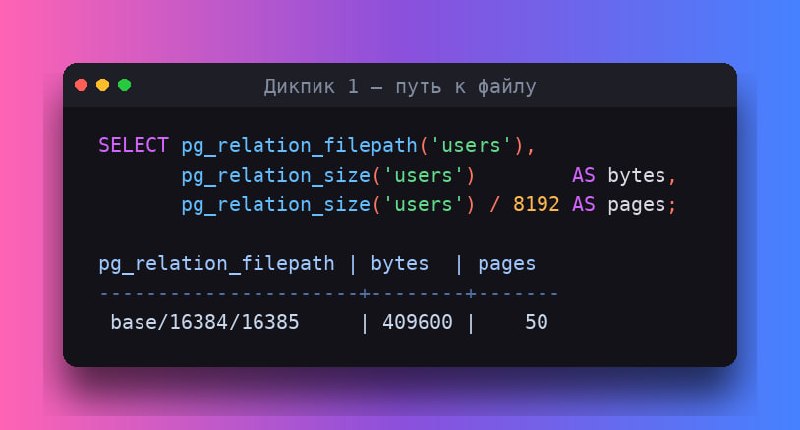
На пояснительном дикпике 1 можно увидеть, где физически лежит созданная таблица и сколько весит: файл занимает ровно 409600 байт = 50 × 8192, то есть страницы ровно по 8 KB. И таких страниц в одном файле подряд — 50 штук, это и есть вся таблица.

На дикпике 2 можно увидеть, как заглянуть внутрь файла прямо из контейнера и что записи лежат сырыми байтами в одной из 50 страниц.

📍 Где какая строка лежит
В Postgres у каждой строки есть служебный «адрес» — ctid, пара (номер страницы, номер слота на странице).

На дикпике 3 запрос, который покажет адреса выбранных строк, и там же видно, что в нулевую страницу 8 KB у нас влезла 121 строка, в первую — следующие 120, и так далее. На 6000 строк ушло 50 страниц — ровно то, что мы видели по размеру файла. Когда СУБД хочет прочитать запись с id = 5999, она не «ищет в таблице» — она поднимает с диска страницу №49 и достаёт из неё нужный слот.

🧑‍💻 Что с этим знанием делать в работе
1. Чтение одной строки = чтение целой страницы. Запросом за одной строчкой ты всё равно поднимаешь с диска 8 (или 16) KB. Если в WHERE id IN (...) много значений и они физически рядом — это почти бесплатно. Если разбросаны по таблице — каждое чтение отдельная страница.
2. Узкие таблицы — это не только про место. Чем шире строка, тем меньше их влезает в страницу. Большое поле text на килобайт-другой может уронить плотность в 20 раз — и для того же количества строк понадобится в 20 раз больше страниц.
3. shared_buffers / buffer pool — это кэш страниц, не строк. Когда тюнят память под СУБД, имеют в виду «сколько страниц влезет в RAM». И именно поэтому случайные чтения по большой таблице болят: каждая страница приходит с диска заново.
4. В Postgres UPDATE — это DELETE + INSERT. Старая версия строки помечается мёртвой и продолжает лежать на той же странице, новая дописывается рядом. Поэтому после массовых апдейтов файл таблицы пухнет, пока не пройдёт VACUUM. Та же логика — ctid после UPDATE меняется, потому что физически это уже другая запись на другом слоте.

А если в таблице миллионы записей, как БД так быстро находит нужную? Для этого нужны индексы, но о них — в другом посте👉

🧑‍💻dp 🥁
#бд #postgresql #инженерныештучки #heavywednesday
  • ❤ 2
Post #416 456
Надоело писать про AI

Но не писать про него сейчас сложно! Потому что выходит очень много всего интересного!

В этом канале я изначально хотел писать про веб-разработку и все что с ней связано – как писать грамотный код, какая инфра крутится вокруг и этого кода и как она работает. Еще мне было интересно одно время писать про организацию процессов.

В общем, тут я и планирую этим заниматься, а вот все посты про AI и всю эту мишуру думаю теперь вести в отдельном канале. На котором как раз вышел пост и для которого я накидал статью на Хабр.

А еще там уже есть довольно неплохие разборы:

🟢Что влияет на цену токенов?
🟢Почему нейронки могут в будущем сильно подешеветь?
🟢С какого момента начинается контекст-рот?

В общем, заходите, гости дорогие, читайте, буду рад всех вас там видеть)

А еще канальчик это мы ведем с @sagos95 который является заядлым ИИнтузиастом. Так что там точно будет много гиканутого 🔥
Telegram Нейросети на практике Опубликовал небольшую статью на хабре о том, как автоматизировал разработку в своем пет-проекте. То бишь сделал так что ИИ разрабатывает его за меня. Заходите, читайте, комментируйте, я буду очень признателен за любые лайки и комментарии. Надеюсь, вам будет…
  • 🔥 3
Older posts →
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →