
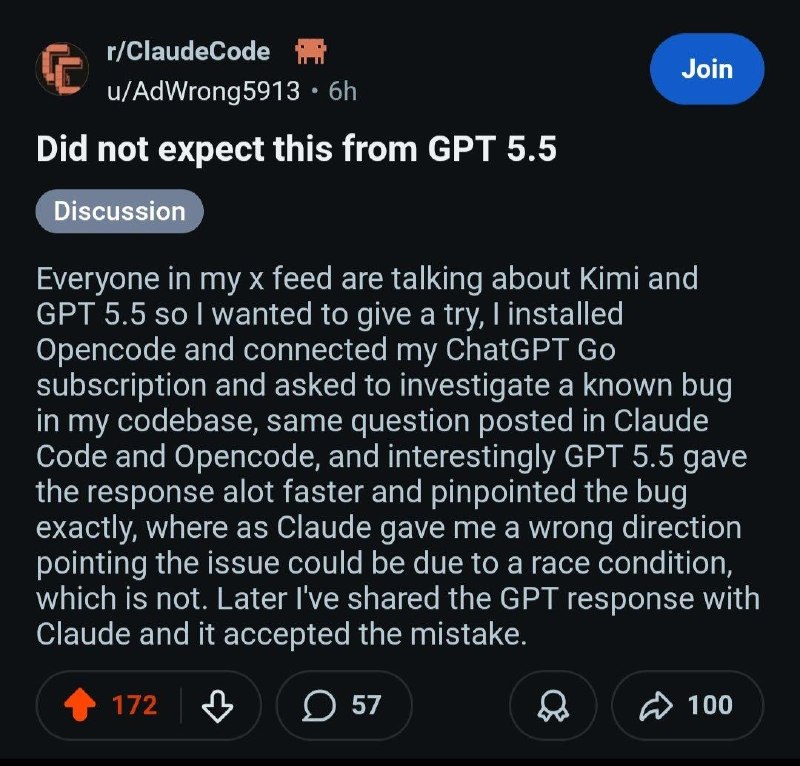
В очередной раз увидел, как одна модель смогла исправить баг, который друге не могли. Такое происходит постоянно, и часто истории продаются как «блин вот из-за такого видимо придётся переходить с модели X на Y».
При этом я во многом не считаю такие примеры показательными. Давайте подумаем почему.
Во-первых, навыки модели во многом обусловлены данными и задачами, на которых их тренируют. Из-за этого даже модель, которая лучше в среднем по широкому набору задач может проигрывать в отдельных подзадачах каки-то доменов. Вот одна компания обучала модель искать баги одним пайплайном с такой-то инструкцией, и LLM научилась, а у другой было гораздо более обширно, но конкретно такой аспект не выучился.
Во-вторых, модели недетерминированы, и что не решается 1 запуском может решаться 3, 5 или 10 попытками. Может просто так получиться, что в запросе к другой модели чуть больше повезло.
В-третьих, все такие тесты подвержены проблеме восприятия. Когда новая модель решает что-то, что не решила старая, то мы автоматически предполагаем, что она решила бы всё, что у меня решала предыдущая. С такой точки зрения кажется, что нужно переходить на вот эту новую модель — она ведь ничем не хуже, а только лучше. Но это не так: все задачи, которые у нас сразу сработали на первой, не обязательно работают на второй. И сменив модель можно быстро попасть в ситуацию, где уже привычные вещи не работают (кстати, поэтому менять модели сложно — вроде привык, а вот какая-то достаточно простая штука не работает, и всё, кажется, что супер-тупая; хотя надо просто по другому промптить).
Такая картина бывает даже с опенсурсом, когда условный DeepSeek решает проблему, которую не смог решить Opus. Является ли один-два таких примера показательными? Конечно, нет.
Что может быть каким-никаким прокси сигналом — это сколько таких заявлений в целом появляется при релизе по отношению к предыдущим (и важно делать поправку на аудитории моделей). Но поскольку такую аналитику делать никто не будет, то и говорить нечего 🤷♂️
А для конкретного пользователя действительно может оказаться, что под его стак (язык + библиотеки + LLM-клиент + как он промптит + что угодно) одна модель лучше другой, если подобные ситуации повторяются часто.
Post #924
702