TGViewer
Channel Public Channel
开发者工具箱|编程·开发工具·资源

开发者工具箱|编程·开发工具·资源

@devtoolboxhub

面向开发者的实用工具、库与效率技巧,写代码更快更爽。投稿 @BDHT1
#开发者 #编程工具 #效率 #程序员 · 开源总站 @GitHubTrendingHub
Subscribers
559
Photos
1.4K
Videos
0
Links
776

Showing posts older than #1197 · Back to latest

Older Posts 16 shown
Post #1196 2
Paper 命令注册:用 Brigadier 替代 CommandExecutor

传统 Paper 插件通过 plugin.yml + CommandExecutor 注册命令,存在多个痛点:args[0] 需手动解析、不支持选择器(@a、@p)、Tab 补全须单独维护 TabCompleter 且容易不同步,命令树静态固定,无法根据配置动态改变参数结构。

Paper 内置了 Mojang 的 Brigadier 框架,通过 LifecycleEvents.COMMANDS 生命周期钩子注册命令树,无需 commands 块。权限检查挂在树节点上,Brigadier 在构建 Tab 补全时自动过滤无权限的命令,例如 requires() 确保只有拥有对应权限的玩家才能看到 /punish。命令树可根据配置条件化注册——例如 /report 只在启用 severity 时增加 severity 参数,否则注册简化版,Tab 补全和错误提示始终准确。

ArgumentTypes.player() 返回的不是 Player 对象,而是一个解析器,支持 Steve、@a、@p 等选择器,无需手动实现。解析后通过 resolvePlayer 转换为玩家,同时处理空选择器的情况。整体注册流程比传统方式更清晰、类型安全,且 Tab 补全自动同步。

传统方式的问题:Bukkit.getPlayer(args[0]) 只能精确匹配当前在线玩家,不支持选择器和模糊匹配;Tab补全必须手动同步,易出错;命令树固定,无法动态调整。

Brigadier 方式示例:在 LifecycleEvents.COMMANDS 内注册 /punish 字面量,requires 检查权限,then 追加 target 参数并绑定执行方法。对于 /report,先读取配置,若启用 severity 则注册含 severity 分支,否则注册简单分支。

ArgumentTypes.player() 的使用:在命令上下文中获取 PlayerSelectorArgumentResolver,调用 resolve(ctx.getSource()) 获得玩家列表,取第一个或处理空情况。这样命令处理器就能直接使用解析到的玩家。


迁移到 Brigadier 可大幅简化 Paper 插件命令开发,消除重复劳动和潜在 bug。虽然旧命令映射仍能工作,但 Brigadier 已成为推荐的首选方案。

#开发者 #工具 #Paper #Brigadier #Minecraft #Command
@DevToolboxHub
Post #1195 2
gstack:Garry Tan 开源了他的日常开发栈

Y Combinator 总裁 Garry Tan 将其每天使用的工具集 gstack 开源(MIT 许可)。它把 Claude Code 变成一个由 23 名专家组成的虚拟团队——包括 CEO、工程师、设计师、QA 和发布工程师——强制每次变更在发布前经过多视角审查。核心理念不是“写得更快”,而是“审查后再发布”。

gstack 的核心在于审查视角:CEO 视角审视这是否真的是 10 星产品,工程师视角检查架构能否扛住边界情况,设计师视角判断“好”的标准,开发者体验视角关心他人能否顺利接手。最后还包含测试、提交 PR 和部署后的监控步骤。

Garry 在 ETHOS 文件中写道:“工程之墙已倒下,剩下的只有品味、判断力和完成整件事的意愿。” 他声称今年自己写代码的速度比 13 年前快数百倍,但重点不在速度——当写代码成本几乎为零时,决定“构建什么”并拒绝输出垃圾,成了全部工作。他提出“煮海”原则:过去因为工程师时间昂贵,建议不要做完整的事;现在完整版本只要多花几分钟,就应该做完。

另一个关键原则是:“AI 模型推荐,用户决策。”、“两个 AI 模型对同一变更达成一致是强信号,但不是命令。” 每个审查视角的作用都是挑战工作,而不是例行盖章,最终由人决定采纳哪条反馈。


对于产品构建者,可以从中借鉴三点:即使独自工作也要设置审查关卡;在完成成本低的今天,做完整的事情而非粗糙版本;当 AI 显得自信或两个模型一致时,更要保持最终决策权。

GitHub: github.com/garrytan/gstack

#开发者 #工具 #gstack #GarryTan #YC #ClaudeCode #AI编程 #代码审查 #MIT
@DevToolboxHub
Post #1194 2
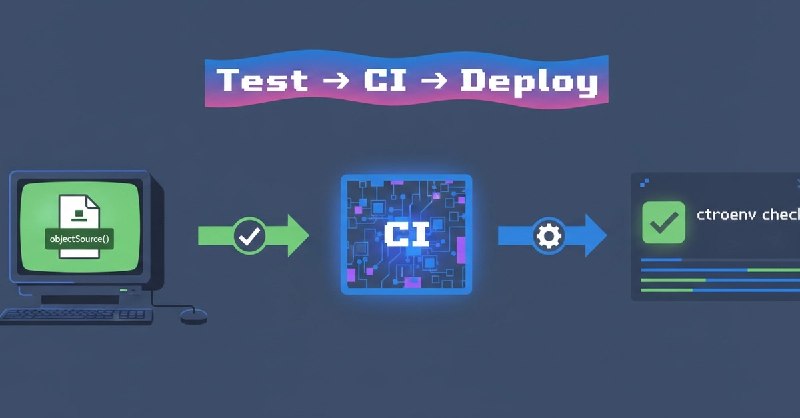
CtroEnv:测试与调试环境变量

传统测试环境变量往往需要修改 process.env 并祈祷清理干净。CtroEnv 提供 objectSource(),可将普通对象包装为环境源,无需全局操作。每个测试都能获得独立环境,告别 beforeEach/afterEach 清理。四种错误码精准定位问题,支持格式化输出。

测试时使用 defineEnv 和 objectSource 即可注入任意覆盖值,验证解析结果、缺失变量或类型错误。CtroEnvError 会一次性收集所有错误,避免逐一修复。秘密值可通过 secret() 标记并自动掩码,支持自定义掩码字符串。
调试方面有四个错误码:missing_required(变量缺失)、type_mismatch(类型不匹配)、invalid_value(校验失败,如无效URL)、validation_failed(自定义校验拒绝)。formatErrors 函数可将错误按类型分组并带颜色输出。
CI/CD 集成:CLI 直接解析配置文件,无需导入 schema。支持快速键对比(1秒内完成)、严格值校验、未知键警告(基于 Levenshtein 距离提示)、JSON 输出(可接入 Slack、监控面板)。提供 GitHub Actions 示例,构建阶段通过 Vite/Next.js 插件在失败时终止构建。


GitHub · npm

#开发者 #工具 #CtroEnv #Nodejs #TypeScript #Testing #CICD #DevOps
@DevToolboxHub
Post #1193 4
Laravel 图片上传防 PHP 注入中间件

图片上传存在已知风险:一个有效 JPEG 文件可在 EXIF 注释中隐藏 PHP 代码,却仍能通过 MIME 检查、扩展名检查和 getimagesize()。一旦文件被写入可执行路径,就可能实现远程代码执行。

laravel-image-sanitize 是一个轻量中间件,在上传处理前扫描图片中的 payload 标记(<?php、phar),若有发现则通过 Intervention Image 从头解码并重新编码,仅保留像素数据,丢弃所有附加内容。使用时通过 Composer 安装,挂载到路由即可。

注意这不能替代 Laravel 自身的验证规则,两者应同时使用。默认支持 JPEG、PNG、GIF、BMP、WebP,不包含 SVG。质量默认 100(近无损),可调整。配置可发布并自定义允许类型、扫描模式、驱动等。


GitHub

#开发者 #工具 #Laravel #安全 #文件上传 #PHP #中间件
@DevToolboxHub
Post #1191 5
AI代理安全生产:ReAct循环漏洞与防御

Sriram Madapusi Vasudevan 在 InfoQ 演讲中探讨了生产环境下自主AI代理的安全保护模式。他重点剖析了 ReAct 循环在上下文、推理和工具执行三阶段隐藏的关键漏洞,如记忆中毒和恶意工具执行。

针对这些风险,他分享了深度防御、LLM-as-a-judge 评审机制以及 MAESTRO 威胁建模等缓解策略,帮助开发者在 AI 加速开发的同时守住安全底线。

#开发者 #工具 #AI代理 #安全 #ReAct #LLMasJudge #MAESTRO #威胁建模
@DevToolboxHub
Post #1190 4
DBSteward:让共享 RDS 实例账单可分摊到每个库

共享实例账单到了,只知道总数,不知道哪个数据库用了多少钱——这是所有在 AWS RDS 上跑多个数据库的团队都遇到的痛点。实例级计费下,一单 SQL Server 实例里不管跑 2 个还是 20 个数据库,都只显示一行费用。财务要回溯审计、噪声邻居影响性能、SaaS 成本不清晰,问题全靠粗放分摊(按人头、按猜)维系。

HiFX 开发的 DBSteward 解决了这个盲区:它直接从数据库引擎读取 DMV 数据,按计划采集每个数据库的 CPU、I/O 停顿、内存、磁盘用量,再通过可配置权重(或自动根据实例瓶颈计算)将成本分配到每个库,并显式报告“未分配”部分(系统库、后台开销等),保证拆分后数字与 AWS 账单完全吻合。

举个例子:用一个共享实例 prd-acme-rds-sql1,月账单 $1,000。追踪两个库——AcmeSales(繁忙 OLTP)和 AcmeInventory(大容量但低负载)。DBSteward 采集到以下用量(简化):
指标:AcmeSales / AcmeInventory / 实例总量
CPU (s):300 / 100 / 1,000
I/O 停顿 (ms):200,000 / 200,000 / 500,000
磁盘 (GB 均值):50 / 150 / 400
计算各库占比后,再根据各自权重(AcmeSales 重 CPU 50%、I/O 30%、磁盘 20%;AcmeInventory 重磁盘 60%、CPU 20%、I/O 20%)得出:
AcmeSales 得分 0.295 → 分摊 $295
AcmeInventory 得分 0.325 → 分摊 $325
未分配 (系统/未追踪) 占 38% → $380
总和 $1,000,精确对账。关键:追踪库不硬扛全部账单,未分配部分明示,财务报表可追溯。


成本归属不只是一项记账任务——做不到它,团队会因账单不透明而过度预配独立实例、任由噪声邻居拖慢性能、靠感觉定 SaaS 价格。DBSteward 把“实例花了 $4,000”变成“各库该付多少”,让成本从每月意外变成可行动的信号。

#开发者 #工具 #DBSteward #HiFX #FinOps #AWS #RDS #SQLServer #成本分摊
@DevToolboxHub
Post #1189 3
用ADO工作项驱动AI代理构建:结构化规范才是核心

AI代理的品牌无关紧要,工作项的质量决定成败。如果交给代理的需求是非结构化的自由文本,每个代理都会猜测,且每次猜测结果都不同。将Azure DevOps工作项改造成机器可读的规范(Given/When/Then行为描述 + YAML模式定义),任何代理(Copilot Studio、Claude Code、Codex等)都能据其生成可复现的组件,并保持可追溯性。

失败根源:验收标准散落在过时的wiki、Teams消息或某人的脑子里,代理只能猜意图。换代理不能解决缺口,缺的是规范。一次会话生成的解决方案不可重复、不可审计,是披着效率外衣的单点故障。UAT中发现的返工成本约为设计阶段的5倍。
解决方案:用一致的工作项模板承载结构化块——验收条件用Gherkin格式(Given/When/Then),实体和表定义用围栏YAML,业务规则用条件与结果,安全角色显式命名。代理读取字段而非“氛围”,所以要为解析器而非站会写工作项。通过Azure DevOps REST API或MCP服务器程序化拉取工作项,输入结构化规范,输出Dataverse表、Power Automate流、插件代码,且每个产出物自动回链到工作项ID(AB#语法)。可追溯性锚定在Git提交和PR中,而非Dataverse元数据。
禁止区:代理绝不能进入生产环境、不能触碰托管解决方案、不能编辑安全角色或环境变量、不能绑定实时凭据,更不能修改它收到的规范。最经济的护栏是使用一个范围限定为开发环境且拥有自定义安全角色(非系统管理员)的应用注册身份,并配合DLP策略阻止生产连接器。运行前检查清单:规范含围栏块、身份仅限开发、DLP就绪、目标分支为feature、CI验证门控、人工PR审批者、提交模板强制AB#链接。如果七项不能全部满足,代理就不应运行。
将验收标准作为测试预言机:在CI中运行Given/When/Then场景验证生成解决方案,偏离规范即构建失败。目前这是一个需要自行组装(Power Apps Test Engine + 自定义脚本 + Build Tools任务)的模式,并非微软官方产品。人工PR审批者检查的是规范到工件的映射,而非每行代码。
用例演示:一个工项包含案例路由需求(YAML模式 + Given/When/Then),代理读取后生成Dataverse表、路由流和审批流,提交到feature分支,CI门控运行场景验证,开发身份使生产区物理不可达。从chat构建转向规范驱动构建后,可复现、可追溯、有治理。


正文小结:在下一个sprint之前,将一个Feature转换为围栏规范模板并提交。一条工项,包含YAML模式和Given/When/Then块,后续一切由此衍生。代理是可替换的细节,规范是常量。

#开发者 #工具 #AzureDevOps #PowerPlatform #AI #规范驱动 #ADO #代理开发 #CopilotStudio
@DevToolboxHub
Post #1188 3
AI让代码免费,巨头为何仍赢?

AI本质未改变软件业务的成本结构:编写代码的成本趋近于零,但分发、信任、支持和责任承担仍占软件业务的约80%。结果是中间层被掏空——10人规模的VC跟风创业公司被两端挤压:下方是免费交付的单人开发者,上方是打包集成的巨头。DORA 2025报告指出,AI是放大器而非均衡器,它放大高绩效组织的优势,同时也放大混乱组织的缺陷。关键因素在于行动独立性,松耦合团队获得20-30%生产力提升,紧耦合团队几乎无收益。

开发者对AI的态度呈现矛盾:采用率高达85-90%,但信任度却在下降。Stack Overflow数据显示,对AI的好感度从72%降至60%,46%的开发者不信任AI的准确性,66%抱怨“几乎正确但不够准确”的输出,45%认为调试AI代码更耗时。METR研究更揭示了讽刺性事实——有经验的开源开发者使用AI后实际速度慢了19%,但自我感觉快了20%。

对于独立开发者而言,架构选择成为生存策略:干净的适配器接口将平台依赖风险控制在配置变更级别,而分散的调用则可能引发重写危机。开源社区贡献创纪录,但维护层变薄,许可证战争表明开源是分发和信任手段而非商业模式。全球开发者版图向南方迁移:印度新增520万开发者,巴西、印尼等地区开发者数量四年翻了四倍。对独立开发者来说,专注于巨头不会做的本地化是有效楔子。

#开发者 #工具 #AI #DORA2025 #StackOverflow #GitHubOctoverse #JetBrains #开源 #独立开发者 #全球南方
@DevToolboxHub
Post #1186 1
git-lrc:每次commit自动AI代码审查

Maneshwar 正在开发 git-lrc,一个微型 AI 代码审查器,在每次 git commit 时运行。它完全免费,源码开放,60 秒即可安装。

AI 代理生成代码很快,但也可能静默删除逻辑、改变行为或引入 bug,直到生产环境才暴露。git-lrc 在提交前审查每个 diff,覆盖 10 个风险类别、追踪 100+ 失效模式,帮助预防停机、数据泄露和技术债。

GitHub

#开发者 #工具 #gitlrc #AI #CodeReview #GitHub
@DevToolboxHub
Post #1184 1
逃离 LeetCode 两年后重回之路

开发者 Konark Sharma 分享了他与 LeetCode 的曲折故事。从 2024 年决心刷题却很快放弃,到受 Hadil 文章的激励重启征程。他经历了恐惧与自我怀疑,最终重新学习了 C++ STL 等基础,并转向理解解题模式而非盲目刷题。

在重新开始的过程中,他意识到基础是关键,并运用 80/20 原则专注核心概念。随后,他学习了双指针、快慢指针、滑动窗口等常见模式,以帮助识别问题类型。然而,在实践中,他又遇到了过度工程化和过于简化的问题。

经过一系列实践,他总结出一套刷题指南:先思考而非急于编码,考虑暴力、更优和最优解;提交前检查代码错误;提前考虑边界情况;先在纸上推演逻辑;关注时间复杂度;并记录解题过程。他承认自己仍在逐步摸索,但核心转变在于从无脑刷题转向理解模式。


承认这个过程并不容易,但他强调从无脑刷题转向理解模式带来了根本性改变,鼓励读者分享自己的经验。

#开发者 #工具 #LeetCode #DSA #C++ #编程面试 #算法学习
@DevToolboxHub
Post #1183 2
Claude Code 暗藏 Unicode 隐写追踪

Anthropic 的 AI 编码工具 Claude Code 被发现在系统提示中嵌入不可见的 Unicode 撇号变体和日期格式变化,作为隐蔽水印标记。这些标记会在特定条件下触发,例如将请求路由至竞争对手 AI 提供商域名、使用中国时区等。该行为并非可开关的遥测功能,而是隐写术——将数据隐藏在其他数据内部。

Claude Code 拥有 shell 权限,能读写用户文件、执行命令。这种在视觉不可见的字符层面进行指纹追踪的做法,超出常规隐私妥协范畴。付费用户(如 Max 计划)同样被监视,且社区对此反应较为平静。若其他工具效仿,开发者将难以审计其所信任的编码助手究竟还隐藏了什么。

#开发者 #工具 #Anthropic #ClaudeCode #隐写术 #Unicode #安全 #隐私 #追踪
📢 频道:@DevToolboxHub
@DevToolboxHub
Post #1181 3
GraphRAG架构演进与知识图谱策略

Cassie Shum 在 InfoQ 演讲中探讨 GraphRAG 的架构演进,指出传统向量 RAG 在面对全局上下文、多跳推理和来源追溯时存在不足。她分享了企业构建语义结构化知识图谱的策略,将编排逻辑下沉至数据层,从而提升 AI 工作流的智能性。

#开发者 #工具 #GraphRAG #知识图谱 #RAG #InfoQ #CassieShum #RelationalAI #多跳推理 #架构演进
📢 频道:@DevToolboxHub
@DevToolboxHub
Post #1180 3
Zustand 代替 Context 管理 Next.js 全局状态

React Context 在全局状态管理中是内置方案,但存在根本问题:context 值变化时,所有消费者都会重渲染,即使用户只关心其中一个字段。拆分多个 context 可以缓解,但代码迅速膨胀。

Zustand 通过基于选择器的订阅机制解决此问题:组件只订阅自己需要的 state slice,其他字段更新时不会触发自身重渲染。API 简洁,迁移成本低。

核心对比与关键模式
Context 的重渲染问题:
任何用户状态(user/preferences/notifications)变化都会导致所有 useContext(UserContext) 的组件重渲染。
Zustand 的选择器订阅:
每个组件只在其订阅的字段变化时重渲染。例如 Header 只监听 user,NotificationBell 只监听 notifications。
生产模式(TypeScript + Persist)
使用 create<State>() 创建 store,搭配 persist 中间件自动同步 localStorage。partialize 控制持久化字段,临时状态(如 jobId)不持久化。
Server Component 集成
服务端数据通过 props 传递,客户端 UI 状态由 Zustand 管理。
计算状态与 useShallow
通过选择器计算派生数据(如 pendingCount)。useShallow 防止对象选择器因浅比较失效导致不必要重渲染。
何时仍用 Context
一次性初始化(主题、会话)cache 不变时;库自带的 context API(React Query、React Router);组件树极小且同时渲染。
迁移清单
创建 store → 替换 useContext 为 useMyStore(selector) → 移除 Provider → 对象字段用 useShallow → 删除 context 文件。
测试
直接调用 getState() 和 setState(),无需挂载组件。


Zustand 核心优势:细粒度订阅、简洁 API、良好 TypeScript 支持、不受组件树限制(可在 WebSocket 等非 React 环境直接调用 getState 更新状态)。对于 Next.js App Router 中大部分客户端状态需求,Zustand 是比 Context 更优的默认选择。

#Nextjs #Zustand #React #状态管理 #开发者 #工具 #状态管理库
📢 频道:@DevToolboxHub
@DevToolboxHub
Post #1179 4
AI 写代码,开发者何去何从?

Anthropic 发布了一篇关于递归自我改进的文章,探讨 AI 系统如何越来越多地参与构建未来更好的自身版本。这篇近乎科幻的文章指出,当目标明确时,AI 在编码、测试、重构和审查代码方面的能力将越来越强。

但作为开发者,更有价值的问题不是“AI 是否会取代我们”,而是“如果 AI 能写、测、改、审代码,人类在软件开发中的真正角色是什么”。多年来,衡量开发者工作的一大指标是产出代码的能力——构建功能、修复 bug、优化系统、重构和审查。如今,这些活动中有相当大一部分可以被 AI 工具加速。

这意味着开发者的价值正在从“执行”转向“决策”——决定什么该被做。当 AI 能在几分钟内完成过去数小时的工作时,瓶颈不再是代码产量,而是人类审查、验证和理解的速度。近未来的开发者将是拥有不可被 AI 替代的判断力的人。如果团队仍然沿用 2015 年的思维方式、僵化流程和低协作习惯,即使有了强大的工具,生产力提升也会受限。

#开发者 #工具 #Anthropic #递归自我改进 #AI编程 #判断力 #工程效率
📢 频道:@DevToolboxHub
@DevToolboxHub
Post #1178 4
Flutter 应用生物识别认证实现指南

在移动应用中,生物识别认证已成为安全与便捷的标配。本文基于官方 local_auth 插件,整理了在 Flutter 中集成指纹、Face ID 等生物识别的生产级实现方案,并指出了常见误区。

第一步:添加依赖 local_auth: ^3.0.1 并运行 flutter pub get。第二步:在 Android 的 AndroidManifest.xml 中添加 USE_BIOMETRIC 权限,iOS 的 Info.plist 中配置 NSFaceIDUsageDescription。第三步封装 BiometricService 类,检测设备支持、获取可用类型、执行认证。第四步在 UI 中调用 authenticate() 方法,自动适配 Face ID、Touch ID 或指纹。核心逻辑无需区分平台,local_auth 自动处理底层差异。

常见错误:

• 未检测设备支持
• 漏掉 iOS 权限
• 不提供 PIN 回退
• 强制开启生物识别
• 错误处理粗糙
• 未测试前后台切换及锁定场景
• 将生物识别视为唯一安全层(须与后端 token 结合)。最佳实践是保持逻辑独立
• 始终提供备选方案
• 尊重用户选择
• 在真机测试

#开发者 #工具 #Flutter #生物识别 #local_auth #移动开发 #认证

📢 频道:@DevToolboxHub
@DevToolboxHub
Post #1177 7
Midnight 屏蔽代币合约常见错误与修复

Midnight 的 Compact 语言与 EVM 世界截然不同,构建屏蔽流动性 DeFi 合约时极易踩坑。作者在数月实践中整理了 6 个最致命的错误及正确模式,每个错误都曾导致电路中断或证明服务器失败。

背景:Zswap 协议与屏蔽代币的运作机制
当用户调用 receiveShielded 向合约转账时,Compact 运行时记录接收义务,证明服务器随后生成 ZK 证明。但合约只描述了自己的行为,交易还需平衡:收到的代币必须来自用户钱包。钱包根据 ShieldedCoinInfo(币种颜色和金额)在用户隐私币集中找到对应 UTXO,生成 Zswap 所有权证明。ShieldedCoinInfo 必须作为电路参数传入,因为钱包需要它在构造交易时确定待平衡的 UTXO。

错误 1:为每种资产分别创建独立 QualifiedShieldedCoinInfo 账本字段
这会导致证明构造问题和账本状态不一致,且无法扩展新资产。正确做法:使用 Map<Bytes<32>, QualifiedShieldedCoinInfo> 按币种颜色统一管理所有屏蔽资产。

错误 2:在同一个电路中同时接收和发送同一币种的屏蔽代币
这会导致公开输入不匹配错误。receiveShielded 和 sendShielded 操作会修改同一个 UTXO 槽位,证明服务器无法平衡等式。正确做法:拆分为两个电路——一个只接收并更新状态为待处理,另一个只发送并验证状态。
例外情况:接收一种代币并铸造另一种(如 LP 代币)或接收后立即通过 sendImmediateShielded 销毁,因不涉及同一 QualifiedShieldedCoinInfo 可合并。

错误 3:将屏蔽代币余额当作非屏蔽余额对待
合约不会自动追踪屏蔽 UTXO。若收到存款后不显式存入 contractShieldedBalance 账本,该 UTXO 将永久丢失。每次 receiveShielded 后必须调用 insertCoin。

最佳实践 4:始终将 ShieldedCoinInfo 作为电路参数传入
不要在电路内部推导代币信息。钱包需要读取参数以选择 UTXO 并生成所有权证明。前端从钱包 API 获取可用币列表,构造 ShieldedCoinInfo 后传入。

错误 5:将每笔存款作为独立 UTXO 存储
用 Set<QualifiedShieldedCoinInfo> 积累 UTXO 会导致发送时需手动筛选合并,逻辑复杂且脆弱。正确做法:每次存款用 mergeCoinImmediate 合并到同一颜色的单一条目中。

错误 6:发送后未处理找零
sendShielded 不会自动返回找零。必须检查返回的 result.change,若有则 insertCoin 存回,若余额完全耗尽则 remove 该条目。否则下次发送将因 UTXO 已被花费而失败。

总结:可靠模式
状态设计:一个 Map<Bytes<32>, QualifiedShieldedCoinInfo> 作为所有屏蔽持有的单一事实来源;其他记账用独立非屏蔽账本。
接收:接受 ShieldedCoinInfo 参数 → receiveShielded → mergeCoinImmediate 合并
发送:查找余额 → sendShielded → 处理找零或移除
同一 QualifiedShieldedCoinInfo 的收发必须拆分电路。
安全例外:接收+铸造不同代币,或接收+立即销毁。


这些模式来自大量试错,希望帮助后来者节省时间。

#开发者 #工具 #Midnight #Compact #Zswap #ShieldedTokens #DeFi #ZK
📢 频道:@DevToolboxHub
Older posts →
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →