


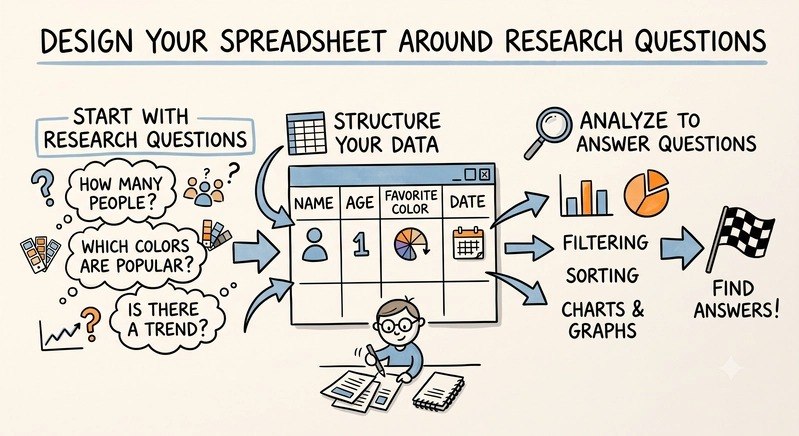

一个常见错误让2000+个Issue几乎无法用于分析。作者分享了一套从信息到证据的六步结构化方法:按社区元数据、开发者角色、工作流阶段、运维分类、技术上下文、研究问题设计表格,将Issue变成可回答具体问题的研究数据集。
第一步:记录社区活动元数据(标题、类型、标签、状态、创建/关闭日期、解决时间、关联PR、对话摘要),用于分析社区响应速度、维护者负载与项目健康度。
第二步:从技术上下文推断开发者角色(平台工程师、DevOps、ML工程师、软件工程师、数据科学家、SRE),发现不同群体的摩擦点。
第三步:将工作流拆解为阶段(安装→配置→模型下载→运行时初始化→就绪→网络→推理→扩缩容→版本升级),定位故障最高发环节。
第四步:将部署问题与运维问题分离,分别建立可观测性、Day-2运维、维护等独立工作流,各配备具体记录项(如检查日志、查看K8s事件、分析延迟等)。
第五步:记录产品版本、Kubernetes版本、运行时、模型族、部署类型、基础设施、存储后端、GPU/CPU使用等技术上下文,用于回答版本相关、运行时相关等具体问题。
第六步:先设计研究问题,再反向检验每个表单列是否服务于至少一个研究问题;不支持的列直接删除。如此确保采集的是证据,而非泛泛数据。
最终,不再手动重读数百条Issue,而是直接识别模式、量化痛点、对比版本、定位工作流瓶颈、分析角色差异、创建仪表盘、生成量化指标,乃至输出有证据支撑的建议。结构化数据让每次分析更快、更准、更可操作。
#开发者 #工具 #GitHub #Issue #Devex #开发者体验 #数据分析
📢 频道:@DevToolboxHub