
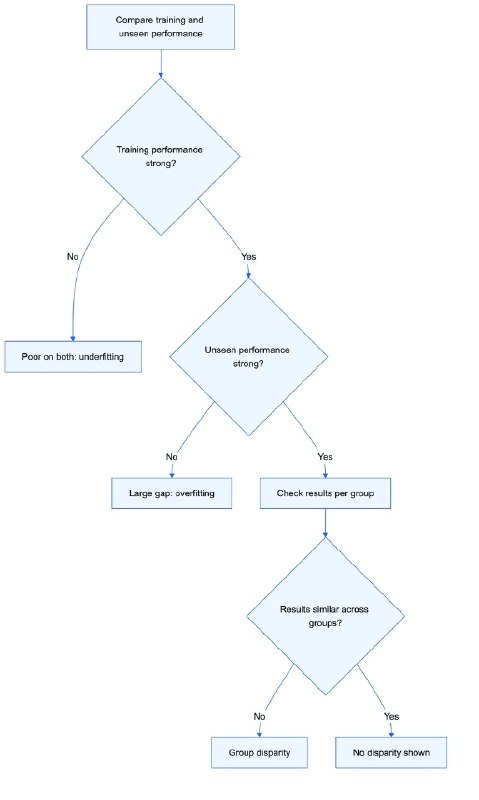


备考 AWS Certified AI Practitioner 时,偏差与方差是高频易错点。核心判断逻辑只有一条:训练集与未见数据的表现差异,指向欠拟合或过拟合;不同人群之间的表现差异,指向社会性偏差。选检测工具前,先确认证据描述的是哪类问题,再按检查发生的时机匹配工具。
考试里的“bias”有两种含义。统计偏差指模型过于简单,无法捕捉底层规律,在训练集和未见数据上表现都差,即欠拟合。社会性偏差指结果在不同人群间系统性不同,模型整体表现可能很好,但对某一群体明显更差,这是公平性问题,不一定是拟合问题。题目提到训练准确率、未见数据准确率、过拟合或欠拟合,指向统计偏差;提到公平、人群、结果不均等,指向社会性偏差。方差则是模型对训练数据的敏感度,高方差表现为过拟合:训练表现极好,未见数据表现差。判断依据是训练与未见表现之间的差距。
数据集特征分四类:包容性问群体是否存在,没有记录就无法学习,也无法计算该群体指标;多样性问数据是否覆盖真实场景范围;平衡性问各群体比例是否可用,群体存在但数量过少仍会影响训练目标;策展数据有已知、经过筛选和记录的来源,可追溯来源但不保证中立。例如一组 40000 条、另一组 300 条,属于平衡性问题而非包容性问题;若第二组完全没有记录,则需先采集数据,重新加权无从谈起。偏差还可能来自采集、标注、训练、部署或反馈环节,标注标准不一致时,重新平衡数据集无法修复有偏标签。
总体准确率不能证明公平。94% 的整体准确率可能掩盖少数群体的低准确率。正确做法是子群分析:对每个相关群体分别计算同一指标,再沿采集、标注、训练、部署、反馈追溯差异。移除人口统计字段并不可靠,其他特征可能成为代理变量,且移除后无法计算分组指标。
工具选择看时机:SageMaker Clarify 做时间点偏差测量,可评估训练前数据和训练后模型,适合判断当前是否有偏;SageMaker Model Monitor 持续监控已部署模型的数据、质量和偏差相对基线的变化,适合上线后漂移场景;Amazon A2I 在推理时把单条预测交给人工审核,适合需要人工判断的个案,不能用来计算群体级偏差。标注质量分析检查标签是否正确一致,人工审计则用于发现未被指标覆盖的隐忧。