
Вдогонку к посту: очень хочу увидеть какие-нибудь работы по оценке объективности эвалюации GPT-4 других языковых моделей. Например, авторы The False Promise of Imitating Proprietary LLMs пишут про то, что оценки людей-разметчиков и GPT-4 были очень согласованы между собой, а потом в статье показывают, что разметчики не обращали внимание на фактологчность и просто предпочитали стиль ответа а-ля ChatGPT. Получается, GPT-4 тоже стиль скорее оценивала?
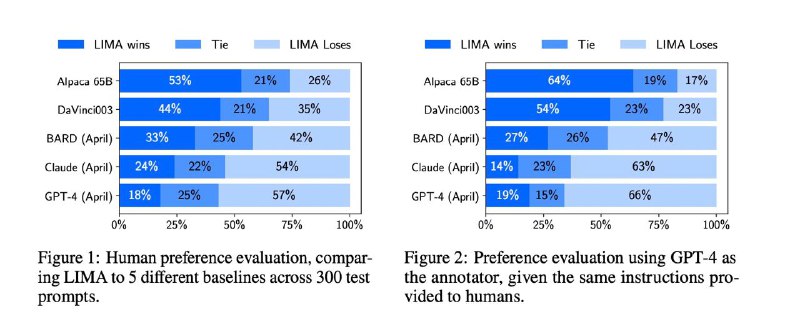
Авторы Less is More for Allignment аналогично сравнивали разметку людей и GPT-4 для своей модели LIMA – это LLaMA 65B, натюненная на 1000 хороших human-annotated ответах. На графике например видно, что свои собственные ответы GPT-4 оценивала гораздо выше, чем отмечали люди. Я собственно думаю, что «успех» LIMA на эвалюации был ровно в том, что она выучила стиль, который зашел и людям, и GPT-4, так как из 1000 примеров огромных скилов и знаний она не могла почерпнуть
Этот баес, кмк, нужно хорошо исследовать. На downstream задачах можно посчитать качество автоматически и получить какую-то более или менее объективную оценку. А диалоговую генерацию и всяких all-purpose assistants все чаще сравнивают через GPT-4, что, может быть, порождает совсем не достоверные результаты
Post #955
2.4K
- 👍 12
- ❤ 1