
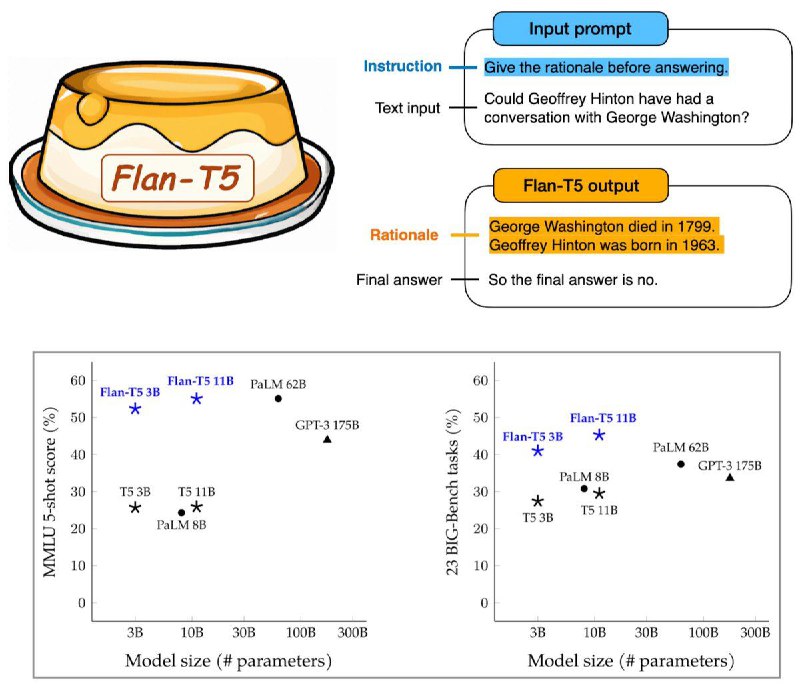
Google тут выпустил новую модель FLAN. Примечательна она тем, что скейлили ее и up, и down (540B и 3B). FLAN 3B бьет на few-shot и на BIG-Bench GPT 175B, и подходит очень близко к PaLM 62B
Какой-то особой хитрости тут нет, как всегда все упирается в тенировочные данные. Обучали с помощью Chain-of-thought (про это я рассказывала тут) – если попросить модель расписать свой ход размышления или даже просто добавить к промту let’s think step by step, она будет перформить гораздо лучше. Раньше это реализовывали именно post hoc через промтинг, а это первая модель, где тренировали на данных с CoT
Плюс, к этому насобирали еще 1800+ разных задач, типа question answering (включая с привлечением внешних ресурсов, когда модель сама может подсмотреть в ту же Википедию), topic classification, cause effect classification, commonsense reasoning, сode repair и многие другие
В целом мне нравится модель тем, что еще раз доказывает, что scaling is not all you need, качество данных, как показал еще PaLM, очень сильно решает. Чем больше разных задач вы предложите модели, тем лучше она будет генерализоваться, даже на других задачах, которые во время обучения модель не встречала. Авторы специально не включали часть тасков в обучение, чтобы потом проверять на них – туда попали, например, задачки по математике, логике и вопросы по философии
Post #871
2.18K
- 👍 16
- 🔥 8