
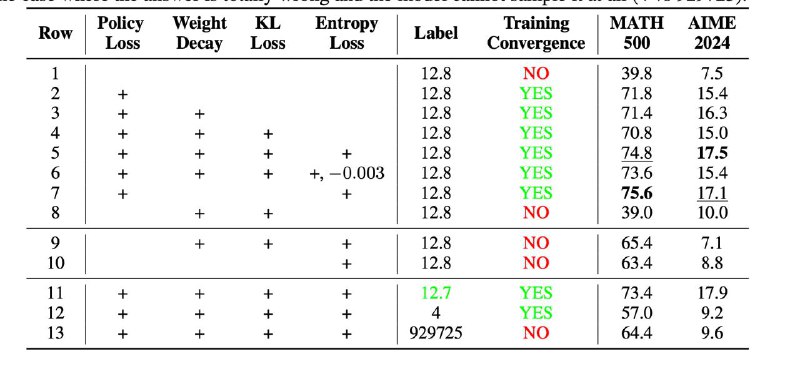
Параллельно с этим, в статье выдвигается гипотеза, что post-saturation generalization происходит во много благодаря тому, что повышается разнообразие ответов, которое семплируется в процессе обучения (так выше вероятность, что хотя бы какие-то способы решения будут правильные, и они будут поощряться RL-алгоритмом). Например, если обучаться с низкой температурой (t=0.6) и без entropy loss, то дальше 150-ого шага никаких улучшений не наблюдается. В связи с этим в статье есть еще очень интересный эксперимент, когда модель обучали только с entropy loss, то есть не уделяя никакого внимания реворду, просто повышали энтропию и тем самым поощряли более разнообразные ответы. На удивление, такая модель тоже показывала рост качества на тесте, хотя конечно не такой сильный (+8% в среднем для 6 бенчмарков). Из этого всего авторы заключают, что в GRPO главным образом доминриует эффект policy loss, который одновременно заставляет модель придерживаться эмпирически выигрышных стратегий при решении ответа, но при этом имплицитно осуществляет регуляризацию за счет того, что модели все равно нужно продолжать корректно решать тренировочный пример. При этом, очень важно параллельно повышать энтропию, за счет температуры и/или entropy loss.
Также в аблейшенах авторы показывают, что обучение на примере из определенного раздела математики бустит качество и на других разделах (я предполагаю, и на коде тоже бы оно поднялось). При этом, задачка из, например, геометрии может больше всего поднять скоры на теории чисел, а не на самой геометрии. Из чего можно предположить, что здесь происходит не переобучение под какой-то домен. Еще один интересный факт – если в ground truth ответе есть небольшая погрешность (например, 12.7 вместо правильных 12.8), то это почти не мешает модели обучаться. Но если там какая-то существенная ошибка, то это даже хуже, чем обучаться просто на бессмысленном ответе
Post #1065
5.49K
- 🔥 23