

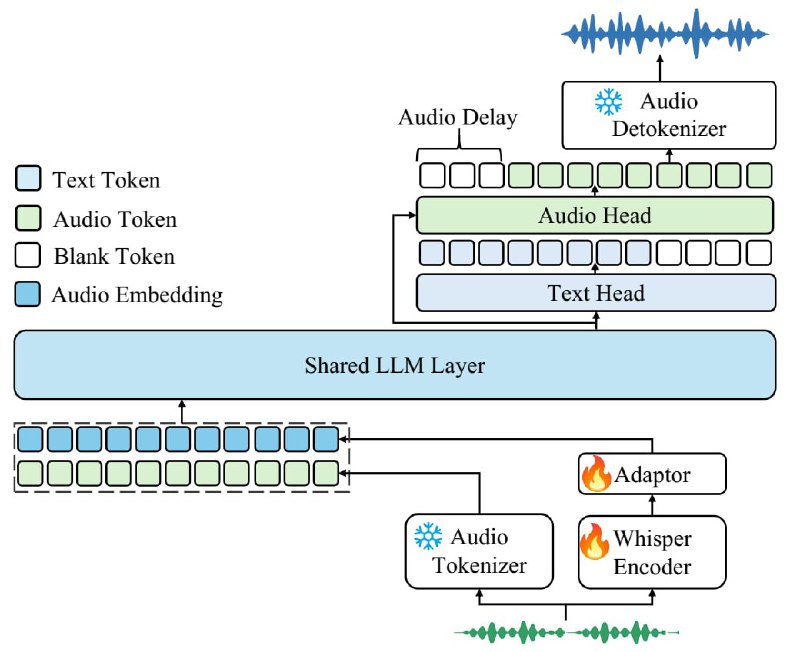

Она работает через гибридный токенизатор, доработанную LLM на базе Qwen 2.5 и быстрый детокенизатор, что позволяет обрабатывать звук почти без задержек.
Модель обучалась на 13 млн часов аудио и показывает лучшие результаты в задачах ASR, эмоционального анализа и аудиовопросов.
В диалогах Kimi-Audio почти догоняет GPT-4o по качеству. Всё это доступно в открытом доступе — лицензия MIT.
❤️ GitHub
❤️ Data Signal