TGViewer
Channel Public Channel
Data Nature 🕊

Data Nature 🕊

@datanature

Канал о жизни BI аналитики и инфо-дизайна в корп реалиях с фокусом на работающих практиках управления.
Веду как летопись полезного для себя и людей с такими же неврозами.

александр бараков @alexbarakov
datanature.ru
data-nature.com

(рекламу не размещаю)
Subscribers
6.22K
Photos
408
Videos
7
Links
214
Recent Posts 14 shown
Post #506 1.48K
Когда AI-гонка и корп-политика подзаёбывает — люди делают настолки.

Все же играли в Codenames?
Сделал с клодексом по ее мотивам — Data Bingo, бесплатную онлайн-версию про профессиональный жаргон.

Мы в миллениальских командах играли в такое в офлайне и пытались утащить в удалёнку. Сейчас все команды распределённые и в офис ходить разучились. Не хватает чего-то человеческого.

При запуске игры выбираешь
- Колоды: Data Governance, BI, Data Analytics, Product Analytics, Agentic Analytics, ML/DS, Data Visualization, Дата-инженерия, Системный анализ. Плюс классическая колода обычных слов, если хочется просто поиграть.
- Уровень сложности: базовый, профессиональный, продвинутый

Наборы и уровни складываются. Можно смешать BI с обычными словами и играть расслабленно. А можно собрать поле только из третьего уровня Agentic Analytics и смотреть, как команда страдает.

Наведёшь на карточку — всплывает определение термина (их там под 1000). Побочный полезный эффект: ньюкамер узнаёт ваши термины вместо онбординга, одни роли узнают больше про жаргон и работу других ролей. Гипотеза - что игроки будут объяснять слова друг другу, переопыляться.

Никакой регистрации: Создал комнату → кинул ссылку/код коллегам. Всё. Заходите в зум и тусите под чаек.
Нужно минимум 4 человека: по капитану и игроку в каждую команду.

Ссылка на игровой сервер

Кто в теме - потестируйте и напишите фидбек, как оно.
У меня работает)
Вообще идеально раз в месяц иметь в команде вечерний game hour. Надо же беречь кукушку - и свою и командную. По коллежски.

Сервис на моей виртуальной машине.
Никаких перс данных не собираю и не храню.

Можно допилить под свои словари и внутренние мемы, будет прикольнее.
Кому интересно - пишите, пошарю репу.

1,5 года назад думали над дата играми, но так и не случилось. Сейчас 2 вечера и рабочая версия.. мда
Post #505 2K
Агенты по сборке роудмапов/стратегий по BI(+AI) и DG для самоконсалтинга

Запек тут материалы и транскрибации своих курсов и миро-досок в репозиторий со скиллами.

- https://github.com/alexbarakov/DG-strategy-self-consulting-agent-ru
- https://github.com/alexbarakov/BI-strategy-self-consulting-agent-ru

Здесь (как впрочем и везде) нет магии и автопилота. Это скорее подспорье и ускоритель.

Можно сейчас без всяких доп скиллов скормить информацию про свою команду/продукт/функцию в модель и получить кучу условно-релевантного текста.
Моя попытка про повысить пользу - убрать навес общих концепций, бюрократии и булшита, фантазирования в духе за все хорошее.

Полученные агенты имеют в себе
- адекватные на мой взгляд атомы методологий,
- движок задавания правильных вопросов,
- генертаор инициатив на базе as is анализа, с учетом специфики и с ограничителями на булшит,
- ревью скептичным CDO судьей.
Где данных нет, скилл пишет [не хватает данных] и какого замера не хватает.
В итоге дает результат в емком формате 6 (условно) страниц.

Три режима
FORM — собрать стратегию с нуля: интервью, диагностика зрелости, документ
AUDIT — прожарить то, что уже написано
CONSULT — спросить, разобрать свой кейс

Результаты моих тестов сдержанно положительные. Как минимум любопытно). С напильником можно получить в целом заземленный драфт. Голденсеты для оценки качества я пока не добил, задачка нетривиальная. А генерить эвалы на вымышленных компаниях не супер эффективно.
Если развивать, то уже на базе проревьюинных реальных примеров стратегий для индустрий (банк, тех, ритейл, ...)

В общем, ставите себе, прогоняете на своей компании, делитесь фидбеком. Без сверхожиданий.

Как поставить: просто дайте своему клодексу ссылку и попросите поставить, перезапуститесь. No brainer
Посмотреть без установки: В репе - есть html/md с прогонами на вымышленных компаниях.
Как помочь: прогоните FORM на своей компании — в лайт-режиме это минут пятнадцать. Напишите, что получилось и где скилл соврал нафантазировал (или упакуйте и пришлите трейсы).
GitHub GitHub - alexbarakov/DG-strategy-self-consulting-agent-ru: Русская редакция базы знаний DG Program Guide: входная поверхность,… Русская редакция базы знаний DG Program Guide: входная поверхность, обзоры скиллов и два готовых прогона стратегии. Производная от DG-strategy-self-consulting-agent. - alexbarakov/DG-strategy-self-...
Post #502 2.73K
Наблюдаю за тем, как копится раздражение от ИИ контента. У себя и коллег-менеджеров.

Получаешь презу, html лонгрид с графиками, конфлю документ с признаками генерации - и делаешь усилие чтобы не закрыть сразу.
Потом спрашиваешь автора - сколько итераций ревью было, насколько вычитано.

И сам, когда шаришь что то - добавляешь, что цифры и текст детально проверил. Или (извиняясь) проверил но.. бегло. Дескать экпресс анализ.

Когда большая часть интеллектуального контента превратилась в коммодити, стало важно сколько в нем человека. Не в смысле авторства, а насколько кто-то может за него пояснить, взять ответственность, принять или рекомендовать решение/действие. Иначе бесит.

ИИ щедр на буквы, замыливание незначимым значимого, правдоподобные ошибки - и нужна общая инфо-гигиена, zero bullshit policy, иначе это все выжигает ресурс смотрящего.

Ничего особо странного.
Но забавно.
Одной рукой пушим и множим, другой отгораживаемся.
Post #501 3.17K
Semantic Layer все понимают по-разному.
Кто-то помнит про LookML, другой работал с dbt metrics, третий шарит за cube.dev, atscale и другие семантические платформы.

В России Semantic Layer принято рисовать в стратегии, но в итоге вечно двигать на будущее. Нет очевидных решений в рынке и слишком много легаси под дешами нужно перелопатить. Да и ущерб от отсутствия был прямо скажем приемлемым. Так было до новой волны инвестиций в ИИ.

Пообщались на прошлой неделе с Artyom Keydunov (CEO того самого сube.dev) о том, как концепция семантик слоя для унификации метрик для дешей сменилась на семантик для агентов. Мысли со встречи:

1. Семантический движок и Runtime и становится самым важным компонентом
Сложность уже не в унификации метрик, а в их исполнении.
Runtime преобразует бизнес-запрос в план выполнения +security, governance, RLS.
А Execution Engine - решает:
Что материализовать?
Что считать на лету?
Когда создать новый агрегат?
Когда удалить старый?
Как не материализовать всё подряд?

Материализовывать под каждый нужный разрез — не вариант.
Если не материализовать ничего - дорогой Runtime.
Вопрос как научить движок выбирать стратегию исполнения — ключевой.

2. Text-to-SQL → Text-to-Semantic. Архитектура, где агент каждый раз пишет SQL, дает хуже точность, стоит дороже. В идеале спрашиваем "Дай Revenue по Country" - а Runtime уже знает: где данные; какие join, grain, формула.

3. Cube больше не считает BI своим основным рынком
Раньше Semantic Layer был для Tableau, Power BI и других BI-инструментов. Но это уже не очень хороший бизнес. BI вендоры стремительно теряют клиентов и рынок. Теперь AI-агенты будут напрямую consum'ить Semantic Layer.

Уже просматривается следующий уровень, когда не человек будет спрашивать данные, а Product Agent, Marketing Agent, Experiment Agent.
То есть вопрос не «как человек получает инсайт», а «как агент получает доверенную метрику».

4. Никто не знает, какие комбинации интерфейсов победят: Claude/codex Desktop, MCP, CLI, Skillhubs, свои дата порталы или чаты в корпмесенджерах. Поэтому Cube развивает все и идет в Ассистентский UI. Главный конкурент в мире не dbt, а Snowflake и Databricks.

——————-

Короче сегмент Semantic Layer пришел в движение.
Можно сказать, что он разделился на Semantic Editor (про заведение и управление metrics + dims + filters = SQL) и Semantic runtime & engine (про то, как выполнять запросы и материализовывать).
Есть хорошая статья Насти Остапенко про эти типы.

В России нет решений этого уровня (или есть?). То, что есть пока ориентированы на старую модель работы с BI. Есть движение в эту сторону: Trisigma Авито, Datalens Яндекса. Есть mvp решений, типа dataforge от питерских ребят.
Помогите продолжить список.

Кажется самое интересное в AI сейчас происходит не вокруг моделей, а вокруг инфраструктуры и архитектуры для них.
Post #499 9.34K
AI не готовность - пост о том, как препарируем доменные данные и контекст в Авито

Антропик напомнил всем кто забыл, что Text2sql бесполезен, если он не шарит в данных домена. Мы догадывались.
Одна из тестируемых тут идей - AI-ready score в целях тимлидов доменов.

Это булевые проверки условно трех групп:

- Роли и в домене (BI-партнёр, Куратор метрик, AI-чемпион). Скучный компонент, но без гавернанс-людей никак;

- Разметка каноничных объектов. Смотрим, что доля трафика через сертифицированные здоровые витрины, деши и метрики не ниже таргета.

- База знаний домена - 11 типов контекста в репозитории: FAQ, глоссарий, lineage, примеры text2sql, eval-кейсы, деревья метрик и др.
Генерация этого контекста - это тоже скилл, встроенный в работу - решил задачу -> закинул агентом PR в базу контекста. Автогенерённые объекты засчитываются только после ревью.

Всё это пока про покрытие.
Качество сразу после: golden sets по типовым задачам + трейсы от AI-дежурных дают базу для тюнинга.
Будет понято, какие эвалы фейк, какие знания - балласт.

AI-дежурные и ассистенты это морковка спереди, рост доли их успешно отвеченных эдхоков в чатах - мотивация вкладываться дальше в контекст.

Замеры в этой части пошарю позднее.

Если интересно включится - все еще есть вакансии в BI

#АвитоBI
Post #498 2.51K
пхахахах, картинка угар, сори, не мог не запостить 🤨

🎙Через месяц проведем программу «Разработка BI+AI стратегии» — ежегодные живые воркшопы для BI/Data лидеров.
📅 5–28 августа • 11 дней по 2,5 часа в 18.00

AI-стратегии сейчас писать не лучшее время — никто не понимает ничего, кроме вектора и горизонта пары месяцев. Но и развивать BI без ИИ нет смысла.
Тот случай, когда программа нужна мне самому. Нужно обстучать весь этот поток гипотез, переопылиться.

Старые темы теперь с "ИИ":
– Self-Service, Reporting Factory и теперь Agentic BI: что ИИ каннибализирует, а где сертифицированный репортинг остается;
– Карго-культы в AI: самолёты летающие и соломенные «AI-ассистенты»;
– Data и content management: сертификация, health score, архивация — как не утонуть в собственных витринах и отчётах c приходом AI-слопа;
– Почему text-to-SQL демо работает, а в проде врёт — и причём тут semantic layer, core-витрины и доменный контекст;
– Вайбкодинг в BI-команде: почему это уже обязательный тулинг и «как знать меру»;
– Core слой витрин как «здоровое питание» AI-аналитика вместо фастфуда из 6000 витрин низкого качества;
– Дата-каталоги и глоссарии наконец взлетят — но не для людей, а для AI-агентов;
– Метрики BI и какие новые шансы посчитать таки time-to-insight, Saved FTE и проч

Все это и прочее в режиме живых обсуждений, разборов кейсов друг друга — участников и топ-компаний. Апдейт контента примерно 50% vs прошлый год.
Заходите. Мест немного.

👉 https://biconsult.ru/bi-strategy-barakov
Post #496 3.36K
Насмотренность на гавернанс данных дает мрачный образ будущего для гавернанса контекста.

Сегодня в тех компаниях строятся планы:
Соберем весь контекст, свяжем все знания компании в context/knowledge graph. Сделаем AI понимающим бизнес.

Десять лет назад примерно так же выглядели обещания от Data Governance:
Соберем все метаданные. Построим каталог. Назначим владельцев. Опишем определения. Наступит порядок.

Пока у меня есть только вопросы и гипотезы.

Делюсь чтобы собрать мнений.

1. Больше контекста = выше качество AI?
В кейсе Anthropic агент получил доступ к большому корпусу SQL, дашбордов и аналитических артефактов. Качество почти не выросло.
Во многих ошибочных ответах нужная информация находилась внутри доступного корпуса. Проблема была в выборе правильной сущности.
Ценность создавал не объем контекста, а уменьшение пространства выбора.

Большая часть рынка сегодня инвестирует в: knowledge graph; semantic layer; metadata; context. Anthropic пишет что после определенного уровня зрелости дополнительные знания дают меньший эффект, чем качественные процедуры, зашитые в skills: какие источники когда использовать, в каком порядке, с какими проверками и уточнениями.

2. Можно ли через AI собирать, создавать, валидировать контекст Компании?

DataHub исходит, что значительная часть контекста уже существует, просто разбросана по системам. Тут AI явно может помочь с Context Mining — поиском отсутствующего контекста.

Anthropic говорит, что самого важного слоя - бизнес-контекста - в системах нет: почему метрика считается именно так; почему существует исключение; почему доверяют именно этому источнику; почему было принято именно такое решение.
Такой контекст нужно создавать человеку.

Распределенная ответственность за валидацию контекста выглядит одним из главных рисков. То, из-за чего не взлетает DG — человеческий фактор.
Тут AI уже умеет:
находить противоречия;
находить устаревший контекст;
выявлять пробелы;
сравнивать версии;
запускать проверки, evals.

Возможно, мы движемся от модели: AI → Human → Approved
к модели: AI → AI Review → Human для конфликтов.
Но не факт.

3. Что вообще тащить в Context Layer?

На первый взгляд хочется построить новую систему и собрать туда все.
Сделать еще одну устаревающую копию реальности.
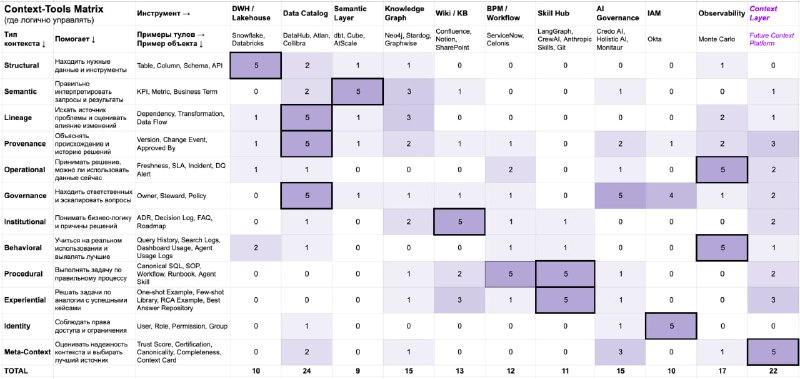
Кажется, Context Layer не должен управлять контекстом.
Скорее собирать связи о разном контексте из мастер-систем без дублирования (накидал матрицу на фото)

...и добавлять критичную инфу про:
Trust;
Certification;
Freshness;
Canonicality;
Completeness.

4. Кто такой Context Engineer?

Если контекст становится стратегическим активом, кто-то им должен управлять.
«Context engineering» расщепляется на две роли:
(1) Context Engineer — собирает контекст под конкретного агента: skills, retrieval, tools, evals. Чинит ошибки. Ближе к Analytics Engineer / BI.
(2) Context manager — роль а не позиция. владеет доменным слоем контекста. Эволюция Data Governance / Steward роли.

Откуда только этим людям взять capacity на это? Другие задачи никто не снимал. А эффективность от AI массово не наступила.
Post #495 3.16K
Эфир Visiology Cortex про их next gen BI прототип вызвал тут обсуждение в закрытых чатах и резонирует с тем, как мы строим свой BI тулинг в Авито.

Начну с предложения всем посмотреть, Иван с командой хорошо копает в продуктовые гипотезы, дает часто независимую аналитику. Ищут новые сценарии в BI и делятся.

Кто посмотрел - давайте обсудим (тут нет правильных ответов).
Закину свои мысли подробнее, с переходом в душноту:

15:05 Иван начал с того, что разложил базу про основные AI+BI группы юзкейсов. Тут все по делу:
- вайбкодинг в BI стоит своих токенов, годится для ресерча, прототипа, администрирования, но для прода все еще много правдоподобно ошибается, требует реворка/ревью. Ценность межуется с потерями. Всем пробовать.
- чат с базой данных (Text2SQL) работает, но точность сильно зависит от семантического слоя и системы управления контекстом, которые никто в реальной жизни (пока) не построил.
- ИИ помощники в BI, тупо полезные встроенные тулы, которые где то сильно (код), где то не сильно (визуал) ускоряют разработчика.

Потом начинается демо.
Красивое вендорское демо - смелое, с предположениями, иногда далекими от жизни:

32:19 cortex визы, новое поколение self service аналитики в понимании visiology.

Вопрос - почему юзера с бизнес-вопросом отправляют конструировать (пусть и с агентом) подключение? В это пойдет casual explorer а их обычно 5-7%. Кажется правильнее исходить, что качественные сорсы/квери уже размечены для агента аналитиками/BI. Наоборот надо предотвращать тут создание новых сорсов, коннектов неаналитиком.
Первый кусочек продуктового легаси и идеализма. Из области для атоса (юзера) это слишком много, для графа де ла фер (биайщика) слишком мало.

- Далее флоу ведет к генерации метрик.

Первый вопрос зачем их давать так свободно генерить, а не брать из сертифицированного стора ? (риск утраты так долго выстраиваемой версии блять правды)

Второй вопрос - как решена в генерации проблема правдоподобных и скрытых ошибок в логике? Ребята стильно обошли семантического слона в комнате, о котором вели речь в начале ролика.

Третий вопрос — зачем генерить визы и заставлять в них вникать, когда можно сразу ответить на вопрос.
При этом выдача набора виджетов фактоида, с динамикой и основными разрезами сама по себе хорошая фича. Но кажется нужна по спец запросу или уже для креатора.

- Потом клац - на этом "сорсе" с "метриками" селфсервис юзер создал "деш". Тот же наброс — пушим в старое, не? Такое осядет мусором на сервере. Если только в личный сендбокс без шаринга если приспичило.

Сама по себе генерация дешей на базовом виздвижке и доработкой стандартными средствами — это хорошо. Но мы в Авито вероятно от этого пока откажется - слишком дорого, оставим агенту весь JS и не будем мучить всех сборкой дешей на бедной drag-n-drop библиотеке чартов. С UI чата - ожидание от неаналитика в создание визов руками уходит, а профики будут ваять с агентом на JS.

- Короче не хватило встроенного гавернанса - иначе ai-driven серфсервис это немного про обезьяну с грантатой - засрет все BI-слопом и положит dwh кверями.

43:53 - Аватар. Не до конца понял. Пока выглядит как простой rules-based алертинг. Проблема всех алертов была и останется
- в массовом false positive срабатывании чекеров. Поэтому все дайджесты инсайтов в итоге или отключают или пускают через проверку кожаным.
- в плохом выявлении причин событий автоматикой. Тут возврат к системе управления контекстом + агенты судьи. Без этого все тлен (с этим впрочем возможно тоже)).

47:07 - Лаборатория - норм, переупаковка Клода в контуре BI системы. Вопрос - зачем отдельный чат в cortex визы, тут есть mcp dwh/BI и можно его сделать стартовым для ss. Плюс его в мессенджер высадить.
Каждая 10-я цифра будет фейком, но для self service может и норм.

«Не могли этого не сделать. Must have для BI системы»

Звучит как продуктовые чемоданы без ручек, которые стоит бросить, раз уже делаем next gen.

А вообще крутые эксперименты.
Диалог с чатом в левой части экрана а не в шторке справа — значит все серьезно. AI-first.

Понимаю что пост — душнота страшная, но таков путь. Актуалочка.
VK Видео Visiology Cortex LIVE 3.06 Сortex live 3.06 — большое программное BI-событие Visiology открывает следующий этап BI: куда движется рынок, кто его ведёт и какие решения определят ближайшие годы. Когда: 3 июня 2026, 16:00 МСК Где: МШУ Сколково · «Сингапур» + онлайн-трансляция Переворачиваем…
Post #494 3.43K
Простой тест: спроси коллегу, кто у вас в компании самый сильный BI. Если назвали тебя — пора откликаться на вакансии в Авито.

Если серьёзно — мы ищем несколько сильных BI на senior и middle.

Нам важно:
— Автономность и самоменеджмент. Не разжевываем.
— End-to-end. Берешь проблему бизнеса и деливеришь результат.
— Диапазон. Свободно ходишь от кода и системного анализа к бизнес-логике и визуалу. И обратно.

Что получишь кроме зп: масштаб проектов, сильное BI-комьюнити и стек с AI блекджеком.
Откликаться мне в личку @alexbarakov или на сайте.
Синьорной позиции нет на сайте, но она есть.

Больше про BI в Авито — по тегу #АвитоBI и в наших каналах.
Post #492 4.3K
AI-first data-cтратегии сейчас писать не лучшее время. Никто не понимает ничего кроме вектора.

Для себя сделал компромиссный сценарий для ориентира.
В основе - и наш опыт в Авито и наблюдения/разговоры с мировым техом.
Сценарий на 100% неточен и завтра устареет.
Но мыслей много и надо записать, что есть "на сейчас":

1. Измеримого эффекта сейчас нет никакого. Пока. Большинство жжет токены, получает локальные эффекты, но не масштабирует пилоты. AI добавляют в устоявшиеся процессы. И AI усложняет систему и вносит в процессы хаос. Без новой AI-native инфраструктуры и процессов идет деградация качества, боттлнеки в review, затраты на реворк, блоки с персдатой. Нужен переход к новой модели работы "AI генерирует - человек проверяет", а это очень дорогая и требовательная система.

2. Изменения в BI понятны примерно (см прикидка на картинке)
В пропорции задач будет падать доля разработки BI дашбордов и витрин, доля ad-hoc.
Расти: разработка core моделей данных, semantic layer и governance.
Новый класс задач - создание и поддержка агентных систем.

Экономия будет, но ограниченная и неравномерная и не сразу.
Суммарный extra capacity пусть будет: ~ +0.3– 0.6 FTE на 1 BI разработчика к 28 году. И это скорее бесткейс - частичное ускорение отдельных задач с сильной зависимостью от роста зрелости.

Реально есть ускорение - в создании витрин, пайплайнов, написании кода, создании чекеров и документации, ресерчах.
Причем больше AI ≠ лучше результат. В разработке оптимум ~30–50% AI-кода (не только наше ощущение). Дальше растёт число ошибок. Похоже это не временное ограничение, а некий предел.

Ускорение компенсируется новым оверхедом: human-review, коммуникации с бизнесом, debugging, governance.
С дешами тоже пока рано говорить об ускорении. С BI MCP АI делает норм визы, но для продовых дешей объем реворка сопоставим с ускорением. Вот количество задач упадет - AI based apps заменят те деши, которые делались под разовую аналитическую задачу.

3. Синьоры вайбкодят лучше, получают больше эффекта (не только наш вывод). Новый подход повышает плотность решений и требует высокой итеративности и разборчивости и аутпутам, чтобы получить продовой результат. Мидлы чаще останавливаются и принимают результат ниже качеством, пропускают ошибки. Вайбкодинг нужен таки как отдельных хард (или софт, пофиг).

4. Самый большой эффект — не в ускорении, а в новых до этого не решавшихся задачах: считать 100% вместо 10%, проверять всё, а не выборку, документировать всё, а не частично. То, что раньше не делали из-за ресурса.

5. Главные пререквизиты semantic layer (как слой метрик и разрезов), trusted сore слой витрин под ним (включая логическую и концептуальную модель) и доменная база знаний сверху (фьюшоты). Без них: text-to-SQL угадывает, делает правдоподобные ошибки, генерит rework, теряется построенная годами консистентность метрик и доверие пользователей.

6. Governance остается и становится важнее.
AI ускоряет генерацию и валидацию меты, но не помогает с принятием решений, ответственностью. Human-in-the-loop остаётся. Плюсом AI увеличивает объемы контента, генерит AI slop, что требует большего ресурса на его разбор (сертификацию и архивацию). Добавляется гавернанс контекста и скиллов.

7. Основные "стены" в которые все врезаются: bottleneck в review, рост ошибок при росте доли AI-контента, низкий эффект из за недобора в governance, semantic layer, графах знаний и контекста.

8. «Как в любой масштабной трансформации - будущее наступает неравномерно».
Если в вашей компании нет волны вайбкода вы вероятно не видите, как сильно меняется профессия работы с данными.
Но переживать не имеет смысла, ведь это вне нашего контроля.
Можно включаться активнее, можно пока спокойно заниматься работой над AI ready архитектурой и следить.
Пока рождаются новые процессы и есть пока только иллюзия ценности AI.
Когда начнутся необратимые вещи — все узнаете и успеете.
Post #491 3.77K
Здоровое питание вашего AI (и не AI) аналитика

Прикопаем тут еще одну «скучную» тему, на которую потратил много "мыслетоплива".

Речь про core-слой сертифицированных витрин.


И инженеры и аналитики избегают этой темы. Тут мало низковисящих фруктов, нет готовых подходов, сложно покрыть себя славой.
Но эта вещь решает сутевую проблему - хаоса витрин и низкого переиспользования. Бич мультидоменных платформ с кросс юзаджем.

Поэтому весь прошлый год продавал внутри идею. В итоге скорее продавил, чем продал. В конкуренции с другими инициативами за бюджет - нужен эффект с деньгами.
Цели кор-слоя понятийно правильные — быстрее находить, делать меньше джойнов, ускорять расчеты, сокращать количество объектов, экономить инфру.
Досчитываем метрики уже параллельно с внедрением.

О чем речь.

Кор слой это витрины с заявленным статусом доверия certified.
— удобные для адхоков (широкие) и создания других витрин (3-НФ)
— с покрытием качеством и гарантией (ownership, SLA, DQ-checks, meta)
— c продвижением - reuse вместо «соберу ка еще одну витрину»
Можно воспринимать как основу или как часть семантического слоя (смотря как широко брать).

Ну и из заголовка вы поняли - кор слой - основная часть рациона AI аналитика, вместе с доменным контекстом. Всем нужно думать о здоровом питании.

В Авито проект делается смешанным ресурсом - платформенным DWH и BI в доменах.
Дима Мележиков, лид BI из домена Маркетинга, ворвался в проектную команду, надел шапочку продакта и потащил, под прессингом доменных биай задач. Опасный тип. Читайте его статью на хабре (дайте лайков) про прогресс прошлого года.

С того момента снова перебрали подход и продолжаем экспериментировать. Прикручиваем туда:
— AI generated DQ checks
— AI generated описание витрин
— Автоматический health scoring в каталоге

У Димы будет доклад на Aha-26.
Что сделаем к маю — расскажет. Что не успеем — приукрасит 🙂

Кто решал такую задачу - отзовитесь поболтать.
Вот кстати близкий кейс Airbnb.
Женя Ермаков еще помнится вскользь рассказывал про схожий проект common data marts в яндекс такси. Давно это было.

#АвитоBI
Post #490 3.48K
Не знаю, его ли мы все ждали, но шифт на agentic analytics начался. Как минимум в бигтехе.

Бигтехи техничны, гибки, управляемы и при деньгах. Когда компания дает добро на работу с условным Claude Code — начинается почти биология:
За пару недель появляются MCP ко всем основным сервисам.
Самоорганизуются vibe-coding сессии обмена опытом.
Знания передаются на стихийных 1-1.
Скиллы агентов множатся и шарятся.
Мелькают сообщения, доки, код, деши, витрины, написанные агентами.
Безопасники хлопают глазами и переглядываются.

Но agentic приносит не только wow-эмоции.
Он открывает довольно сложные вопросы.

Опыт Amazon, на который весь бигтех смотрит как на фронтира, дает пищу для размышлений:
- одним из первых озвучили жесткий AI-first на сырых инструментах
- первыми обжигаются с кодгеном роняя прод на ~6 часов
- вводят обязательный review AI кода синьорами

Вектор это, правда, не отменяет.

Какие наблюдения:

- будет резко расти доля запросов агентов к платформе. Агенты джойнят как угорелые и не всегда элегантно. Возможна деградация перфоманса от перегрузки инфры. Придется думать о фильтрации и семплировании агентских запросов, агентских квотах.

- после стратегии «дикого запада» придет подсчет сожженных токенов. Многие сценарии могут просто не окупаться. Для сравнения с трудоемкостью операций «по-старому» пока не хватает данных.

- риски доступа к проду. Агент уже может написать код, сделать push и сам же сделать review. Такие кейсы нужно ловить и блокировать (пока). Сейчас доступ агента = доступ пользователя. Но дальше придется думать о регистрации агентов, связанных с сотрудниками, и выдаче им отдельных доступов. Типа сервисных аккаунтов. Но с характером. Появится новый тип observability — мониторинг действий агентов: какие запросы генерируются, сколько токенов потрачено, какой код, что поменял. Такой observability тоже будет агентским. Хорошо ли это.

- объем кода, дешей и др дата-артефактов вырастет на порядок. Тем кто выплыл из хаоса контента - нужно снова сделать вдох перед погружением.

- и есть парадокс. Все ожидали: AI сократит потребность в инженерах и аналитиках. Пока происходит обратное. Вакансий в мире становится больше. Говорят, жажда легкого и доступного кода привела в инжиниринг компании, которые раньше покупали как SaaS ПО.
- Рост AI замедляется стоимостью compute. Если стоимость AI > стоимость человека - автоматизация перестанет быть выгодной. Естественный экономический лимит. Реальный AI адопшн говорят будет тогда как с интернетом или электричеством - замедленным. Ну успокоили.

В общем, ощущение, что дамбу открыли.
И достаточно квартала, чтобы в погоне за эффективностью
затопить всю долину.
Надо продумывать Governance. Сразу.

Нихрена не понятно, но очень интересно.

(На фото - инженеры до изобретения autocad)
Post #488 4.3K
Прожарка дешей в Авито

Пару лет назад писал что Ценность визуализации данных преувеличена (В основном Tableau, поскольку это их главная фишка). В ней нет ничего критически важного.
Релевантность, своевременность аналитики и доверие к ней в разы важнее. 95% бизнес дашборда - BANs, бар-чарты и удобные таблицы.
Надо просто набить руку делать базовые шаблоны без явных ошибок. Помогает если по-максимуму закрыть в BI туле опции делать откровенное уродство.

Короче ничего с тех пор не изменилось)
Но. Душа просит красоты некоторым из нас все равно хочется делать хороший визуал )

Женя Мичурин и Лера Смирнова рассказывают про наш подход к прожаркам дешей.
Все как у всех - есть комьюнити жюри, методология, подготовка, эфир.
Недавно добавили доработку деша автором с получением бейджа и "зачетом" на след калибровке по матрице компетенций.

Важно - для любого разговора о визуализации бизнес данных в приличном обществе нужно проверять себя на два условия:
1) Упарываться и придираться стоит если (через AND):
- это операционный деш (не аналитический, там скорость важнее)
- у деша широкая аудитория бизнес-юзеров (UX окупается)
- есть основания считать, что деш проживет долго, хотя бы 6 мес (система дешей как продукт)
В остальных дашах - упоротый датавиз не отбивает инвестиций.
2) Есть спорные вопросы (вкусовщина). Есть объективные (все эксперты будут согласны). Грань тонкая, но ее надо чувствовать.

Традиционный вопрос - ну а что там с AI?

Собрал на коленке Dashboard Roasting Bot в нашей корп LLM (с anthropic под капотом). В контексте - мощный прожарочный промпт + наш BI стайл гайд с конфлюенса и записи прожарок. Перед оценкой бот запрашивает цель деша, аудиторию, регулярность использования.

Результат на 8 из 10. Насыпает детально, развернуто, полезно. Цитирует стайлгайд и Lisa Charlotte Muth. Проверяет на цвета, адекватность layout'а. Дает толковые рекомендации. Ставит оценку по шкале. Точно можно его доучить в промпте - не лить воду, держаться строгих проверок.
Закину в комменты пример деша и ответа.

Вроде рабочая штука.
След шаг - встроить прожарку в BI тул при публикации и в скоринг здоровья сертифицированных дешей. Кажется этого еще никто не делал)

Торопитесь прожаривать короче, пока есть что прожаривать.
Деши уйдут (нет), а вместе с ними и приятный треп про визуализацию.

В тему два наших эфира с Ромой Буниным. Больше не будет - поляна сдана ИИ.)

#АвитоBI
Post #487 3.65K
Снова стал ценить опечатки.

Восторги о AI прогрессе имеют обратную сторону. AI slop (мусор из видео, картинок и текстов без смысла) раздражает.
Чем больше AI контента, тем выше ценность настоящего, сделанного человеком. При том, что грань уже много где стала неразличима.
Это не про то, что "все выпрыгиваем из AI-поезда" - уже такая скорость, что лучше смотреть в окно и взять двойной виски.

Видео в этом посте - не AI.
Это группа shortparis и ее солист, чьих новых песен этому миру и мне
будет не хватать.
Older posts →

About this channel

How can I read @datanature without a Telegram account?
TGViewer shows the public web preview Telegram publishes for Data Nature 🕊: recent posts, photos, videos and the subscriber count, with no app, login or account.
How many subscribers does Data Nature 🕊 have?
Data Nature 🕊 (@datanature) has 6.22K subscribers on Telegram, refreshed roughly every 30 minutes.
Does Data Nature 🕊 know I viewed it here?
No. Public channel previews carry no viewer identity, and TGViewer has no accounts or tracking of what you look up.
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →