Насмотренность на гавернанс данных дает мрачный образ будущего для гавернанса контекста.
Сегодня в тех компаниях строятся планы:
Соберем весь контекст, свяжем все знания компании в context/knowledge graph. Сделаем AI понимающим бизнес.
Десять лет назад примерно так же выглядели обещания от Data Governance:
Соберем все метаданные. Построим каталог. Назначим владельцев. Опишем определения. Наступит порядок.
Пока у меня есть только вопросы и гипотезы.
Делюсь чтобы собрать мнений.
1. Больше контекста = выше качество AI?
В кейсе Anthropic агент получил доступ к большому корпусу SQL, дашбордов и аналитических артефактов. Качество почти не выросло.
Во многих ошибочных ответах нужная информация находилась внутри доступного корпуса. Проблема была в выборе правильной сущности.
Ценность создавал не объем контекста, а уменьшение пространства выбора.
Большая часть рынка сегодня инвестирует в: knowledge graph; semantic layer; metadata; context. Anthropic пишет что после определенного уровня зрелости дополнительные знания дают меньший эффект, чем качественные процедуры, зашитые в skills: какие источники когда использовать, в каком порядке, с какими проверками и уточнениями.
2. Можно ли через AI собирать, создавать, валидировать контекст Компании?
DataHub исходит, что значительная часть контекста уже существует, просто разбросана по системам. Тут AI явно может помочь с Context Mining — поиском отсутствующего контекста.
Anthropic говорит, что самого важного слоя - бизнес-контекста - в системах нет: почему метрика считается именно так; почему существует исключение; почему доверяют именно этому источнику; почему было принято именно такое решение.
Такой контекст нужно создавать человеку.
Распределенная ответственность за валидацию контекста выглядит одним из главных рисков. То, из-за чего не взлетает DG — человеческий фактор.
Тут AI уже умеет:
находить противоречия;
находить устаревший контекст;
выявлять пробелы;
сравнивать версии;
запускать проверки, evals.
Возможно, мы движемся от модели: AI → Human → Approved
к модели: AI → AI Review → Human для конфликтов.
Но не факт.
3. Что вообще тащить в Context Layer?
На первый взгляд хочется построить новую систему и собрать туда все.
Сделать еще одну устаревающую копию реальности.
Кажется, Context Layer не должен управлять контекстом.
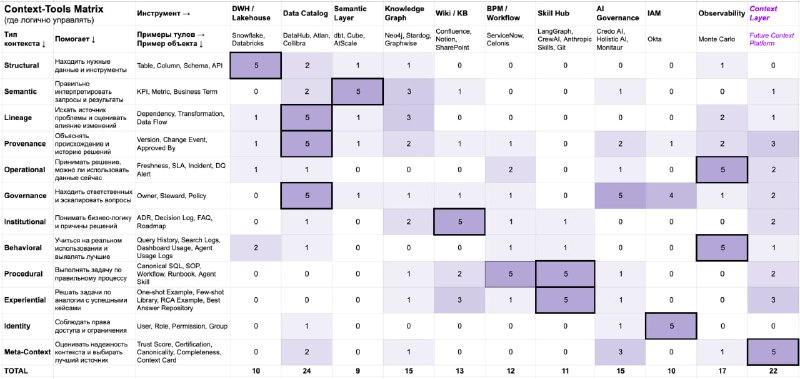
Скорее собирать связи о разном контексте из мастер-систем без дублирования (накидал матрицу на фото)
...и добавлять критичную инфу про:
Trust;
Certification;
Freshness;
Canonicality;
Completeness.
4. Кто такой Context Engineer?
Если контекст становится стратегическим активом, кто-то им должен управлять.
«Context engineering» расщепляется на две роли:
(1) Context Engineer — собирает контекст под конкретного агента: skills, retrieval, tools, evals. Чинит ошибки. Ближе к Analytics Engineer / BI.
(2) Context manager — роль а не позиция. владеет доменным слоем контекста. Эволюция Data Governance / Steward роли.
Откуда только этим людям взять capacity на это? Другие задачи никто не снимал. А эффективность от AI массово не наступила.
Post #496
3.36K