TGViewer
Channel Public Channel
Datalytics

Datalytics

@datalytx

Канал для аналитиков данных про Python, карьерное развитие в анализе данных, всякое разное

Автор – @ax_makarov

Отдельный канал про ChatGPT и его практическое применение —  @ai_forge

Чат канала — @pydata_chat

Вакансии — @data_hr
Subscribers
8.81K
Photos
259
Videos
16
Links
716

Showing posts older than #724 · Back to latest

Older Posts 20 shown
Post #720 3.79K
Немного про аналитику in real life, не применительно к цифрам и фактам, а больше к самому себе как объекту наблюдений, обладающим внутренними свойствами, которые подчас кажутся рациональными, но бывают очень тонки и неоднозначны

Неоднозначны наши внутренние свойства благодаря такому явлению как рефлексия, которое в свою очередь опирается как на объективную действительность, так и на субъективную

Чудо рефлексии состоит в том, что с её помощью мы можем выбирать интерпретацию. К сожалению, в раннем детстве большинство из нас лишены этой привелегии: из-за этого не оставляем внутри себя пространства между стимулом и суждением. Многие из нас не находят этого пространства и во взрослом возрасте. Как итог очень часто наши суждения становятся тем, что мы будто бы выбираем единожды и идём с этим всю свою сознательную жизнь

Воля выбирать интерпретацию исходит из мышления. Мышление, которое дарует нам узкий (и почти сходящийся к нулю) зазор между стимулом и реакцией. Именно этот зазор драматически расширяет пространство неопределённости решений, но вместе с тем дарует свободу

Используйте этот зазор часто, но не слишком, на своё усмотрение
Post #719 3.31K

Forwarded from LEFT JOIN

📈 Grammar of graphics in a nutshell 📖
Вас когда-нибудь интересовало как работают такие фреймворки, как Observable Plot, ggplot2 или Vega-Lite? Автора этой статьи всерьез заинтересовал этот вопрос, поэтому он посмотрел множество реализаций, прочитал кучу статей, и кое-что придумал.
Пересказывать изучение визуализации целиком было бы глупо (важную чсть исследования составляют примеры и код), поэтому мы вкратце пройдемся по самым важным моментам, а полную цепочку преобразований лучше увидеть своими глазами на сайте.

🤔 Что вообще такое грамматика графики (GoG)?
Грамматика графики (GoG) — это язык для определения статистической графики, такой как гистограммы, диаграммы рассеяния и линейные графики из составных частей. Возможно, вы слышали или даже использовали библиотеку, построенную на GoG, такую ​​как Observable Plot, ggplot2, Vega-Lite и Swift Charts.

🔗 Конвейер GoG
Грубо говоря, GoG разделяет визуализацию данных на два отдельных этапа: данные - кодировки + метки -> абстрактное пространство - масштабы-> экранное пространство.

⚪ Все начинается с формы
Прежде чем мы сможем перейти к реальным компонентам GoG, нам нужен способ рендеринга элемнтов на экране. Для этого используется SVG и создается несколько простых основных элементов: прямоугольник и круг. С помощью этих элементов, впоследствии, будет выстроена вся визуализация. Кстати, некоторое время назад я частично рассказывал про d3.js и даже делился примером.

⚖️ Веса и абстрактное пространство
Чтобы сопоставить абстрактное визуальное пространство и пространство пикселей экрана, используются шкалирование.
В чем разница между абстрактным и экранным пространством? Экранное пространство — (во всех смыслах и целях) декартова система координат, а абстрактное пространство не обязательно должно быть таковым. Шкалы используются для построения отображений из абстрактного пространства в пространство экрана, чтобы точно передавать информацию, которая заключается в данных.

⏭ Затем в статье объясняются нюансы меток, кодировок, осей и легенды графика, но тут без визуальных объяснений не обойтись, поэтому переходите на сайт.

🚀 В целом, это, конечно, маленькая и неполная версия грамматики графики. Тем не менее, она позволяет рассмотреть весь путь создания визуализации: от исходных данных до графика на экране.
  • 👍 1
Post #716 4.63K
Интересная статья про разбор преимуществ языка R перед Python для задач анализа данных и data science

Основная мысль статьи, как мне кажется, вертится вокруг того, что R изначально был задуман как язык для различных манипуляций с данными, в итоге в нём предусмотрены необходимые типы данных, векторизация, удобная работа с табличными данными, пайплайны обработки данных и многое другое. В Python это всё тоже есть, но в виде «наворачиваемых» сверху пакетов, таких как numpy и pandas, но им неминуемо приходится адаптироваться к ООП-шной архитектуре Python, от чего возникает ряд решений, которые кто-то может назвать костыльными

Лично для меня Python всё-таки остаётся основным языком в анализе данных, так как уже слишком много времени и ресурсов затрачено на то, чтобы его изучить. Но для кого-то эта статья может быть хорошим набором аргументов для того, чтобы изучить R

https://habr.com/ru/post/670250/
  • 👍 1
Post #710 3.73K

Forwarded from Start Career in DS

#SQL и #Pandas очень похожи. Настолько, что если вы знаете одно, то научиться писать на другом сможете буквально за день 🙂

К слову, если вы работаете бизнес-аналитиком/аналитиком (который использует Excel/SQL), то научиться работать на Pandas - самое первое что вам стоит сделать. Потому что это во-первых будет просто для вас, а во вторых - вы сможете быстро понять, почему крутить данные в питоне сильно быстрее и удобнее.

Классная статья, в которой проводятся аналогии между SQL и Pandas запросами (своего рода словарик):
https://tproger.ru/translations/rewrite-sql-queries-in-pandas/
Post #696 5.98K

Forwarded from Загоны Бирюкова (VIN)

🔥 У нас вышла очередня «безумная😅» статья на vc

Почему нельзя просто так взять и сделать свою аналитику на больших данных

Мало просто начать собирать данные, чтобы делать аналитику. Если вы отслеживаете пользовательские пути и совершаете касания в разных каналах, нужна надежная система сбора и хранения статистики, нужны витрины данных и ресурсы на поддержку и развитие всей инфраструктуры. Не говорю уже о том, что к любой системе аналитики нужно добавить самого аналитика, чтобы появились выводы, гипотезы и решения.
А если вы хотите делать машинное обучение, то еще и команду ML-специалистов, которые будут писать статистические модели для обработки ваших данных.... и это только начало пути
🙂

Читайте, задавайте вопросы — ответим в комментариях к этому посту → https://vc.ru/marketing/408135-pochemu-nelzya-prosto-tak-vzyat-i-sdelat-svoyu-analitiku-na-bolshih-dannyh
vc.ru Почему нельзя просто так взять и сделать свою аналитику на больших данных — Маркетинг на vc.ru Мало просто начать собирать данные, чтобы делать аналитику. Если вы отслеживаете пользовательские пути и совершаете касания в разных каналах, нужна надежная система сбора и хранения статистики, нужны витрины данных и ресурсы на поддержку и развитие всей инфраструктуры.…
Post #695 4.62K
Месяц назад ребята из Delivery Club поделились первой частью эволюции собственной рекомендательной системы ресторанов. Подробнее в публикации на Хабре.

На днях вышло продолжение. Из новой статьи вы узнаете, как отранжировать рестораны персонально для каждого пользователя, зачем нужна офлайновая ML-модель и почему обучение моделей «в лоб» не работает.
Post #691 5.78K

Forwarded from Pavel Dubinin

Полезные ссылки для знакомства и работы с DataLens

Большой функциональный демо дашборд:
- datalens.yandex/demo - публичный, только чтение
- Развернуть дашборд в своем DataLens для редактирования

Сообщество:
- Телеграм чат (вы сейчас тут)
- Предложить и проголосовать за новую фичу
- Плейлист официальных мероприятий на YouTube

Обучение:
- Быстрый старт, пошаговая инструкция
- Более детальные пошаговые инструкции по сценариям
- Туториалы по аналитическим функциям: агрегации, оконные функции, Level-of-Detail выражения
- Создание SQL-чартов (если вам нужно больше гибкости модели данных)
- Образовательные проекты

FAQ в документации:
- https://cloud.yandex.ru/docs/datalens/qa/

Публичные кейсы использования DataLens:
- КазаньЭкспресс - Аналитика retail маркетплейса
- Правительство С.-Петербурга - Аналитика городских сервисов
- Окраина - Аналитика на мясоперерабатывающем заводе
- МВидео - Платформа данных в облаке, геоаналитика
- Rubetek - Аналитика IOT по датчикам домов и квартир застройщика ПИК
- Moneycare - Кредитный брокер, корпоративный BI
- AnywayAnyDay - Аналитика онлайн туристического агентства
- JustSchool - Аналитика над CRM школы английского языка
- SevenTech - Аналитика технологического стартапа над ClickHouse
- НефтеТрансСервис - Промышленная аналитика интернета вещей
- RADAR - Аналитика аудитории наружной рекламы по всей России
- Цифровое образование - Аналитика олимпиад, учеников, школ
- Биологический Факультет МГУ - Предсказание и аналитика урожая
- tproger – Веб аналитика портала
- Car-Taxi - Продуктовая аналитика сервиса эвакуации авто
- Кинопоиск - Публичная статистика оценок фильмов

Примеры публичных дашбордов:
- Анализ качества воздуха
- Статистика коронавируса
- Погода
- Показатели Российских ВУЗов
- Демография Ставрополья
- Исследование про работу вахтовым методом в РФ
- Безработица РФ
- Пример с LOD выражениями от @ab0xa
(присылайте ваши примеры в чат, если хотите поделиться своим опытом!)

Презентации:
- DataLens
- Yandex Cloud Data Platform

Помощь:
- Обсудить ваш проект
- Завести тикет в техподдержку
- Найти партнера для проекта
Telegram Yandex DataLens Сообщество пользователей Yandex DataLens - Правила: t.me/YandexDataLens/28609/28610 - Полезное: t.me/YandexDataLens/28609/28894 Номер заявления РКН: 4962849290
Post #690 3.95K

Forwarded from Ivan Begtin (Ivan Begtin)

Яндекс выложили в открытый доступ систему управления базами данных YDB [1] с полным исходным кодом [2]. Эта распределенная SQL база данных, с собственным расширением языка SQL - YQL [3] и, в целом, выглядит любопытно.

Что стоит внимания:
- работа в кластере как часть системы
- обещанная простая масштабируемость

Что удивительно:
- база написана полностью на C++, хотя сейчас более популярно когда базы данных создаются на более высокоуровневых языках, в том числе и для того чтобы привлечь разработчиков которые хотят их изучать
- поддержка JSON и иерархических данных весьма скромная, по крайней мере документации об этом мало, хотя и упоминается
- вместо придумывания своего языка запросов расширяют SQL, что может быть и не плохо, просто +1 SQL диалект
- нет PostgreSQL или MySQL "совместимости из коробки", а это полезная фича которую декларируют многие новые СУБД и сервисы.

В целом база явно написана под высокие нагрузки, стоит пристального внимания и тестирования.

Ссылки:
[1] https://ydb.tech/
[2] https://github.com/ydb-platform/ydb
[3] https://ydb.tech/ru/docs/yql/reference/

#data #opensource #yandex #tools
Post #685 3.67K

Forwarded from Ivan Begtin (Ivan Begtin)

У Bena Stancil'а очередной замечательный текст про то как устроен рынок стартапов в областях data analytics и не только. В The end of Big Data [1] он пишет о том что Databricks в текущем виде - это раздутый пузырь и что главная ценность продуктов в области больших данных - это снимать головную боль у тех кто ими пользуется. У него в тексте хороший пример про "скучную" презентацию Snowflake которые без какого-либо глянца просто позиционировали свой продут как "Redshift только быстрее и лучше" и "Postgres только быстрее и лучше" и это работало и работает лучше чем лощёные слайды со стоковыми фотографиями.

Ben пишет ещё один важный момент что ключевые рыночные преимущества у онлайн хранилищ в том что они: а) Бесконечны б) Легко масштабируются. Если создаётся продукт не обладающий этими качествами, то на рынке ему уже места не найдётся.

Чтение интересное, всяческие рекомендую.

Ссылки:
[1] https://benn.substack.com/p/the-end-of-big-data

#data #startups #readings
Substack The end of Big Data Databricks, Snowflake, and the end of an overhyped era.
Post #684 4.1K
@ozon_tech ML Meetup.

Кого слушаем:
💬 Ван Хачатрян (Ozon), расскажет, как в Ozon заменили потоп на поток в ETL-pipeline матчинга товаров, а также о прозрачном мониторинге такого подхода в production.
💬 Илья Осиновсков (Ozon), расскажет о рекомендациях на Go и зачем переходить от оффлайн рекомендаций к онлайн.
💬 Макар Краснопёров (Яндекс.Маркет), расскажет о развитии инструментария и платформы от MVP в стартапе до зрелого ML сервиса в большой компании.
💬Андрей Рудницкий и Михаил Бочкарев (AliExpress Россия), расскажут, как в компании перестали бояться иероглифов и полюбили китайскую инфраструктуру.

💬Круглый стол на тему: «Взгляд изнутри: процессы и роли в ML-командах крупных IT-компаний» с представителями Яндекс.Маркет, Aliexpress, Циан. Модерирует Юрий Дорн (Ozon).

🔗Запись
Post #683 3.92K
Хорошая статья за авторством Романа Романчука, руководителя аналитики в Сравни, про то как устроена аналитика в их компании. В своей статье Роман рассказывает о структуре отдела, о пути пользователя и как собираются данные на этом пути, про технологический стек и многое другое

На мой взгляд, самая интересная часть именно про сбор данных, где Роман рассказывает об особенностях сбора данных на различных этапах жизненного цикла пользователя — от привлечения до возврата

https://habr.com/ru/company/sravni/blog/658937/
Post #681 3.44K

Forwarded from настенька и графики

Нравится эта общая, но полезная статья про UX дизайна дашбордов, с идеей того, что пользователи в ваших дашбордах должны видеть то же, что и вы и ничего лишнее их не отвлекало. Когда в дэше много цветов, форм, паттернов и данных, получаются дата-джунгли, в которых очень сложно найти нужную информацию.

Что стоит учитывать:
1. Контекст пользователей. Кто они, их цели, мотивация и потребности, какую информацию они хотят получить и на какие вопросы ответить, их бэкграунд знаний.
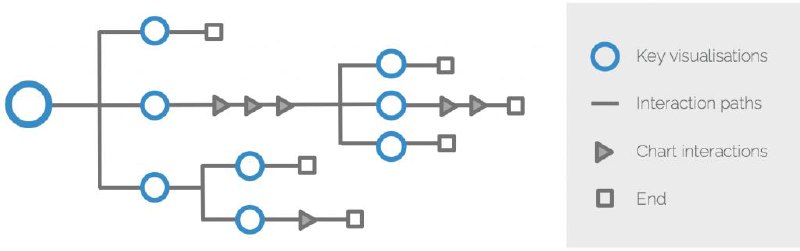
2. Путь пользователя. В дэшах он часто не линейный, часто итеративный: зашел, потыкал, вышел; зашел, потыкал одно, другое, снова первое и вышел и тд. На это приложила картинку, кажется, хорошо помогает понять суть.
3. Каждая ключевая визуализация отвечает на конкретный вопрос. Она включает в себя 3 важных элемента: что конкретно вы измеряете и на какой вопрос она отвечает, какие данные в себя включает, какую часть данных в ней важнее выделить относительно остальных.
Post #680 3.96K

Forwarded from Аналитика данных / Data Study

Гайд_по_профессии_аналитика_данных.pdf27.7 MB
Привет!

Как вы помните, я работаю Senior BI Analyst и знакомлю всех заинтересованных с профессией аналитика, в частности с аналитикой данных и бизнес-аналитикой. Делюсь с подписчиками лучшими практиками работы с данными, полезными ссылками и рассказываю как начать осваивать профессию.

📍Сегодня решил раскрыть чуть больше тему Business Intelligence (BI), как это связано с аналитикой и работой с данными. Смотри обновленный гайд по профессии аналитика:

1. Профессия аналитика данных
2. Задачи аналитика данных
3. Необходимые навыки
4. Business Intelligence и виды аналитики 🔥
5. Уровни аналитиков и компетенции
6. Как составить свое первое резюме
7. Как подготовиться к резюме
8. Вакансии аналитика данных (примеры)
9. Ссылки на полезные ресурсы
Post #669 5.61K
SQLpedia - канал про SQL и базы данных, в котором вы найдете:
— Возможность предложить нам статью для перевода;
— Полезные видео;
— Интересные опросы;
— Профессиональный юмор;

Полезности с канала:
— Шпаргалка по SQL
— Выбор СУБД
— Обзор типов и подходов БД

Присоединяйтесь, давайте расти как профессионалы вместе 😉
Подписаться: @sql_wiki
Post #668 5.24K
А вы знали, что Delivery Club уже не первый год вещают о полезных фичах и опыте разработки в своем блоге на Хабре? Если нет, вот ссылка на него. В нем лиды, разрабы и аналитики сервиса рассказывают про внедрение платформы А/В-тестирования, эволюцию прогноза времени доставки и отрисовку зон доставки.

Вчера ребята рассказали про эволюцию собственной рекомендательной системы ресторанов. Спойлер: она прошла путь от одной модели и бизнес-логики поверх нее до нескольких моделей, максимизирующих разные метрики. В статье вы узнаете, как в Delivery Club решают проблемы холодного старта, exploitation или exploration. Продолжение следует во второй части.

Да будет пир с доставкой на дом!
Post #660 4.26K
Неплохая статья про SQL от devtodev

В ней рассказывается про использование временных таблиц и вложенных запросов.

Кейс из мобильной аналитики:
• как с помощью временных таблиц считать метрики по отдельным приложениям и суммарно по всем;
• как с помощью вложенных запросов вычислить долю пользователей, совершивших максимальное количество платежей.

https://www.devtodev.com/education/articles/ru/432/sql-dlya-nachinayushtih-vlozhennie-zaprosi-i-vremennie-tablitsi
Post #659 3.76K
У фонда «Нужна помощь» есть проект «Если быть точным» — это единая платформа открытых данных, на которой собраны результаты их собственных исследований, статистические данные и рейтинги регионов по социальным проблемам, каталог НКО и регулярный бенчмаркинг по благотворительным сборам. Участники проекта запускают телеграм-канал, в котором будут рассказывать про внутреннюю кухню работы с данными, публиковать результаты исследований, а также статистику и визуальные материалы. Будет полезно студентам, социологам, дата-журналистам, аналитикам и людям, которые интересуются статистикой по социальным темам.

https://t.me/tochno_st
Telegram Если быть точным Собираем данные для решения социальных проблем в России: https://tochno.st/ ▶️ Рассылка: https://t.me/tribute/app?startapp=soRP ▶️ Чат: https://t.me/tochnochat ▶️ Обратная связь: @tochno_bot РКН: https://www.gosuslugi.ru/snet/67ebc282aa1a3b50f0597a6e
Post #658 3.19K
Older posts →
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →