TGViewer
Channel Public Channel
Аналитик данных

Аналитик данных

@dataanlitics

Аналитика данных, Дата Сеанс

@workakkk - по всем вопросам
Subscribers
6.26K
Photos
259
Videos
37
Links
239

Showing posts older than #42 · Back to latest

Older Posts 20 shown
Post #40 2.98K
🎓 ТОП бесплатных курсов по Machine Learning и Data Science

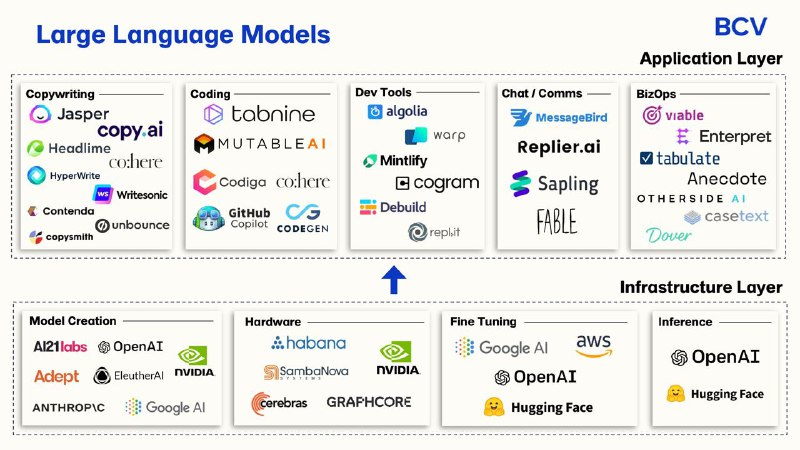
На днях Microsoft выпустила новый бесплатный курс по генеративным моделям для начинающих. Курс рассказывает базовые принципы работы с большими языковыми моделями и ИИ-агентами. Мы решили добавить ещё несколько курсов, которые помогут погрузиться в отрасль.

🔹 Machine Learning for Beginners — A Curriculum
Ещё один курс от Microsoft. Включает 26 уроков и 52 упражнения. Покрывает такие темы, как построение регрессионных моделей, обработка данных, методы кластеризации, введение в обработку естественного языка.
🔹Data Science for Beginners — A Curriculum
Не можем не добавить в подборку дополнительный курс от Microsoft для тех, кто хочет быть дата-сайентистом, а не ML-инженером. Этот курс рассказывает об SQL, библиотеках для анализа и визуализации данных, деплое и эксплуатации моделей.
🔹Открытый курс по машинному обучению
Создан сообществом OpenDataScience. Охватывает основные темы: от анализа датасета до различных ML-алгоритмов.
🔹Курсы на Kaggle
Это, своего рода, классика. Рекомендуем ознакомиться тем, кто ещё этого не сделал.
GitHub GitHub - microsoft/generative-ai-for-beginners: 21 Lessons, Get Started Building with Generative AI 21 Lessons, Get Started Building with Generative AI - microsoft/generative-ai-for-beginners
  • 👍 8
  • ❤ 4
  • 🔥 3
Post #39 2.62K
Post #38 2.51K
🔥 100 упражнений по NumPy с решениями

Делимся с вами полезным GitHub-репозиторием, в котором собраны различные небольшие задачки по библиотеке. Упражнения взяты из NumPy mailing list, Stack Overflow и документации NumPy.

Задачи собраны как в версии с решениями, так и в версии без них. Можете проверить свои знания.

🔗 Ссылка на репозиторий
  • 👍 6
  • 🔥 3
  • ❤ 2
Post #35 2.52K
OpenAI выпустила форум для исследователей ИИ

Здесь будут проводиться различные образовательные вебинары, технические беседы, а также множество возможностей для участников (включая исследователей OpenAI) для общения и генерации новых идей.

Кому удастся себя проявить, будут и предложены и оплачиваемые мероприятия, например: оценки моделей, создание наборов оценок и не только.

https://forum.openai.com/

Аналитика данных
  • 👍 7
  • ❤ 2
Post #34 3.47K
Шпаргалка: нейросети на любой вкус

Последнее время ИИ-инструментов стало появляться так много и так часто, что следить за всеми ними стало очень трудно. Поэтому сохраняйте шпаргалку, где собраны актуальные сервисы на основе нейронок и сгруппированы по категориям: для текста, для аудио-видео, для резюме и т.д.

#шпаргалка #general #ai
  • 👍 9
  • 🔥 2
  • ❤ 1
Post #33 2.31K
🩺 Модели машинного обучения превзошли традиционные методы диагностики одной из форм рака поджелудочной железы

Речь идёт о протоковой аденокарциноме поджелудочной железы (англ. pancreatic ductal adenocarcinoma, PDAC). Разработанная учёными система Prism по диагностике этого заболевания включает в себя две модели:
▪️нейронную сеть PRISM;
▪️логистическую регрессию.

Обе модели используют данные медицинских записей, в том числе демографические данные, диагнозы пациента, данные по лекарствам, которые он принимает, результаты различных анализов, чтобы предсказать риск рака. Нейросеть применяется для обнаружения сложных закономерностей в таких данных, как возраст, история болезни и результаты лабораторных исследований. Логистическая регрессия используется для простого анализа, выдаёт вероятность развития PDAC по этим признакам.

Стандартные методы диагностики способны обнаружить около 10% случаев PDAC, а обе модели Prism, используемые совместно, — 35%.

📖 Исследовательская статья
  • 🔥 11
  • 👍 3
  • ❤ 1
  • 🥰 1
  • 👏 1
Post #32 3.26K
📊 Разные типы графиков и код для их отрисовки из Matplotlib, Seaborn и Plotly

1️⃣ Линейный график
Самый простой тип графика, последовательность точек данных на линии.

🔵 Matplotlib:
import matplotlib.pyplot as plt
x = [1, 2, 3, 4]
y = [10, 20, 25, 30]
plt.plot(x, y)
plt.show()


🟡 Seaborn:
import seaborn as sns
import pandas as pd
data = pd.DataFrame({'X': [1, 2, 3, 4], 'Y': [10, 20, 25, 30]})
sns.lineplot(x='X', y='Y', data=data)
plt.show()


🟣 Plotly:
import plotly.express as px
fig = px.line(data, x='X', y='Y')
fig.show()


2️⃣ Диаграмма рассеяния (Scatter plot)
Изображает значения двух переменных в виде точек на декартовой плоскости.

🔵 Matplotlib:
import numpy as np
x = np.random.rand(50)
y = np.random.rand(50)
plt.scatter(x, y)
plt.show()


🟡 Seaborn:
sns.scatterplot(x=x, y=y)
plt.show()


🟣 Plotly:
fig = px.scatter(x=x, y=y)
fig.show()


3️⃣ Гистограмма
Показывает частоту появления различных значений случайных величин в выборке.

🔵 Matplotlib:
data = np.random.randn(1000)
plt.hist(data, bins=30)
plt.show()


🟡 Seaborn:
sns.histplot(data, bins=30)
plt.show()


🟣 Plotly:

fig = px.histogram(data, nbins=30)
fig.show()


4️⃣ Ящик с усами (Box plot)
Диаграмма размаха, показывает медиану (или, если нужно, среднее), нижний и верхний квартили, минимальное и максимальное значение выборки и выбросы.

🔵 Matplotlib:
data = np.random.normal(0, 1, 100)
plt.boxplot(data)
plt.show()


🟡 Seaborn:
sns.boxplot(data)
plt.show()


🟣 Plotly:
fig = px.box(y=data)
fig.show()
  • 👍 17
  • ❤ 3
  • 🔥 1
Post #31 3.18K
Post #29 2.63K
Manual Rollback Action — безопасный откат коммитов

Manual Rollback Action предлагает простой и надежный способ отката последнего коммита в вашем репозитории на GitHub, создавая при этом резервную копию текущего состояния ветки master для возможного восстановления

Это может быть весьма полезным, когда последний коммит вызвал проблемы в продакшн-среде, и требуется немедленное восстановление предыдущего состояния

Стоимость: #бесплатно

#GitHub #git
  • 👍 4
Post #28 2.59K
✅ A/B тестирование: как сделать правильный выбор?

А/В-тестирование – это метод, который используется для сравнения двух версий переменной, например, дизайна сайта при маркетинговом исследовании с целью выявления лучшей версии. Это критически важный метод исследования в Data Science, который часто используется различными организациями при принятии решений с целью оптимизации существующего продукта и максимизации прибыли.

Представлю, что компания, продающая мебель, хочет увеличить число кликов по баннеру «Мебель на заказ». Они значительно изменили дизайн сайта для этой цели. К сожалению, не существует способов предсказать, как именно изменится поведение людей на обновленном сайте по сравнению со старой версией. А/В-тестирование может помочь, например, измерить разницу в конверсии между двумя версиями сайта и сказать, является ли эта разница статистически значимой.

Нулевая гипотеза в рамках А/В-тестирования –
предположение о том, что разницы между версиями сайта А и В в действительности нет, а все наблюдаемые различия обусловлены случайностью. Моя задача в ходе А/В-тестирования – опровергнуть нулевую гипотезу. Альтернативная гипотеза в рамках А/В-тестирования утверждает, что версии сайта А и В различны с точки зрения поведения пользователей.

Уровень значимости – это порог вероятности для определения того, являются ли результаты эксперимента статистически значимыми. Чаще всего уровень значимости устанавливается равным 0,05. Это значит, что моё утверждение о значимости результата будет справедливо на 95%. Чем ниже выбранный уровень значимости, тем ниже риск того, что будет обнаружена разница, вызванная случайностью.

P—value – это вероятность наблюдения данного результата при условии, что нулевая гипотеза верна. Если p-value меньше, чем уровень значимости (α), то отвергается нулевая гипотеза в пользу альтернативной (то есть результаты являются статистически значимыми). Например, при уровне значимости 0,05 p-value должна быть меньше 0,05 для признания результатов эксперимента статистически значимыми.

Доверительный интервал – интервал значений, в котором, с вероятностью (1- α), лежит истинное значение переменной. Доверительный интервал является оценкой возможных значений переменной в зависимости от её стандартного отклонения.

Статистическая мощность – вероятность отклонения нулевой гипотезы в случае, если альтернативная гипотеза верна. Обычно статистическая мощность теста устанавливается равной 0,8. Это значение используется для вычисления размера выборки, необходимой для подтверждения гипотезы с необходимой силой эффекта.

Организация эксперимента
Для проведения А/В-теста требуется разделить всех пользователей на две группы: одна группа будет видеть старый дизайн сайта, а другая – новый. Пользователи распределяются между группами случайным образом. Как правило, группу, которой показывают новый дизайн сайта (В), называют тестовой, а группу, которой показывают старый дизайн (А) – контрольной.

Целевая метрика – CTR, то есть количество кликов на баннер, делённое на количество показов. Буду сравнивать среднее значение метрики CTR для контрольной и тестовой групп. Предположу, что в контрольной группе среднее значение метрики составляет 12%, а в тестовой – 14%.

Если среднее значение метрики в тестовой группе выше, чем в контрольной, то означает ли это, что дизайн сайта В лучше дизайна сайта А? Ответ: нет. Необходимо показать, что результаты А/В-теста статистически значимы. Это означает, что различие в версиях наблюдается не случайно и не обусловлено какой-либо ошибкой. Проверить это можно с помощью статистических тестов.

Не буду заниматься сбором данных в рамках данной публикации. Буду анализировать данные, взятые из датасета с Kaggle. Скачать его можно здесь.

📌 Читать дальше
  • 👍 8
  • ❤ 1
Post #27 1.82K
​10 лет исследований НЛП, объяснённых в 50 концепциях

Это видео — настоящая сокровищница знаний для всех, кто интересуется нейронными сетями и обработкой естественного языка.

В доступной форме рассказываются ключевые концепции NLP: от базовых идей типа токенизации и векторных представлений слов до революционных архитектур вроде RNN, Seq2Seq, Transformer и таких моделей, как BERT, GPT, XLNet.

Помимо этого, вы узнаете о проблемах, с которыми сталкивался автор и как современные модели их преодолевают.

#видео #nlp
YouTube 10 years of NLP history explained in 50 concepts | From Word2Vec, RNNs to GPT From RNNs to Transformers to GPT-4, the leap in intelligence in Deep Learning research for Language Modelling and NLP has been a steady and educational growth. In this video, I explain 50 concepts that cover the basics of NLP like Tokenization and Word Embeddings…
  • 👍 3
  • ❤ 2
Post #26 1.93K
⏩ Повысьте уровень своих навыков в области ИИ: Список бесплатных курсов Google Top 8.

1. Introduction to Generative AI - введение в генеративный ИИ Этот курс погрузит вас в основаы генеративного ИИ,

2. Introduction to Large Language Models
- в курсе вы узнаете о больших языковых моделях (LLM), которые представляют собой разновидность искусственного интеллекта, способного генерировать текст, переводить языки, писать различные виды креативного контента и информативно отвечать на ваши вопросы.

3. Introduction to Responsible AI - этот курс расскажет вам об этичном и ответственном использовании искусственного интеллекта. Вы узнаете о различных этических проблемах ИИ, таких как предвзятость, конфиденциальность и безопасность. Вы также узнаете о некоторых лучших практиках разработки ИИ.

4. Introduction to Image Generation - этот курс расскажет вам о генерации изображений, разновидности искусственного интеллекта, способного создавать изображения на основе текстовых описаний. Вы узнаете о различных типах алгоритмов генерации изображений, о том, как они работают, и о некоторых из их наиболее распространенных применений.

5. Encoder-Decoder Architecture -
этот курс расскажет вам об архитектуре модели кодера-декодера, которые представляют собой тип архитектуры нейронной сети, широко используемой для задач обработки естественного языка, таких как машинный перевод и резюмирование текста. Вы узнаете о различных компонентах архитектур энкодер-декодер, о том, как они работают, и о некоторых наиболее распространенных областях их применения.

6. Attention Mechanism - В этом курсе вы узнаете о механизме attention - технике, которая используется для повышения производительности нейронных сетей в задачах обработки естественного языка.

7. Transformer Models and BERT Model - В этом курсе вы изучите архитектуру трансформеров, которые представляют собой тип архитектуры нейронной сети, показавшей свою эффективность при решении задач обработки естественного языка.

8. Create Image Captioning Models
- Этот курс научит вас создавать модели автоматического описания изображений, которые представляют собой разновидность искусственного интеллекта, способного генерировать подписи к изображениям.

Data
  • 👍 4
Post #24 2.4K
⏩ Курс "Машинное обучение" на ФКН ВШЭ

Конспекты лекций, материалы семинаров и домашние задания (теоретические, практические, соревнования) по курсу "Машинное обучение", проводимому на бакалаврской программе "Прикладная математика и информатика" Факультета компьютерных наук Высшей школы экономики.

Записи лекций и семинаров

▪Полный плейлист
▪Вводная лекция
▪Линейная регрессия
▪Линейная регрессия и градиентное обучение
▪Продвинутые градиентные методы, линейная классификация
▪Метрики качества классификации (+небольшое продолжение)
▪Логистическая регрессия (+продолжение)
▪Метод опорных векторов, многоклассовая классификация
▪Решающие деревья
▪Решающие деревья (продолжение), разложение ошибки на смещение и разброс
▪Случайные леса, градиентный бустинг
▪Градиентный бустинг (продолжение)
▪Стекинг. Обучение без учителя и кластеризация.
▪Визуализация, обучение представлений
▪Рекомендательные системы

🖥 Github

Data
  • 👍 13
  • ❤ 3
  • 🤡 1
Post #23 1.91K
👨‍🔬Этические проблемы в науке о данных

Это был никто иной, как Призрак Интернета Будущего (и да, он существует). Он предупреждал о колоссальных этических проблемах, с которыми в настоящее время пытается разобраться стремительно развивающийся мир науки о данных. Подобно Человеку-пауку, но только вместо паутины с данными на кончиках пальцев, мы наделены огромной силой и, как следствие, огромной ответственностью.

Наука о данных, появившаяся всего 20 лет назад, сегодня является секретным ингредиентом многих успешных организаций.
Она произвела переворот в промышленности, активизировала научно-технический прогресс и даже помогла решить ряд самых актуальных мировых проблем. Но у этих значительных успехов есть оборотная сторона, о которой редко кто говорит: этические дилеммы. Речь идет не о заурядных дилеммах типа “съесть или не съесть третий кусок пиццы”. Имеются в виду глубокие, сложные вопросы, которые влекут за собой обширные последствия для общества, сферы личной жизни и равноправия.

Рассмотрим 3 этические проблемы в науке о данных, которые могли выпасть из фокуса вашего внимания.

📌 Читать

Data
  • 👍 6
  • ❤ 2
  • 🔥 1
Post #22 1.75K
🔥 3 инструмента для отслеживания и визуализации выполнения кода на Python

Инструменты для отслеживания кода нужны, когда вы хотите разобраться в том, как именно работает ваш код и где именно затаились баги. В этой статье представлены три инструмента, которые решают эти задачи:

📌  Читать

Data
  • 👍 3
  • ❤ 2
  • 🔥 1
Post #20 1.71K
➡️ Методы ускорения кода: Векторизация

Это один из методов, который необходимо знать при работе с pandas, а его игнорирование обычно приводит к проваленным собеседованиям и медленному коду.

Задача: необходимо применить некоторую функцию к каждой записи. Очевидный способ, который делают новички — цикл по строкам или конкретному столбцу. Однако это антипатерн в pandas, работающий неприлично медленно на больших датафреймах. Разберем другие способы с примерами.

Например, итерация по строкам с помощью метода .iterrows(). Это самый медленный способ, к тому же не сохраняет типы данных. Другие варианты — использовать .itertuples(), где на каждой итерации строка рассматривается как именованный tupple. Это во много раз быстрее, чем .iterrows(). Еще один аналог — .iteritems().

Любые итерации все равно на порядки медленнее векторизованного подхода, поэтому использовать их стоит только в редких случаях, например когда результат зависит от предыдущих строк.

Другой метод — использование функции .apply(). Она принимает на вход функцию и доп. параметры, и затем применяет ее к каждой строке. Это более предпочтительный способ, работающий в разы быстрее. Также, apply лаконичнее и удобнее, особенно если применять lambda-функции.

Однако, современные процессоры научились оптимизировать подобные задачи с помощью SIMD-инструкций, в которых операции производятся над вектором, а не одним значением (как это происходит когда мы итерируемся по строкам). Чтобы использовать эти инструкции, нужно явно вызвать их в пакете.

Поэтому pandas содержит собственные реализации простых операций (сумма, min/max и тд), выполняющиеся гораздо быстрее итерирования. Такие функции называют векторизированными. Прежде чем использовать apply или iter…, стоит поискать в документации соответствующие векторные функции.

Для строк и дат есть свои методы, например df['col'].str.contains('pat') и df['col'].dt.days.

Ниже сравнение времени работы методов выше для операции добавления столбца-логарифма. Результаты ошеломляющие, векторизация быстрее циклов и iterrows в тысячу раз! Похожее сравнение можно прочитать тут.

import numpy as np
import pandas as pd
import math

df = pd.DataFrame(data={'values':range(1,100_000)})

temp=[]

# -------------------------------------------------
# 1.15 секунды
for idx in range(0, df.shape[0], 1):
temp.append(math.log(df['values'].iloc[idx]))

# 7.18 секунд
for i,row in df.iterrows():
temp.append(math.log(row['values']))

# 156 миллисекунд
for row in df.itertuples():
temp.append(math.log(row.values))

# 84.6 миллисекунды
temp = df['values'].apply(lambda x: math.log(x))

# 3.38 миллисекунды
temp = np.log(df['values'])
# -------------------------------------------------

df['new_values'] = temp


Data
  • 👍 3
  • ❤ 1
Post #19 1.06K
💫 SQLite для работы с данными

Рассказываю, почему SQLite отлично подойдет вам в повседневной работе. И неважно, разработчик вы, аналитик, тестировщик, админ или продакт-менеджер.

Для затравки несколько известных фактов:

▪SQLite — самая распространенная СУБД в мире, включена во все популярные ОС.
▪Работает без сервера.
▪Для разработчиков — встраивается прямо в приложение.
▪Для всех остальных — удобная консоль (REPL) одним файлом (sqlite3.exe на Windows, sqlite3 в Linux / macOS).

📌 Читать

Data
  • 👍 2
Older posts →
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →