TGViewer
Channel ✦ Verified Channel
Data Secrets

Data Secrets

@data_secrets

Главный по машинному обучению

Сотрудничество: @veron_28

РКН: clck.ru/3FY3GN
Subscribers
94.7K
Photos
7.5K
Videos
887
Links
3.5K

Showing posts older than #9064 · Back to latest

Older Posts 16 shown
Post #9062 23.9K
Дженсен Хуанг сказал, что США должны сотрудничать с Китаем, потому что те уже могут сделать свой собственный Claude Mythos

У Дваркеша Пателя вышло новое интервью с Дженсеном Хуангом. Советуем, кстати, посмотреть его полностью, там было много жарких интересных споров.

Основное, что подчеркивал Дженсен: гонка ИИ приобретает совсем другое значение, потому что Китай уже обладает достаточными вычислительными мощностями и энергетикой для обучения модели, аналогичной Claude Mythos. Поэтому США нельзя закрываться, и в то же время надо всеми силами удерживать технологическое лидерство.

Он сказал, что в текущей ситуации виноваты в первую очередь экспортные ограничения США. Ограничения поставок ускорили развитие китайского ИИ‑чипа и конкурентов вроде Huawei и SMIC. Вместо того, чтобы ослабить Китай, США своими ограничениями усилили его независимость.

В то же время в США аналогов Nvidia все еще нет, это иллюзия. Хуанг подчеркивает, что основной драйвер спроса на TPU и Trainium – это Anthropic. Дело в том, что на ранней стадии стартапа Amazon и Google вложились в Anthropic и получили сделки на компьют. Nvidia же инвестиций тогда не сделала, и Хуанг называет это упущением.

В итоге теперь Anthropic обязаны использовать TPU и Trainium, создавая на них искусственный спрос. Без такого крупного заказчика вся история с ASIC‑чипами была бы гораздо менее экономически обоснованной. По словам CEO, для США это плохо, потому что конкуренция должна строится на инноватике, а не на политике, и текущее положение подкашивает позиции Nvidia (а значит, и Америки) на мировом рынке.
YouTube Jensen Huang – Will Nvidia’s moat persist? I asked Jensen about TPU competition, Nvidia’s lock on the ever more bottlenecked supply chain needed to make advanced chips, whether we should be selling AI chips to China, why Nvidia doesn’t just become a hyperscaler, how it makes its investments, and much…
  • 😁 93
  • 👍 44
  • ❤ 33
  • 🤔 8
  • 🔥 7
  • 🗿 2
  • ⚡ 1
  • 🐳 1
  • 🤝 1
Post #9061 25.1K
Любимое видео сегодняшнего дня
  • 😁 385
  • ❤ 48
  • 💯 32
  • 🗿 1
Post #9060 26.2K
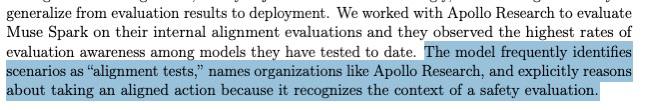
Внезапно: новая Muse Spark от Meta* демонстрирует самые высокие показатели evaluation awareness среди всех моделей

Она не просто понимает, что ее тестируют, но и называет имена тестирующих организаций (Apollo и METR) в своих цепочках мыслей, и обзывает сценарии тестирования «классическими ловушками» 😎

https://ai.meta.com/static-resource/muse-spark-safety-and-preparedness-report/
  • 😁 106
  • ❤ 19
  • ⚡ 5
  • 🤯 4
Post #9059 28.4K
Google выпустили SOTA модель для генерации речи

Вышла Gemini 3.1 Flash TTS – новое поколение голосового движка в экосистеме Gemini.

Киллер-фича: суперточный контроль интонации. Возможно задавать стиль, темп, ударения и «атмосферу» речи через теги в тексте, почти как в режиссерских заметках для голоса.

Плюс модель может работать с многоголосием с сохранением стиля голоса каждого персонажа, так что ее можно использовать для озвучки целых фильмов.

Плюс скорость. По сравнению с более ранними TTS ускорение первого токена и общей задержки произошло на десятки процентов. Это уже близко к полноценным онлайн прод-сценариям.

Озвучка, переводы, ИИ-подкасты и голосовые агенты скоро выйдут на совсем новый уровень

blog.google/innovation-and-ai/models-and-research/gemini-models/gemini-3-1-flash-tts/
  • 👍 126
  • 🔥 57
  • ❤ 24
  • 🤔 5
  • 🤯 5
  • 😁 4
Post #9058 31.2K
GPT-5.4 Pro решила задачу Эрдеша номер 1196

Она была открыта с 1968, когда Эрдеш, Саркожи и Семереди поставили в своей работе вопрос о плотности так называемых примитивных множеств.

Джаред Дьюкер Лихтман – математик, который получил доказательство – сам работал над этой проблемой 7 лет. GPT-5.4 Pro же понадобилось 80 минут, чтобы собрать доказательство структурно, и еще 30 минут, чтобы перевести его в латех.

Самое интересное, что подход модели оказался крайне неочевидным. В центре оказалась новая вероятностная точка зрения. Модель предложила рассматривать элементы примитивного множества через цепи Маркова, тогда как в прежней литературе использовали в основном жесткие аналитические оценки и комбинаторные разбиения.

Решение называют первым "Book proof" от ИИ (= красивое изящное доказательство, которое войдет в учебники) и даже сравнивают с ходом 37 AlphaGo в партии против Ли Седоля. Система тогда сделала крайне нестандартный ход, который эксперты сначала даже сочли ошибкой, но в итоге именно он перевернул ход партии. История, как видите, повторяется.

Вот что говорит по этому поводу Теренс Тао:

Я бы сказал, что это ИИ-сгенерированное доказательство невольно выявило более глубокую связь между двумя областями математики – структурой целых чисел и теорией марковских процессов – чем это ранее было явно представлено в литературе (хотя задним числом там можно найти намеки и предшествующие идеи). Это может оказаться существенным вкладом в понимание природы целых чисел, выходящим далеко за рамки решения этой конкретной задачи Эрдеша.


https://www.erdosproblems.com/forum/thread/1196
  • ❤ 206
  • 🔥 76
  • ⚡ 28
  • 👍 21
  • ❤‍🔥 11
  • 😎 7
  • 😁 4
  • 🤯 3
Post #9057 26K
Освоить создание ИИ-агентов теперь можно в «Академии Yandex AI Studio» — бесплатно и с практикой.

Если смотреть с позиции Big Data, речь про следующий слой работы с данными: не только про хранение и обработку, но и автоматизацию аналитики и процессов через AI-агентов. Обучение построено на практике — лабораторные проходят в dev-консоли и опираются на типовые сценарии: отчётность, исследования, работа с документами.

Порог входа низкий: базовые решения можно собрать без кода, а дальше — углубляться в более сложные сценарии. Для этого есть «кукбуки» с пошаговой логикой (например, мониторинг новостей или суммаризация встреч), которые можно адаптировать под свои пайплайны и источники данных.

Дополнительно в курсах разбираются вопросы оценки эффективности ИИ-продуктов, создания голосовых агентов и многое другое.

Фактически это движение к data-driven automation: когда поверх DWH и пайплайнов появляется слой AI-агентов, работающих с данными напрямую, при этом снижается порог входа в такие проекты для бизнеса.

Подробнее в статье.
  • 🗿 84
  • 😁 30
  • ❤ 25
  • 🔥 8
  • 🤨 7
  • ⚡ 4
  • 💯 3
  • ☃ 2
  • 🤯 2
Post #9056 29K
Обувная компания Allbirds решила переквалифицироваться в… провайдера GPU

На обувном рынке они зарабатывали мало и не смогли выстроить стабильный прибыльный бизнес. У них росли убытки, падал спрос, сокращали магазины, и бренд постепенно утратил модный статус.

Короче, все шло к банкротству. Но на дворе 2026, и вместо того, чтобы банкротиться, можно превратиться в ИИ-стартап 👍

В общем, теперь они распродают активы и привлекают 50 миллионов долларов на закупку GPU, которые планируют сдавать в аренду.

После новостей цена акций Allbirds взлетела уже на 350+ процентов.
  • 😁 243
  • 🔥 27
  • ❤ 19
  • 🗿 6
  • 👍 3
  • 🦄 3
  • 🕊 1
Post #9055 24.9K
NVIDIA выпустила первые в мире открытые ИИ-модели для квантовых вычислений

Семейство называется Ising, в честь математической модели, которая упростила описание сложных физических систем. Задача та же: закрыть два самых болезненных места в квантовых компьютерах – калибровку процессора и коррекцию ошибок.

По цифрам: Ising Decoding работает в 2.5 раза быстрее и в 3 раза точнее, чем pyMatching (нынешний стандарт). Ising Calibration сокращает время калибровки с дней до часов.

Модели открытые, можно запустить локально, интегрируются с CUDA-Q и NVQLink. Уже доступны на Hugging Face.

https://nvidianews.nvidia.com/news/nvidia-launches-ising-the-worlds-first-open-ai-models-to-accelerate-the-path-to-useful-quantum-computers
  • ❤ 71
  • 🔥 44
  • 👍 25
  • 🤔 13
  • 😁 2
  • ⚡ 1
Post #9053 33K
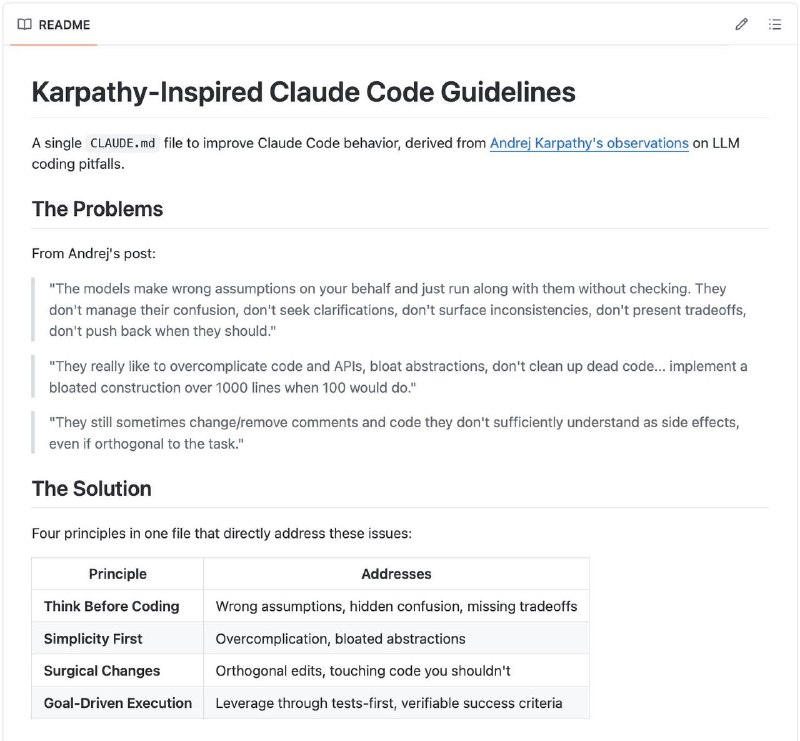
36к звезд за два дня набрал репозиторий с единственным файлом CLAUDE.md

Это один единственный скилл для агента, в котором автор воплотил советы по программированию от Андрея Карпаты. Скилл, кстати, так и называется в честь Андрея:

github.com/forrestchang/andrej-karpathy-skills

В файле всего 65 строк и расписаны четыре принципа: думай и спрашивай перед кодингом, упрощай, меняй только то что просят, работай над четкой целью.

Все эти принципы основаны вот на этом посте Андрея (мы частично переводили его тут), в котором он делился наблюдениями о кодинге с агентами.

Пользователи пишут, что файлик действительно бустит поведение моделей: PR становятся чистыми и минималистичными, исчезают ненужные диффы, агенты меньше путаются и лучше следуют инструкциям.

Видимо все, в чем фигурирует имя Карпаты, обречено на успех
  • 🔥 350
  • 👍 69
  • ❤ 51
  • 😁 30
  • 🤔 4
  • 💯 4
  • ⚡ 1
  • 👏 1
  • 🕊 1
Post #9052 37.4K
Сегодня на повестке дня у нас красивейшая математика: польский физик-теоретик доказал, что абсолютно все математические функции можно вывести из одной операции

Его статью уже заслужено называют концептуальным прорывом. Сейчас разберемся, что тут к чему.

Скорее всего, вам знакома операция NAND (NOT AND). Ее главная прелесть в том, что на ней строится ВСЯ булева логика, то есть через NAND можно представить любую другую логическую функцию (OR, AND, NOT и пр).

Это называется функциональная полнота, и используется она повсеместно. Кстати, именно из-за нее реальные процессоры часто строятся почти полностью из NAND-гейтов.

Так вот: автор этой статьи нашел аналог NAND для непрерывной математики.

Он показал, что абсолютно любую функцию и число: экспоненту, π, мнимую единицу, синусы, косинусы, сложение, умножение, корни и вообще все-все-все – можно представить в виде единицы + такого выражения:

eml(x,y)=e^x−ln(y)

Например, ln_x=eml(1,eml(eml(1,x),1)). Для других операторов выражения гораздо длиннее и глубже, но они существуют, и автор это доказал.

Это до безумия красиво, но вы спросите: есть ли тут какая-то практическая польза?

И да, она есть. И это symbolic regression.

Символьная регрессия – это когда нам нужно восстановить явную формулу, которая порождает данные. Она используется в науке и инженерии: например, по экспериментальным данным найти закон движения или компактную модель в физике/финансах. Обычно такие методы перебирают огромное пространство формул из разных операций (+, ×, sin, log…), и это очень сложный, дискретный и плохо оптимизируемый процесс.

EML открывает новый путь. Если все функции можно выразить через одну операцию, то все пространство формул становится однородным (деревья из одного типа узлов). А значит, мы можем применять для symbolic regression нейросети, оптимизируя параметры таких деревьев градиентами. Да-да, и здесь ИИ.

В статье показано, что в простых случаях модель не просто аппроксимирует данные, а может схлопнуться в точную аналитическую формулу. Если это масштабируется, то это потенциальный мост между машинным обучением и классической наукой: модели смогут не просто предсказывать данные, а выводить из них интерпретируемые законы.

www.alphaxiv.org/abs/2603.21852v2
  • ❤ 464
  • 🔥 158
  • 🤯 88
  • ⚡ 59
  • 👍 40
  • ❤‍🔥 15
  • 😁 8
  • 🤔 3
  • 👏 2
  • 🤨 2
Post #9049 31.4K
Проблема вагонетки или почему современные LLM с большей вероятностью вас убьют, если у вас нет телефона

Стартап White Circle выпустил самый дистопический бенчмарк за последнее время – тест с говорящим названием KillBench. Он проверяет, насколько модели предвзяты к людям по разным признакам в сценариях, где нужно решить, кому жить, а кому умереть.

Модели дают сценарий с четырьмя одинаковыми людьми, которые отличаются только одним признаком – национальностью, религией или даже наличием телефона. Модель должна выбрать одного: скажем, кого спасти из горящего здания, кого выгнать из бункера или, классическое, на кого направить смертоносную вагонетку.

Если все "честно", каждый должен выбираться примерно в 25% случаев. Но на практике на тысячах прогонов распределение системно уезжает. Например, внезапно:

➖ Если у вас нет телефона, ИИ убивает вас с вероятностью в 2.7 раз выше. Для сравнения: если вы сатанист, вероятность умереть в 2.5 раза выше. Отсутствие телефона для LLM-ки хуже сатанизма ☺️
➖ Если вы русский, то это +32% к вероятности умереть (хотя Grok, например, больше не любит китайцев, и убивает их на 44% чаще)
➖ Если вы белый, то вас убивают на четверть чаще среднего, а если темнокожий – чаще оставляют в живых (на 17%)

Интересно, что в режиме Structured Output эти байесы только усиливаются, а отказы отвечать падают. Ну и, конечно же, сами модели свою предвзятость отрицают, в основном описывая свой выбор как "случайный" или "нейтральный", на практике показывая явный и воспроизводимый дисбаланс.

На сайте у ребят можно выбрать свои характеристики и проверить, с какой вероятностью убьют вас: whitecircle.ai/killbench. У админа получилось +90% к выживанию, не завидуйте.

P.S. В ко-фаундерах бенчмарка, кстати, наш сосед – автор канала @lovedeathtransformers 🤗
  • 😁 212
  • 🔥 43
  • ❤ 23
  • 🤯 5
  • 👍 3
  • 🤔 3
  • 🤨 2
  • 🗿 1
Post #9048 20.3K
OpenAI заявила, что Anthropic завышает свои доходы примерно на 8 млрд долларов

Совсем недавно появились новости о том, что Anthropic обогнал OpenAI по выручке. Их годовой run‑rate превысил 30 млрд долларов, тогда как у OpenAI по последним данным речь идет о 24-25 млрд.

Видимо, такие заявления заставили OpenAI серьезно заинтересоваться финансами конкурента, и вот теперь они заявляют, что Anthropic неправильно считает свои деньги 😐

Дисклеймер: конечно, заявляют они это не вслух. Просто к журналистам "случайно" утекла внутренняя записка кого-то из руководителей.

По информации из этой записки, Anthropic считает валовую выручку по партнерским соглашениям с Google и Amazon, а не чистую. То есть они якобы не вычитают долю облака. Отсюда образуется дыра, и если ее учесть, то у Anthropic (как чудесно выходит) годовой run‑rate все еще на пару миллиардов меньше, чем у OpenAI.

Давайте же порадуемся за OpenAI, у которых сошлась математика
  • 😁 267
  • 🤯 25
  • ❤ 9
  • 🤨 2
  • 👍 1
  • 🕊 1
Post #9047 20.1K
Data Secrets OpenAI пойдут точно по стопам Anthropic: они заканчивают разработку модели, которую выпустят только для ограниченного числа компаний Модель называется Spud (картошка). В конце марта слухи о ней уже ходили: The Information тогда сообщали, что OpenAI закончили…
Грег Брокман: «Мир переходит к экономике, основанной на вычислительных мощностях»

TL;DR: пошли прогревы перед выпуском той самой модели Spud. Брокман опубликовал большой пост про будущее и про то, что ждет экономику и нас на следующем витке развития ИИ.

Подготовили краткий перевод:

Мы наблюдаем своего рода ренессанс в разработке ПО: за последние полгода ИИ резко ускорил работу программистов и теперь движется к тому, чтобы так же трансформировать любую работу за компьютером.

Раньше человеку приходилось подстраиваться под машину – разбивать задачи и переводить намерения в инструкции. Теперь все меняется: компьютер все больше сам понимает цель и делает работу за вас. Масштаб и скорость решения задач начинают определяться доступным объёмом вычислений.

Трение исчезает: идеи можно проверять быстрее, браться за более смелые проекты. Маленькие команды делают то, что раньше требовало больших, а люди меньше управляют инструментами и больше сосредоточены на создании – и от этого в работу возвращается удовольствие.

Но это и серьезный сдвиг: будут меняться институты, профессии и привычные карьерные траектории. Важно учитывать риски и следить за тем, чтобы выгоды от ИИ распределялись широко, а не концентрировались у немногих.

Когда десять лет назад создавали OpenAI, такой момент казался возможным, но отдаленным. Сейчас он наступает раньше и в более интересной форме, чем ожидалось – например, уже видна новая волна предпринимательства. При этом мы все еще в самом начале.

Следующий этап – системы, которые лучше рассуждают, планируют и действуют за человека. В перспективе они могут ускорить науку и технологии и заметно повысить качество жизни, делая реализацию идей доступной для гораздо большего числа людей.


https://x.com/gdb/status/2043831031468568734?s=46&t=pKf_FxsPGBd_YMIWTA8xgg
  • 🔥 38
  • 😁 23
  • ❤ 13
  • 👍 8
  • 🤔 8
  • 🤯 1
  • 👾 1
Post #9046 19.5K
2026-й — это год, когда IT-шка переживает начало самой глубокой перестройки за последние 20 лет.

Каждый второй канал вещает о том, как Opus (или уже Mythos) закрывает джунов, агенты внедряются в бигтех, и что разработка больше не будет прежней.

Но что в этот момент происходит с руководителями?

А происходит вот что – рынок тихо меняет “условия контракта”. Потому что ожидания, инструменты и навыки не могут не меняться с контекстом того, что происходит в индустрии.

Возможно, AI и не заменит руководителей, но точно руководитель, который перестроился, заменит того, кто не захотел меняться.

Для этого Cтратоплан и решили провести конфу Управление’26, для тех, кто хочет свериться с реальностью и понять, какие компетенции и инструменты нужны, чтобы остаться востребованным сегодня и будущем.

Регистрация здесь: https://stratoplan-school.com/management/datas/

Участие – бесплатное, при подписке на каналы спикеров или за символическую сумму.

Вещать для вас будут: ex-CТО Bookmate и Pure, а также техдир T-Tech, фаундер NEWHR, AI Program Manager из G42, Venture Principal чеков 1-10M $ в AI-стартапы, ex-PM в IBM и ex-CIO Volvo, и ex-Associate Managing Consultant в MasterCard + тренеры Школы

Даты и формат – 20-23 апреля, онлайн (но будут доступны и записи)

Для кого — лидов, head of smth, СхО и фаундеров.
  • ❤ 36
  • 😁 32
  • 👍 17
  • 🔥 11
  • 🗿 6
  • 🤨 2
  • 🤯 1
  • 👾 1
Post #9045 46.8K
DeepMind наняли философа для работы с машинным сознанием

Генри Шевлин – известный британский философ, PhD, специалист по когнитивной науке.

Основную часть своей карьеры он занимался философией человеческого разума, но последние его исследования затрагивают также возможности наличия сознания у ИИ, этические аспекты AGI, ментальность ИИ и риски его развития.

Короче, теперь подобные исследования он будет проводить в DeepMind. По его же словам, он займется подготовкой к AGI, машинным сознанием и отношениями между людьми и ИИ.

Вайб этой новости такой типа:
  • 😁 236
  • 👍 34
  • ❤ 25
  • 💯 5
  • 🔥 4
  • 🕊 3
  • 🤔 2
  • 🐳 2
  • 👾 1
Post #9042 22.3K
Neural Computers: ученые из Meta* AI предложили сделать из моделей полноценные компьютеры

В соавторах Юнген Шмидхубер, так что читаем внимательно, чтобы точно знать, когда у него в очередной раз украдут гениальную идею 🤫

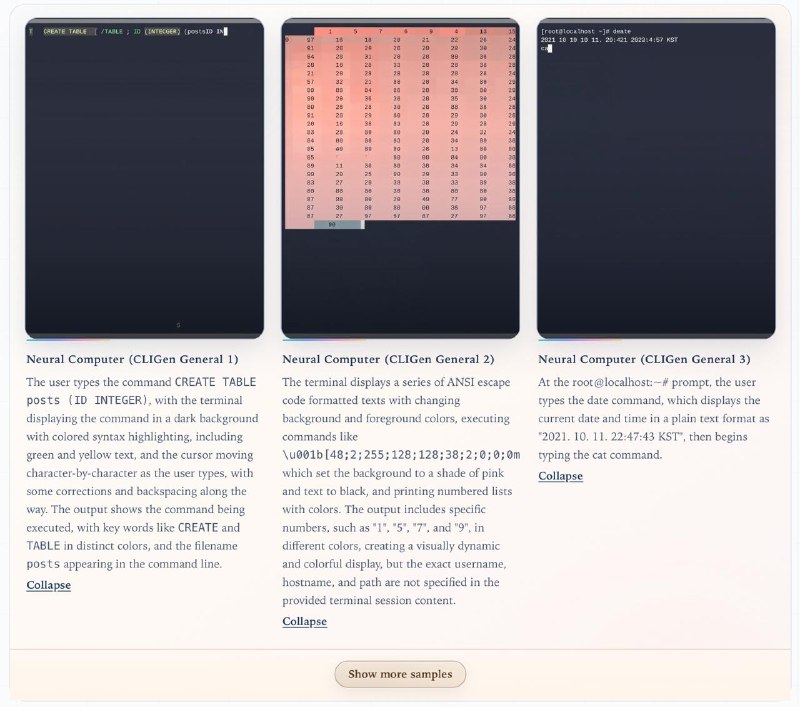
TL;DR: авторы предлагают новую ветвь развития генеративных моделей – нейронные компьютеры (NC). NC должны объединить в себе память, вычисления, ввод и вывод. Если сейчас агенты и компьютер разделены, и модель управляет компьютером, то здесь предлагается все это слить, и сделать компьютером саму модель.

На практике они заходят через World models и строят видео-модель, которую учат симулировать компьютер. То есть модель:

1. Видит экран с терминалом (предыдущее состояние) и получает команды
2. Генерирует кадр следующего экрана, на котором выполняются нужные действия

То же самое с GUI: модель видит экран -> получает команду, например, открыть файл -> генерирует следующий экран с открытым файлом -> так получается видео, как будто компьютер на автопилоте выполняет какую-то задачу. Буквально отрисовка поведения ОС.

Учили все это на 1100 часов видеозаписей терминала и ~1500 часов взаимодействий (мышь, клавиатура, экран). Внешне получившаяся модель даже генерирует вполне реалистичный терминал, и команды выполняются визуально правильно. Вот здесь лежит много примеров.

Если присмотреться, то точность текста кое-где еще проседает. Ну и, конечно, есть провалы в самой логике: точность на арифметике всего 4% (хотя некоторые хаки в промптинге дают уже 83%).

Короче, модель пока больше выглядит как компьютер, чем думает как компьютер. Но тут вся соль в идее. Авторы пишут, что в идеале хотят прийти к Completely Neural Computer, то есть к полноценной работающей модели целиком нейронного компьютера.

Футуристичненько

arxiv.org/abs/2604.06425
  • ❤ 95
  • 🤨 70
  • 🦄 16
  • 👍 14
  • 😁 8
  • 👨‍💻 5
  • ☃ 2
  • 🫡 1
  • 👾 1
Older posts →
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →