
DeepSeek снова в игре 🔥
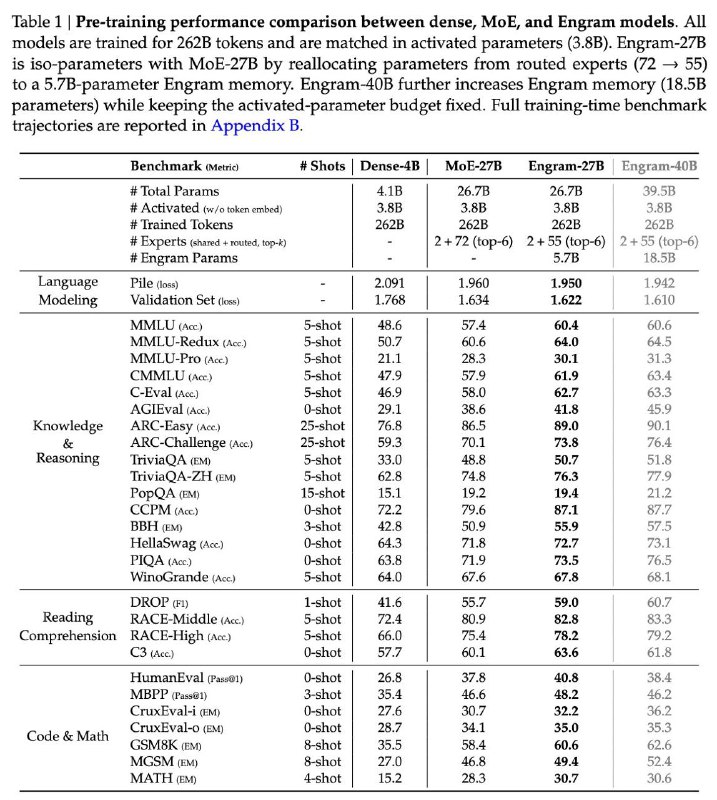
"Conditional Memory via Scalable Lookup: A New Axis of Sparsity for Large Language Models"
Идея мощная: DeepSeek предлагают Engram - модуль памяти, который добавляет к LLM *lookup-память* с доступом за O(1).
Что это значит по-человечески:
вместо того чтобы каждый раз “вспоминать” шаблоны через слои трансформера, модель может моментально доставать нужные куски знаний из отдельной памяти.
Engram - это:
- хешированная N-gram память (modernized hashed N-gram embeddings)
- которая работает как быстрый словарь: *пришёл паттерн → достали представление → усилили модель*
Анализ показывает интересное:
🧠 Engram снижает необходимость ранним слоям заново реконструировать “статичные паттерны”
(частые формы, устойчивые токены, регулярные последовательности)
➡️ То есть ранние слои (слои трансформера, которые стоят ближе всего ко входу.) меньше заняты “механической работой”и больше ресурсов остаётся на главное.
В результате модель становится как будто глубже там, где надо:
- reasoning
- планирование
- длинные цепочки мыслей
Фактически это новый тип sparsity:
не только MoE/спарсные слои,
а спарсная память с быстрым доступом.
Это уже похоже на шаг к LLM, где часть знаний живёт как “кэш-память”, а не внутри весов.
Paper: https://github.com/deepseek-ai/Engram/blob/main/Engram_paper.pdf
Видео: https://www.youtube.com/watch?v=Hoz9HxHy_nQ
Post #987
3.91K

- 👍 13
- ❤ 4
- 🔥 2