


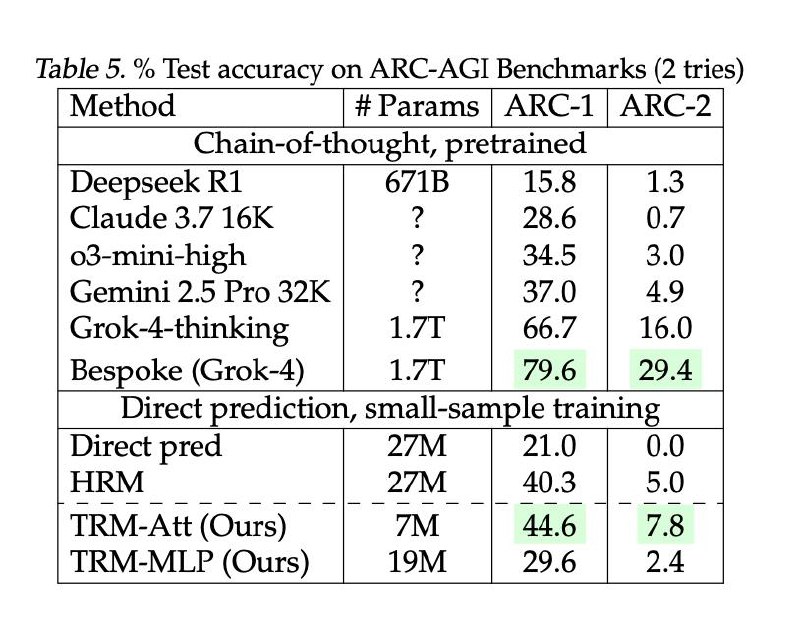
Крошечная модель на 7 миллионов параметров превзошла DeepSeek-R1, Gemini 2.5 Pro и o3-mini на ARG-AGI 1 и ARC-AGI 2
Сегодня разбираем самую громкую статью последних дней: "Less is More: Recursive Reasoning with Tiny Networks" от Samsung. В работе, кстати, всего один автор (большая редкость, особенно для корпоративных исследований).
Итак, главный вопрос: как это вообще возможно, чтобы модель в 10 000 раз меньше была настолько умнее?
Ответ: рекурсия. Модель (Tiny Recursive Model, TRM) многократко думает над своим ответом, пересматривает его и исправляет, прежде чем выдать окончательное решение. Выглядит процесс примерно так:
1. Модель получает условия задачки и сразу генерирует какой-то грубый набросок решения. Он не обязательно должен быть правильным, это просто быстрая догадка.
2. Дальше система создает "мысленный блокнот" – scratchpad. Туда она записывает всё, что думает о задаче и своём черновике: где ошибки, что можно улучшить, как проверить гипотезу. При этом важно понимать, что scratchpad – это не поток токенов, как в обычном ризонинге. Это внутреннее скрытое состояние, то есть матрица или вектор, который постепенно обновляется. Другими словами, TRM умеет думает молча.
3. Модель в несколько проходов обновляет это внутреннее состояние, каждый раз сверяясь с (а) задачей и (б) исходным наброском. Она как бы думает: согласуется ли текущий черновик с условием, где противоречия, что улучшить. После N-ого количества итераций модель переписывает исходный черновик, опираясь на свой сформированный scratchpad. Но это не все. Этот процесс (сначала подумай → потом исправь) повторяется несколько раз. И вот только после этого мы получаем финальный ответ.
Результаты, конечно, поражают. Метрики на ARC-AGI-1 / ARC-AGI-2 – 44.6% / 7.8%. Для сравнения, у o3-mini-high – 34.5% / 3.0%. Также модель отлично решает судоку и лабиринты.
Единственная честная оговорка: это не языковая модель, она предназначена только для алгоритмов и текстом отвечать не умеет. Тем не менее, идея блестящая. Много раз пройтись одной и той же крохотной сеткой по scratchpad – это буквально как эмулировать глубину большой модели без большой модели. Отличный пример алгоритмического преимущества.
Крайне советуем почитать статью полностью тут. К слову, они там много ссылаются на августовскую работу про Hierarchical Reasoning Model (HRM). Если захотите освежить память по этому исследованию, то вот тут – наш разбор.
Post #872
361