TGViewer
Channel Public Channel
Tensorflow(@CVision)

Tensorflow(@CVision)

@cvision

اخبار حوزه یادگیری عمیق و هوش مصنوعی
مقالات و یافته های جدید یادگیری عمیق
بینایی ماشین و پردازش تصویر

TensorFlow, Keras, Deep Learning, Computer Vision

سایت:
http://class.vision

👨‍💻👩‍💻پشتیبان دوره ها:
@classvision_support

لینک گروه:
@tf2keras
Subscribers
15.1K
Photos
1.3K
Videos
318
Links
2.6K

Showing posts older than #4350 · Back to latest

Older Posts 20 shown
Post #4348 4.93K

Forwarded from آموزش LLM و VLM

آموزش LLM و VLM پارت ۱ تو دوره‌ی LLM مکتب‌خونه با مفهوم knowledge distillation آشنا شدیم؛ ایده‌ی ساده و آشنا: یه مدل معلمِ بزرگ و گرون، یه مدل دانش‌آموزِ کوچیک‌تر رو آموزش می‌ده تا رفتارش رو تقلید کنه. اما واقعیت اینه که این روش خیلی متنوع‌تره. تو پست زیر نشون می‌ده مدل‌های…
پارت ۲

2️⃣ ادغام چند متخصص RL در یک مدل (on-policy distillation):
به‌جای اینکه یک مدل رو با RL روی همه‌چی خوب کنیم (که باعث فراموشی مهارت‌های قبلی می‌شه)، برای هر حوزه (ریاضی، کد، ایجنت) یه معلمِ متخصص جدا با RL می‌سازن، بعد همه رو تو یه دانش‌آموز واحد distill می‌کنن؛ در حالی که خودِ دانش‌آموز داره rollout تولید می‌کنه. جالبه که این معلم‌ها لزوماً بزرگ‌تر نیستن، فقط تخصصی‌ترن. این الگو رو DeepSeek-V4، MiMo (با نام MOPD)، GLM-5 و Nemotron 3 Ultra استفاده کردن.

3️⃣ خود مدل، معلم خودش (self-distillation):
مثل Cursor Composer 2.5 که یه hint به context اضافه می‌کنه، نسخه‌ی hint‌دار مدل می‌شه معلم نسخه‌ی بدون‌hint. یا روش Thinking Machines که برای جلوگیری از فراموشی، از چک‌پوینتِ قبل از fine-tune به‌عنوان معلم استفاده می‌کنن.


نکته‌ی مشترک همه‌شون: معلم لزوماً بزرگ‌تر نیست، فقط تو یه context یا حوزه بهتره. گاهی اون معلم، خودِ مدله.

🔗 منبع: huggingface.co/blog/sergiopaniego/distillation-2026
  • 👍 11
  • ❤ 2
Post #4347 3.91K

Forwarded from آموزش LLM و VLM

پارت ۱

تو دوره‌ی LLM مکتب‌خونه با مفهوم knowledge distillation آشنا شدیم؛ ایده‌ی ساده و آشنا: یه مدل معلمِ بزرگ و گرون، یه مدل دانش‌آموزِ کوچیک‌تر رو آموزش می‌ده تا رفتارش رو تقلید کنه.
اما واقعیت اینه که این روش خیلی متنوع‌تره. تو پست زیر نشون می‌ده مدل‌های فرانتیر ۲۰۲۶ دقیقاً از چه نسخه‌هایی از distillation استفاده می‌کنن:

1️⃣ معلم بزرگ و دانش‌آموز کوچیک (روش کلاسیک):
مثل Gemma 3 و DeepSeek-R1-Distill که یا روی logit‌های معلم match می‌کنن (soft label) یا مستقیم روی متن تولیدشده‌ی معلم fine-tune می‌شن.
  • 👍 5
  • ❤ 2
Post #4346 4.35K
شرکت NVIDIA یه مجموعه داده بزرگ رایگان برای آموزش هوش مصنوعی منتشر کرده

برای اینکه یه هوش مصنوعی بتونه کارهای واقعی انجام بده (کد بزنه، خطا پیدا کنه، از ابزار استفاده کنه)، باید با هزاران نمونه‌ی واقعی از این کارها آموزش ببینه. ولی این نمونه‌ها کمیاب هستن و شرکت‌ها معمولاً منتشر نمی‌کنند.

مثلا یه ربات که فقط با متن انگلیسی آموزش دیده، وقتی بخواد توهین رو توی زبون کره‌ای یا ژاپنی تشخیص بده، شکست می‌خوره، چرا که توی این زبون‌ها پرخاشگری معمولاً توی «لحن مؤدبانه‌ی ظاهری» پنهان می‌شه، نه توی کلمات رکیک! فلذا بدیهیست که داده‌ی انگلیسی به تنهایی کافی نیست.

حالا انویدیا دو تا چیز رو رایگان منتشر کرده:

📍 اولا Prompt Atlas — یه نقشه‌ی بصری با میلیون‌ها نمونه پرامپت واقعی (کدنویسی، ریاضی، ایمنی و...) که می‌تونی توش بگردی:
https://huggingface.co/spaces/nvidia/nemotron-post-training-v3-prompt-atlas

👥 ثانیا Nemotron-Personas — بیش از ۲ میلیارد «آدم مصنوعی» از ۱۰ کشور مختلف، برای تست اینکه هوش مصنوعی واقعاً فرهنگ و زبون مردمِ مناطق مختلف رو می‌فهمه یا نه.

🔗 مقاله:
https://huggingface.co/blog/nvidia/open-data-for-agents

#NVIDIA #هوش_مصنوعی #Nemotron
  • ❤ 16
  • 👍 3
Post #4345 3.23K

Forwarded from آموزش LLM و VLM

مدل SenseNova-Vision-7B-MoT از تیم SenseNova

برخلاف VLMهای معمول (مثل Qwen-VL) که فقط تصویر می‌گیرن و متن تولید می‌کنن، این مدل هم متن تولید می‌کنه هم تصویر — یعنی می‌تونه خروجی‌هایی مثل نقشه عمق، ماسک سگمنتیشن یا نقشه نقاط سه‌بعدی رو مستقیماً و بدون هد اختصاصی برای هر تسک بسازه


- تشخیص اشیا، لوکالیزیشن، OCR، گراندینگ رابط کاربری، کی‌پوینت

- تخمین عمق و نرمال سطح

- سگمنتیشن (رفرنسی، استدلالی، تعاملی، GCG)

- بازسازی هندسه چندنمایی و تخمین پوز دوربین


📊 عملکرد:

در مقایسه با Qwen3-VL-8B-Instruct، در اکثر تسک‌های تشخیص و لوکالیزیشن جلوتره؛ مثلاً OCR (ICDAR15): ۴۹.۵ در برابر ۲۵.۴، و RefCOCOg: ~80 در برابر ~72.

البته در مقابل، توی درک عمومی تصویر (MMMU) با نمره ۰.۴۲ از Bagel (۰.۵۵) عقب‌تره — یعنی این مدل تخصصیِ کارهای ساختاریافته بینایی‌ست، نه مکالمه و استدلال عمومی.


🔗 مدل در هاگینگ فیس
🔗 گیت‌هاب
📄 مقاله

___
@llm_huggingface
@cvision
  • ❤ 13
  • 🔥 2
  • 👍 1
Post #4343 3.89K
چند هفته پیش ضبط دوره‌ی Agentic AI تموم شد 🎬

طبق چیزی که دوستان مکتب‌خونه گفتن، این دوره ۸ فصلی قراره هفته آینده روی سایت مکتب‌خونه منتشر بشه
  • ❤ 56
  • ❤‍🔥 7
  • ⚡ 3
  • 👌 2
  • 💯 2
Post #4342 4.48K

Forwarded from آموزش LLM و VLM

مدل LocateAnything از NVIDIA؛ حذف یکی از بزرگ‌ترین گلوگاه‌های مدل‌های Vision-Language

مدل جدید LocateAnything انویدیا مشکل کندی مدل‌های تشخیص اشیاء رو با یه ایده ساده و هوشمندانه حل کرده:
Parallel Box Decoding (PBD).

مسئله چی بود؟ مدل‌های VLM معمولاً مختصات هر باکس (x1,y1,x2,y2) رو توکن به توکن و به‌صورت متوالی تولید می‌کنن. وقتی صحنه پر از اشیاء باشه (مثلاً ۱۰۰ آبجکت)، این یعنی هزاران توکن قبل از رسیدن به جواب نهایی! هم کند، هم چون مختصات یک باکس مستقل از هم پیش‌بینی می‌شن، کاهش دقت هندسی.

راه‌حل PBD: کل باکس به‌عنوان یک واحد اتمیک (block) با طول ثابت در یک گام موازی پیش‌بینی می‌شه، نه توکن به توکن. این کار هم‌زمانی همون‌قدر که سرعت رو بالا می‌بره، دقت رو هم بهتر می‌کنه چون چهار مختصه با آگاهی از هم پیش‌بینی می‌شن (نه کور و مستقل).

📄 مقاله:
https://research.nvidia.com/labs/lpr/locate-anything/LocateAnything.pdf

🌐 پروژه:
https://research.nvidia.com/labs/lpr/locate-anything/

💻 دمو :
https://huggingface.co/spaces/nvidia/LocateAnything

🤗مدل:
https://huggingface.co/spaces/nvidia/LocateAnything
  • ❤ 13
  • 🔥 4
  • ❤‍🔥 2
  • 😱 1
Post #4341 4.7K
یه بنده خدایی یه پرامپت را آزمایش کرده و اعلام کرده که Fable 5 تو رقابت جدیدمون کامل بقیه رو داغون کرد، ولی ۶ برابر گرون‌تر از Opus 4.8 تموم شد!

به ۴ مدل یه پرامپت یکسان داده: ساخت سه تا صحنه مستقل با HTML5 canvas و فیزیک واقعی

پرامپت‌ها:
خارج شدن قطار از ریل روی یه پل شکسته و سقوط تو آب
پرش دو ماشین از سکو و برخورد تو هوا روی یه دره
له کردن یه ردیف ماشین پارک‌شده توسط مونستر تراک

خروجی‌ها:

Fable 5: ۶۲,۱۵۸ توکن، $۳.۱۲
GPT 5.5: ۳۷,۷۵۳ توکن، $۱.۱۴
Opus 4.8: ۲۲,۲۸۰ توکن، $۰.۵۶
GLM 5.2: ۳۶,۲۴۶ توکن، $۰.۰۸

مدل Fable 5 هر سه صحنه رو با نمره A+ رد کرد. برخوردها واقعی به‌نظر می‌رسیدن، اشیاء درست می‌افتادن و می‌شکستن، و هیچ‌چیز از داخل زمین رد نمی‌شد یا معلق نمی‌موند.

مدل GPT 5.5 نزدیک‌ترین رقیب به Fable بود. تو صحنه‌ی Bigfoot حتی به‌نظرمون یه‌کم از Fable بهتر بود.
مدل GLM 5.2 تو هیچ صحنه‌ای برنده نشد، ولی به‌مراتب ارزون‌ترین بود.
منبع: https://twitter.com/atomic_chat_hq/status/2072446067962978411
  • 🔥 14
  • ❤ 4
  • 👍 4
Post #4340 3.93K
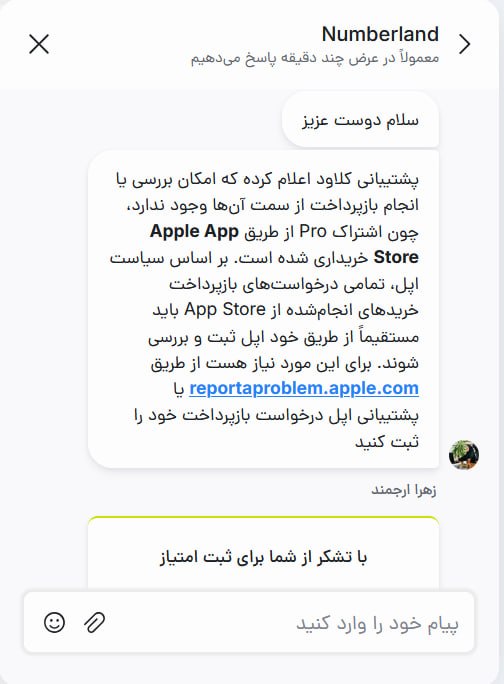
پشتیبانی نامبرلند واقعاً در حد فاجعه‌ست! تلفنی که عمراً جواب بدن!
بعد ماجرای بن شدن اکانت اول به خود Claude ایمیل زدم، گفتن چون خرید از طریق اکانت اپل انجام شده، اونا نمی‌تونن پیگیری کنن و باید از طرف همون اکانت اپل (که نامبرلند باهاش خرید کرده) اقدام بشه.
بعد این موضوع رو به نامبرلند گفتم که خب شما با اکانت اپلتون خرید کردید، پس خودتون باید پیگیری کنید. جواب کاملاً بی‌ربطی دادن و انگار نه انگار!

خب من که اصلاً دسترسی‌ای به اکانتی که خودشون باهاش پرداخت کردن ندارم! این چه جور پشتیبانی‌ایه🤦‍♂️

#نامبرلند #پشتیبانی_ضعیف
  • 👍 31
  • 😱 9
  • 👌 2
  • ❤ 1
Post #4339 3.91K
یادگیری ماشین؛ نسل جدید پیش‌بینی منحنی بازده و مدیریت مدت‌زمان

در بازارهایی مثل ایران که نرخ‌های بهره به محدوده‌های بالایی رسیده‌اند، مدیریت مدت‌زمان و پیش‌بینی ساختار زمانی نرخ‌ها تبدیل به یکی از چالش‌های اصلی فعالان حوزهٔ #ریسک، ALM و مدیریت پرتفوی شده است. در چنین محیطی، رفتار منحنی بازده به‌شدت #غیر_خطی و حساس است و مدل‌های سنتی همیشه پاسخ‌گو نیستند.
به‌عنوان کسی که سال‌ها روی ساخت مدل‌های داده‌محور و ابزارهای ML برای تحلیل بازارها کار کرده‌ام، همیشه برایم مهم بوده که ببینم ترکیب مدل‌های کلاسیک با معماری‌های مدرن یادگیری ماشین تا چه حد می‌تواند در محیط‌های با نرخ بهره بالا ارزش ایجاد کند.
اخیراً مقاله‌ای با عنوان: Data-Driven Duration Management: Term Structure Forecasting Using Machine Learning از Tobias Lausser، Joao Eduardo Vuolo و Rudi Zagst منتشر شده که دقیقاً همین موضوع را بررسی می‌کند.
دو نکتهٔ کلیدی مقاله که برای بازار ایران اهمیت ویژه دارد:
برای بازار آمریکا: بهترین مدل، یک شبکهٔ عصبی direct forecasting است که
فاکتورهای DNS را برای کاهش ابعاد داده‌های نرخ صفر استفاده می‌کند، و
یک Autoencoder را برای استخراج ویژگی‌های کلان اقتصادی به‌کار می‌گیرد. این ترکیب باعث می‌شود مدل هم ساختار منحنی را بهتر بفهمد و هم اثرات تورم، سیاست پولی و سیکل‌های اقتصادی را به‌صورت فشرده و بدون نویز وارد پیش‌بینی کند.
چرا این موضوع برای ایران مهم است؟
در محیط‌هایی با نرخ بهره بسیار بالا:
رفتار منحنی بازده به‌شدت تحت تأثیر متغیرهای کلان است.
نویز داده‌ها زیاد است و کاهش ابعاد (DNS یا PCA) ضروری می‌شود.
استفاده از #Autoencoder برای استخراج ویژگی‌های کلان می‌تواند کمک کند اثرات تورم، سیاست‌های بانک مرکزی، نقدینگی و شوک‌های اقتصادی به‌شکل فشرده و قابل‌استفاده وارد مدل شوند.
به‌نظر من، این نوع رویکرد ترکیبی می‌تواند پایهٔ نسل جدید ابزارهای مدیریت ریسک و ساخت پرتفوی در بازارهای با نرخ بهره بالا باشد؛ مخصوصاً در ایران که دینامیک‌های کلان نقش بسیار پررنگی در شکل‌گیری منحنی بازده دارند. https://www.linkedin.com/feed/update/urn:li:activity:7478336398442430464/
LinkedIn #ریسک #غیر_خطی #autoencoder #یادگیری_ماشین #مدیریت_ریسک #فینتک #شبکه_عصبی #pca #nelsonsiegel #machinelearning #fixedincome #yieldcurve… یادگیری ماشین؛ نسل جدید پیش‌بینی منحنی بازده و مدیریت مدت‌زمان در بازارهایی مثل ایران که نرخ‌های بهره به محدوده‌های بالایی رسیده‌اند، مدیریت مدت‌زمان و پیش‌بینی ساختار زمانی نرخ‌ها تبدیل به یکی از چالش‌های اصلی فعالان حوزهٔ #ریسک، ALM و مدیریت پرتفوی شده…
  • ❤ 7
Post #4338 2.96K
Post #4337 3.8K
:
🚀 تشخیص و سگمنتیشن اشیاء Open-Set — بدون نیاز به آموزش مجدد!
مدل‌های سریع و دقیقی مثل YOLO معمولاً محدود به یک سری دسته‌بندی از پیش تعریف‌شده هستن. تکنیک‌های Open-Set این محدودیت رو برمی‌دارن، اما معمولاً سرعت رو فدا می‌کنن.
حالا با ترکیب سه رویکرد در یک سیستم یکپارچه و کارآمد، قابلیت «هر چیزی رو ببین» (See Anything) به‌صورت real-time ممکن شده:
🔹 پرامپت متنی
🔹 پرامپت تصویری
🔹 تشخیص بدون پرامپت (Prompt-free)

✨ پرامپت تصویری (Visual Prompting)
فقط با یک نمونه تصویری ساده، مدل می‌تونه بلافاصله اشیاء مشابه رو تشخیص بده — بدون نیاز به آموزش مجدد و بدون نیاز به پرامپت متنی. این روش با افزودن اطلاعات به embedding های تصویری با پیچیدگی کم، امکان تطبیق سریع و آنی با اشیاء ناشناخته رو در محیط‌های صنعتی و پویا فراهم می‌کنه.
🟠 کاربردها:
✅ خطوط تولید صنعتی — تطبیق آنی با محصولات جدید در حال حرکت
✅ نظارت تصویری — تشخیص پویای تهدیدات
✅ خرده‌فروشی — صندوق هوشمند برای هر نوع محصولی
✅ سلامت — کمک به تشخیص ناهنجاری‌ها در لحظه

https://docs.ultralytics.com/models/yoloe
https://yolovx.com/
  • ❤ 10
Post #4336 3.32K
Tensorflow(@CVision) یه مدل بنیادی (foundation model) جدید منتشر شده توسط گوگل برای داده های ساختار یافته، هم برای رگرسیون هم طبقه بندی قابل استفادست TabFM: Tabular Foundation Models https://github.com/google-research/tabfm
مدل بنیادی TabFM چطور کار می‌کنه؟
نکته جالب TabFM اینه که مسئله پیش‌بینی روی داده‌های جدولی رو به یه مسئله In-Context Learning (ICL) تبدیل کرده - دقیقاً همون منطقی که مدل‌های زبانی مثل GPT ازش استفاده می‌کنن.

تفاوت با روش سنتی: به جای اینکه برای هر دیتاست جدید یه مدل جدید train کنید (مثل XGBoost که باید hyperparameter tuning و feature engineering انجام بدید)، کل دیتاست (هم داده‌های train و هم ردیف‌های test) رو به‌عنوان یه prompt واحد به مدل می‌دید و مدل توی یک forward pass پیش‌بینی می‌کنه. یعنی صفر تا صد zero-shot - بدون training، بدون tuning.

نحوه‌ی آموزش: چون دیتاست‌های جدولی باکیفیت و متنوع (به خاطر مالکیت خصوصی و حساسیت داده‌های صنعتی) کمیابن، گوگل مدل رو کاملاً روی صدها میلیون دیتاست synthetic آموزش داده که با Structural Causal Models (SCM) تولید شدن.

نتایج: روی بنچمارک TabArena (۳۸ دیتاست classification و ۱۳ تا regression)، حتی در حالت zero-shot عملکردش با baseline های heavily-tuned مثل gradient-boosted trees قابل رقابته و با یه نسخه ensemble (ترکیب ۳۲ متغیر با NNLS solver و SVD features) نتایج بهتری هم می‌گیره.

دسترسی:
وزن‌ها روی HuggingFace هم موجودن (نسخه‌ی PyTorch و JAX/Flax)

به زودی از طریق BigQuery هم با یه دستور ساده AI.PREDICT در SQL قابل استفاده میشه
  • 👌 8
  • ❤ 6
Post #4335 3.47K
یه مدل بنیادی (foundation model) جدید منتشر شده توسط گوگل برای داده های ساختار یافته، هم برای رگرسیون هم طبقه بندی قابل استفادست

TabFM: Tabular Foundation Models
https://github.com/google-research/tabfm
  • ❤ 10
  • 👍 1
Post #4334 3.52K
Tensorflow(@CVision) 🚀 ساعاتی پیش Claude Sonnet 5 معرفی شد آنتروپیک از Claude Sonnet 5 رونمایی کرد؛ عامل‌محورترین مدل خانواده Sonnet تا امروز. 🔹 عملکردش به Opus 4.8 نزدیک شده، اما با قیمتی به‌مراتب پایین‌تر 🔹 پیشرفت محسوس نسبت به Sonnet 4.6 در استدلال، استفاده از ابزار‌، کدنویسی…
مدل Fable 5 دوباره در دسترس قرار گرفته ...

متاسفانه همزمان با عرضه مجدد، امروز حساب کلاد کاربران ایرانی مختلف هم مسدود شده و خیلی سخت تر میشه استفاده کرد.
  • ❤ 11
  • 😱 3
  • 🤯 1
Post #4333 4.22K
🚀 ساعاتی پیش Claude Sonnet 5 معرفی شد

آنتروپیک از Claude Sonnet 5 رونمایی کرد؛ عامل‌محورترین مدل خانواده Sonnet تا امروز.

🔹 عملکردش به Opus 4.8 نزدیک شده، اما با قیمتی به‌مراتب پایین‌تر
🔹 پیشرفت محسوس نسبت به Sonnet 4.6 در استدلال، استفاده از ابزار‌، کدنویسی و کارهای دانش‌محور
🔹 از امروز در همه پلن‌ها در دسترسه؛ مدل پیش‌فرض پلن‌های Free و Pro، و در دسترس برای Max، Team و Enterprise
🔹 در Claude Code و Claude Platform هم فعاله؛

نام مدل برای API:
claude-sonnet-5

💰 قیمت‌گذاری مقدماتی (تا 31 آگوست 2026):
ورودی: $2 به ازای هر میلیون توکن
خروجی: $10 به ازای هر میلیون توکن
بعد از اون: $3 ورودی / $15 خروجی

🛡 ایمنی:
نرخ رفتارهای نامطلوب نسبت به Sonnet 4.6 کاهش پیدا کرده و در زمینه‌های عامل‌محور (مثل مقاومت در برابر حملات prompt injection) ایمن‌تر شده. توانایی انجام کارهای سایبری خطرناک (مثل توسعه اکسپلویت) به‌طور قابل‌توجهی پایین‌تر از مدل‌های Opus هست.

📖 جزئیات کامل:
https://www.anthropic.com/news/claude-sonnet-5

#Claude #Anthropic #AI #LLM
Anthropic Introducing Claude Sonnet 5 Our most agentic Sonnet yet, with top-tier intelligence for coding and everyday professional work.
  • ❤ 5
  • 👍 1
Post #4332 3.3K
آموزش LLM و VLM 🖼️ Krea 2 Turbo مدل تولید تصویر اوپن‌سورس با ۱۲ میلیارد پارامتر مجپوعه Krea AI اولین مدل بومی خودش رو منتشر کرد و وزن‌ها رو هم اوپن‌سورس کرده. ✨ چرا جالبه؟ ▸ تولید تصویر ۲K در ~۲ ثانیه روی GPU معمولی ▸ فقط ۸ inference step، بدون CFG ▸ رتبه اول بین لب‌های…
برای این مدل krea تازه منتشر شده یکی LoRA ترین کرده که بزارید کنار مدل تا تصاویر realistic درست کنه

https://huggingface.co/gokaygokay/Krea-2-Realism-LoRA
huggingface.co gokaygokay/Krea-2-Realism-LoRA · Hugging Face We’re on a journey to advance and democratize artificial intelligence through open source and open science.
  • ❤ 6
Post #4331 5.15K
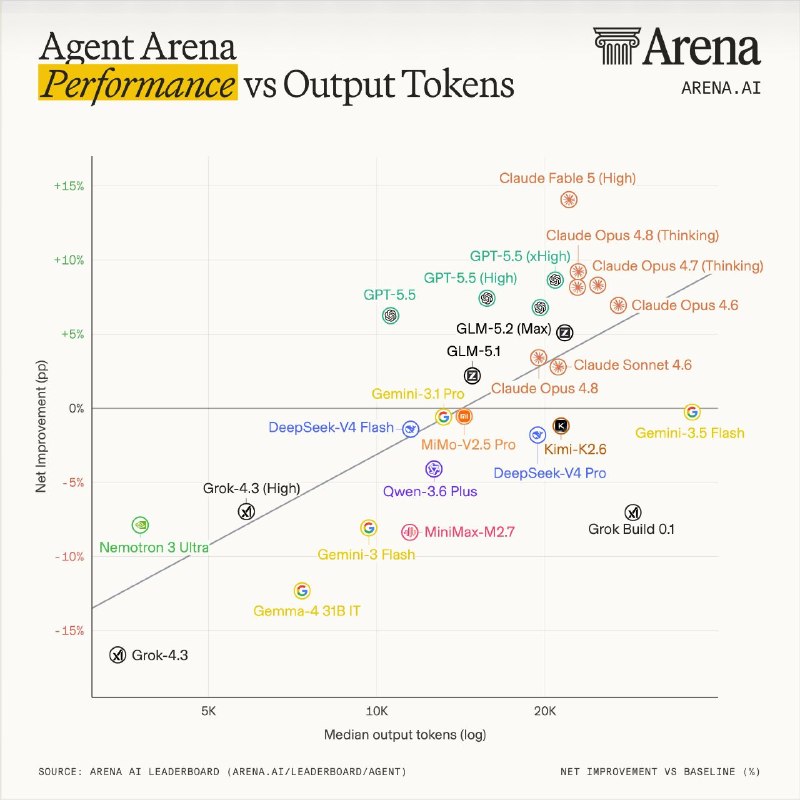
📊 بهره‌وری توکن در Agent Arena

بنچ مارک Agent Arena عملکرد ایجنت‌های هوش مصنوعی رو روی تسک‌های واقعی (نوشتن کد، ساخت اسلاید، تحقیق وب، توسعه اپ، تحلیل اسناد) با ابزارهای search، filesystem و terminal می‌سنجه.

نکته کلیدی اینه که مصرف توکن بیشتر همیشه به کیفیت بهتر منجر نمی‌شه. این نمودار هر مدل را نشون می‌ده
بهبود عملکرد (عمودی) در برابر میانه توکن مصرفی (افقی) — و یک خط روند کلی ترسیم می‌کنه. فاصله از این خط، بخش جالب ماجراست.

یافته‌ها:

✅مدل Opus با توکن کمتر کیفیت بالاتری می‌ده. Fable با +۱۴.۱٪ بهترین کیفیت رو داره، در برابر +۹.۲٪ برای Opus 4.8 Thinking با مصرف توکن مشابه.

✅ هر سه مدل GPT-5.5 (بین +۶.۲٪ تا +۸.۶٪) بالای خط بهره‌وری قرار دارن، با توکن کمتر از مدل‌های پیشروی Claude.

✅ مدل GLM-5.2 با +۵.۱٪ تقریباً دقیق روی خط روند قرار می‌گیره.

⚠️ توکن مساوی بازده نیست: Gemini-3.5 Flash بیشترین توکن رو مصرف می‌کنه ولی فاصله زیادی تا فرانتیر داره، و Grok Build 0.1 با ۲۰هزار+ توکن، بهبود منفی نشون می‌ده.

⚠️ گوشه پایین-چپ (مصرف کم، بازده کم): Grok-4.3، Nemotron 3 Ultra و Gemma-4 31B.

@cvision
  • ❤ 6
  • ❤‍🔥 2
Post #4330 2.84K

Forwarded from آموزش LLM و VLM

روش MiCA جایگزین قدرتمند LoRA در Fine-tuning

یه روش جدید به اسم MiCA یا (MinoCA Component Adaptation) به کتابخونه PEFT هاگینگ‌فیس اضافه شده و نتایجش چشمگیره.

ایده اصلی
تکنیک LoRA روی بخش‌هایی از مدل تمرکز می‌کنه که بیشترین استفاده رو دارن. MiCA برعکس عمل می‌کنه — روی فضاهای کمتر استفاده‌شده (minor singular subspace) تنظیم می‌کنه تا دانش جدید جذب بشه بدون اینکه دانش قبلی از بین بره.

نتایج روی ۳ مدل مختلف:
📈 +۸۸٪ یادگیری دانش جدید نسبت به LoRA
🧠 -۱۹٪ فراموشی فاجعه‌بار (Catastrophic Forgetting)
⚡ -۸۳٪ پارامتر قابل آموزش


استفاده ازش ساده‌ست. فقط یه خط تغییر کافیه:
init_lora_weights="mica"
کاربرد اصلی:

به‌خصوص برای continued pretraining و domain adaptation — جایی که می‌خواید مدل دانش جدید یاد بگیره ولی توانایی‌های قبلیش رو حفظ کنه.


🔗 لینک‌ها:
📄 Paper (arXiv): https://arxiv.org/abs/2604.01694
🤗 HuggingFace: https://huggingface.co/papers/2604.01694
💻 PEFT Example & README: https://github.com/huggingface/peft/blob/main/examples/mica_finetuning/README.md
  • ❤ 15
  • 👍 8
  • 👌 3
  • 🤯 1
Older posts →
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →