TGViewer
Channel Public Channel
Сіпласпластик

Сіпласпластик

@cpplastic

🇺🇦 Про айті та дотичні теми загалом, ну й трохи про C++.

Усі думки тут відображають виключно мій особистий погляд.

Мої емоджі:
https://t.me/addemoji/AdaptiveDevIcons
https://t.me/addemoji/VehicleBrands
Subscribers
739
Photos
190
Videos
38
Links
295

Showing posts older than #523 · Back to latest

Older Posts 19 shown
Post #522 1.26K
Дізнався пару днів тому з якоїсь статті, яку вже загубив, про фічу в Git 💻, котрої мені бракувало.

Річ у тім, що в моїх робочих копіях git-сховищ часто купа якогось сміття: прототипчики, скрипти, тимчасові файли або ж файли, які не треба комітити — одним словом те, чим користуюся я сам і що варто ігнорувати.

Так, існує .gitignore, але засмічувати його своїми масками файлів чи тек не завжди добре: по-перше, часто воно дійсно треба лише мені, по-друге, файл розростатиметься, по-третє, бувають випадки, коли сама наявність певного імені файлу в списку небажана.

Виявилося, що .gitignore — не єдине місце, куди можна щось таке вписувати. Є ще .git/info/exclude, який працює так само, але сам він під контролем версій не знаходиться, тож при стягуванні репи іншими членами команди у них цього всього не буде. (Хуки теж десь усередині .git лежать і страждають від цієї ж проблеми, чим мене бісять. Але тут навпаки зручно).

Також є глобальний список ігнорування, який лежить в ~/.config/git/ignore. Я на macOS, тож у мене там приблизно таке:
.DS_Store
**/.claude/settings.local.json

Якщо ви на вінді, то впишіть туди thumbs.db 😆

Ну й наостанок можна ще розповісти про команду для перевірки, чи щось ігнорується ґітом:
git check-ignore <path>

(Хто б сумнівався, що вона існує. У моїй версії git зараз у районі 160 підкоманд 🤯 Unix way, ага).

Краще запускайте з --verbose, і воно тоді покаже, звідки саме прийшов ігнор:
> git check-ignore .DS_Store --verbose
/Users/cpplastic/.config/git/ignore:1:.DS_Store .DS_Store
  • 👍 31
  • 🔥 3
  • 🤣 1
Post #521 1.3K
Я обожнюю скінченні автомати. Це штука, яку дуже легко втямити і яка потім вам знадобиться мільйон разів. Їх можна використовувати для опису процесів, автоматизацій на кшталт IoT або CI/CD, діалогів або поведінки НІПів в іграх, парсингу тощо. Завдяки їм зручно контролювати послідовність виконання чого-небудь, робити відновлення до попередніх станів, обробляти помилки. (Памʼятаю, у нас у MBUX був скінченний автомат для підʼєднання телефону до автівки по Bluetooth… на півтори сотні станів 😵‍💫 Гляньте якось BT-спеку заради цікавості).

Але найулюбленіший мій спосіб їх використовувати — це звісно UI. Як усім відомо, найбільша проблема UI — це комбінаторний вибух станів. Якщо у вас купа «прапорців», які можуть по-різному впливати на поведінку програми, то інколи навіть утримати це все в голові важко. Але щойно ви робите скінченний автомат, усе стає значно легшим!

На прикладі вгорі якраз такий для мого таймера на Pebble. На годиннику всього чотири кнопки, але уявіть собі код обробки натискання BACK без скінченного автомата: це був би довжелезний ланцюг if-else штибу «якщо таймер запущений, але не на павзі», «якщо таймер запущений і на павзі, але програється анімація скидання» і ще десяток таких. Натомість я описав окремі стани програми, і в кожному стані у кожної кнопки лише одна функція. Я писав на 💻, тому обробник натискання кожної кнопки перетворився на простий switch.

Але бувають способи й красивіше. Наприклад, QML дозволяє описувати скінченні автомати декларативно. Обожнюю цей підхід. Також існує цілий окремий стандарт для опису скінченних автоматів в 💻 — SCXML; деякі тулзи вміють його читати, навіть той же 💻.

Проте той же таймер мій — це дуже проста програма. Що робити, коли в'юшок стає багато? Ну, вочевидь робити більше скінченних автоматів!

Доволі зручно робити їх ієрархічними. Уявіть типове IDE, в якому є «звичайний» режим кодінгу і є окремий режим зневадження — це ваш скінченний автомат верхнього рівня з двома станами. У кожного автомата є точка входу, наприклад, в IDE ви завжди починаєте у звичайному режимі. Коли ж ви перемикаєтеся в режим зневадження, то на екрані відбувається багато чого: відкриваються нові панелі, зникають інші, міняються гарячі клавіші, інколи навіть кольорова тема змінюється. У принципі для цього всього можна було б побудувати гігантський «плаский» скінченний автомат, але значно зручніше робити їх вкладеними: наприклад, щойно ви попадаєте в стан зневадження, ви активуєте інший скінченний автомат, що контролює ті ж панелі чи гарячі клавіші. У нього буде власна точка входу й власні стани, і найголовніше — йому взагалі не треба навіть знати про існування звичайного режиму.

На діаграмі цього нема, але в моєму таймері насправді теж є дещо схоже. Річ у тім, що з головного екрану перед запуском таймера можна по довгому натисканню на SELECT зайти у вікно вибору кольорових тем, тож фактично є два стани верхнього рівня: сам таймер та його налаштування. Останні — це звичайний список, який можна гортати вгору-вниз відповідними кнопками, можна підтвердити вибір або повернутися назад. SDK платформи фактично дає напівготовий компонент для цього, тож мені не довелося писати все вручну, але всередині там звісно теж якась імплементація скінченного автомата.

Окрім цього стани можуть паралельними, що якраз чудово комбінується з ієрархічними станами. Коли спробуєте побудувати щось більш-менш складне, зрозумієте, де саме це стає в пригоді.

Переходи між станами також можна робити по-різному: це може бути реакція на щось, може таймер спрацьовувати, може бути безумовний миттєвий перехід, може бути перехід зі стану в той самий стан (наприклад, заради сайд-ефектів, що виконуються при вході або при виході) тощо.

Одна з розповсюджених помилок, які я бачу: зробити основу UI на автоматі, а потім за якоїсь термінової потреби «примазати» там десь фічу звичайним ifʼчиком. Повірте на слово, робити так не варто — у майбутньому пожалкуєте десять разів. Краще зробіть це частиною цього ж автомата або ж додайте ієрархію.

До речі, за брак зручної можливості робити скінченні автомати я не люблю автоматизації в Home Assistant.
  • 👍 18
  • 🔥 5
  • 🤯 1
  • 👀 1
Post #520 1.01K
Пан К. у своєму каналі «Мамкін Архітектор» написав днями про довіру в команді, зокрема довіру керівника до виконавця. Історія там така, що гіпотетичний(?) чувак заестимейтив та зробив задачу, але в керівника лишився осад. «Телефон чорно-бєлий, а довжен буть цвітний. Шо мені робить?»

Ну й висновок автора, що варто будувати «zero trust», де кожен завжди під ковпаком (причому так, щоб ніхто цьому не дивувався й не ображався), хоча конкретних методів не дає. Я з певними твердженнями погоджуюся, але загалом маю альтернативний погляд на все це, про який і напишу.

Значить ситуація:
[…] розробник ставить оцінку на тиждень, зникає на чотири дні, і повертається з пул-ріквестом, де коду на три години з перекурами. […] Лишається відчуття, що тебе трошки намахали…


У мене тут картинка якось не склалася. Якщо манагер оцінив, що «коду на три години», то він, певно, тямить. Тоді як він прийняв початкову оцінку в тиждень? А якщо не тямить, то чому зараз береться оцінювати самотужки? 🧐 (До речі, статистично доведено, що люди значно більше поважають керівників, якщо думають, що ті здатні виконувати їхню роботу.)

Як хтось написав у коментарях — скрам уже всі ці проблеми розвʼязав, і в чомусь це правда. Інша розмова, що скрам у всіх різний, і мало хто бачив його в канонічній формі, та ще й щоб працював. Принаймні стосовно оцінювання я виніс з однієї з контор чудову пораду.

Оцінювати задачу мусить не той, хто її імовірно робитиме, а вся команда. Якщо команда не пристріляна, то естимейти зазвичай мають нормальний розподіл. Тоді ті, хто дали найнижчу та найвищу оцінки, мають пояснити чому. Це корисно з усіх боків: по-перше, шариться досвід, по-друге, випливають раптові нюанси, про які подумав лише хтось один, по-третє, члени команди вчаться працювати один з одним.

Ідемо далі. «Розробник зникає на тиждень» — це очевидна дурня. Ті ж дейліки винайшли саме для того, щоб такого не було. Взагалі даю пораду програмістам: менеджери завжди мають значно більше задач, ніж фізично можна виконувати. І єдине, про що вони мріють з боку команди — щоб усе йшло за планом. А значить ви як виконавці маєте два обовʼязки: робити все можливе, щоб виконувався план, і повідомляти одразу, щойно він перестав. Тоді керівник має більше простору для маневрів з вищими менеджерами або замовником, а отже відносно задоволений.

Додаткова порада, як уникати зайвих питань «чим займався?»: робіть більше комітів! 💡 Почали робити задачу — одразу створили гілку, запушили на ремоут і створили чернетку PR; далі щовечора докидаєте туди те, що встигли зробити. Перший раз манагер спитає, а на другий — піде й сам гляне. Всі задоволені.

Ну й нарешті дійшли до теми про zero trust. Якщо ваша команда — це циферки на дашборді, то може воно й норм, але загалом вважаю такий підхід украй шкідливим. Навіть девіз щойно вигадав: zero trust — zero thrust 😮‍💨

Все йде з культури. В якийсь момент (мабуть, після книжок No Rules Rules та «Принципів») мене осяяло, що якщо ставитися до кожного як до спеціаліста своєї справи, котрими вони і є, (а не як до баранів, котрих треба за мотузку тягати), то вони раптом починають працювати збс, беруть на себе більше відповідальності тощо. В українському айті, на жаль, найчастіше зустрічаються два типи «менеджерів»: учора-програміст, на якого навалили купу задач з керування командою за додаткові пів гривні на рік, або той, хто дорвався до влади й починає всіх дойобувати. Школа менеджменту фактично відсутня. Мені ж більше імпонує тема про servant leader й оце все.

Щоб це працювало, керівники мусять давати більше інформації. (Згадайте, як ваш менеджер відміряє вам крихти інфи, наче в аптеці). Коли в людей є достатньо даних, щоб сформувати ширшу картину того, що є й чого треба досягти, вони починають знаходити значно ефективніші рішення. Окрім інформації треба давати ще відповідальність+авторитет. Перше треба для того, щоб працівник був умотивований досягати результатів (і отримував за це дофамін), а друге, щоб у нього були потрібні засоби. Очевидно, що на «нульовій довірі» це все не працюватиме. Навіть навпаки: треба дуже багато довіри.

А от куди zero trust добре пасує — так це до себе. Щоразу, як вам здається, що ви знаєте щось краще, спитайте себе, а чи дійсно ви довіряєте своєму судженню і чи не сліпа це довіра.

Тепер якщо ще раз перечитати оригінальний допис, на який я посилався на початку, то можна побачити дуже багато спільних рис і висновків з декількома важливими відмінностями. Та в одному, я думаю, ми б точно дійшли згоди: треба вибудовувати здорові взаємини в команді. Це важко й довго, але воно точно окупиться. А бракованих цеглин краще позбуватися 🙂
Telegram Мамкін Архітектор Буває таке: розробник ставить оцінку на тиждень, зникає на чотири дні, і повертається з пул-ріквестом, де коду на три години з перекурами. Потім дуже ображається, коли у нього запитують пояснення, розказує, шо там було складно, він багато думав, і взагалі…
  • 🔥 31
  • 👍 12
  • ❤‍🔥 3
  • 😁 1
  • 🤣 1
Post #519 1.05K
Так сталося, що я вже другий тиждень пишу бекенд системи на Java 💻. До того писав фронтенд на 🕸 + React ⚛️ — це не QML, звісно, але загалом жити можна. А тут в мене тепер дефолтний набір зі Spring Boot та Hibernate. І шо я хочу сказати…

Тяжко! По-перше, Java як мова не альо — прям тухлувато якось. Вона явно стала краща відтоді, як я нею писав востаннє 15 років тому, але на цьому ґрунті нічого хорошого вже не виросте. По-друге, надлишкова інженерія в джаві відчувається явно інакше, аніж в 💻. Я впевнений, що це все не зʼявилося без причини. Певно хтось колись писав систему, набив собі купу синців і сказав: «Треба більше рівнів абстракції». І стало більше рівнів. Ну тобто ми показуємо табличку з БД майже один до одного, але тут repositories, entities, DTOs, mappers й оце все — дуже швидко відчуваєш на собі слово enterprise. Мабуть, і в книжках так радять робити.

Але біс із ним. Справжня ж проблема — це анотації! О-о-о, тут цілий окремий світ. Джаву вивчити легко, але її самої замало. Тут на анотаціях фактично свій eDSL, а точніше навіть декілька — по одному на бібліотеку: всі ці @Autowired, @Retention, @OneToMany, @JoinTable, @Mapper, @MappingTarget і ще три десятки. Нарешті я втямив, що мали на увазі люди, з якими я спілкувався про недоліки предметно-орієнтованих мов.

Річ у тім, що взагалі-то я люблю eDSL! (Якщо хтось не знає: eDSL — це фактично якась зазвичай вузькоспрямована мова, побудована засобами іншої). І люблю мови, в котрих їх можна робити: Ruby ♦️ той же, REBOL звісно, та навіть у Python 💻 я декораторами різне цікаве мутив. Це все чудово працює в одному з трьох випадків:

1. Ти створюєш це сам просто зараз.
2. Хтось поряд із тобою створює eDSL просто зараз, а ти його використовуєш.
3. Це стандарт де-факто.

У решті ж випадків це суцільний біль. Мало знати хостову мову: ти дивишся на конструкцію і розумієш, що вона значить синтаксично, але не семантично. Доводиться вчити ще декілька вбудованих мов. Я вочевидь цього поки не зробив, тому відкриваю файл, бачу там один порожній інтерфейс з пачкою анотацій — і нічого не розумію. Відкриваю інший — там те саме. Просто купа напівпорожніх файлів, їй-богу.

А компілятор з цього генерує цілі класи з методами, сам автоматично розрулює звʼязки між ними, щось там ще робить. Ти потім це запускаєш, а воно і до бази якось конектиться, і обʼєкти один в одного переганяє. Жодних конструкторів тобі з прокиданням чогось кудись. Чистенько. Але забагато магії ⚡️

Класно, коли магії є трошки — додає цікавинку в розробку. Але не коли ти з 20-річним досвідом не можеш збагнути звʼязки між класами 😅 Ну, воно-то зрозуміло, що я це не тямлю, бо я ніколи з цим не працював досі. А от коли сіньор-джавісти кажуть, що не знають, як воно працює, то це трохи підозріло.

Цікаво, чи станеться щось подібне з C++, враховуючи, що в цій мові тепер є reflection. На мою думку, навряд чи. Піду, короч, пірнати у ваш Spring, а ви поки можете глянути на чиюсь стару бібліотеку для C++, яка дозволяє писати отак (так-так, це eDSL):
using namespace xsmell;

document doc =
_
<html>_
<head>_
<title>"XSMELL demo"<!title>_
<!head>_
<body>_
<p>"Yesssssssssssssssss!"<!p>_
<img .src("chucknorris.png") .alt("sneezing eyes open")>_ <!img>_
<!body>_
<!html>
_;

std::cout << doc << '\n';
  • 😁 12
  • 💯 8
  • 💊 1
Post #518 1.21K
Не існує у світі бравзера, який би бодай один раз не профачив мої вкладки (принаймні відтоді, як вони їх начебто зберігають).

Нині досі користуюся Arc, бо нічого зручнішого для себе поки не знайшов, але як продукт він уже мертвий. Чули, може, що їх купила Atlassian? Ну, помер він ще раніше, бо команда почала робити інший бравзер Dia. Врешті не маємо жодного.

В арку є два типи вкладок: вгорі щось на кшталт ваших букмарків, а знизу типу «операційні» — ті, які ви в процесі роботи відкриваєте-закриваєте. І ще і «фіча», що з плином часу він оці нижні закриває автоматично — ненавиджу її! Добре, що хоча б можна перевідкрити.

Отже, що маємо: відкритий Arc з купою вкладок на компі. Запустив інший комп, який не чіпав місяцями. І Arc такий: «опа-опа, зараз усе тобі посінкаю» — і зносить мені штук 150 вкладок, буквально лишив десяток 🤯 «Добре, — думаю, — що хоч відновити можна». Відкриваю архів, а їх там нема! Якесь лайно прохідне, яке я відкрив на пів хвилини, є, а всього потрібного нема, бо це ж не я їх закрив і не оця окрема «фіча» — це зробив їх резолвер синхронізації, що вочевидь працює в обхід. Ну йобен-бобен, як так можна писати‽ Я розумію, що CRDT здається складним і все таке, але краще б воно дублювало вже інфу, аніж навпаки її вбивало! Та і який тут CRDT — просто два списки помержити; навіть не обов'язково це в реалтаймі робити.

Окрема тема — це історія в бравзерах. Типовий приклад фічі, яку задизайнили програмісти. Звідки я знаю? Ну бо користі з неї нуль! Є в тебе одна важлива вкладка, яку ти випадково закрив. Припустимо, що й бравзер перезапустив(ся), тож Ctrl+Shift+T чи шо там у вас — не спрацює. Відкриваєш історію, щоб знайти — і все, кінець, без шансів. Бо історія показує за датою відкриття вкладки, а не за датою закриття. Ще жодного разу не треба мені було дізнатися, коли я вперше щось побачив, але регулярно треба щось знайти, що я бачив востаннє три дні тому. Ну зате воно збереже вам кожний з двохсот переходів по сторінках на ґітгабі за останні пів години як окремий запис — дуже корисно, дякую.

Відновив урешті теку Arc з позавчорашніх бекапів системи. Я чувак уже досвідчений, тому перш ніж запускати бравзер, я вимкнув Wi-Fi, щоб синхронізація знову все не вбила 🧠 Усі потрібні вкладки позапінював у букмарки, а тоді вже під'єднався. Але варто віддати стартап-програмістам належне: вони мене все-таки переграли: синхронізація взяла, знайшла їх навіть там і видалила! Тому процес довелося повторювати. Окремий жарт — це вбудовані в Arc бекапи стану, відновлення котрих не працює.

І шо з цим робити? Хоч сідай і вайбкодь собі нормальний бравзер, я хз.
  • 😁 24
  • 👍 4
  • 😭 4
  • 🤯 1
Post #517 1.39K
Подивився учора документалку про C++. Сподобалася! Вище вже згадував аналогічні про Python та Clojure, але ця, звісно, якось ближче до серця сприймається, бо знайомі люди.

Розповідають про появу та становлення мови. Мені найцікавіше було послухати про самий початок. Помітив, як в різний час приходили та йшли різні люди (навіть різні типи людей), та й загалом видно, наскільки по-іншому раніше приймалися рішення, що напряму впливали на розвиток мови та індустрії. (Чи не по-іншому?).

Концентрація крутих дідів на хвилину відео вкрай висока. Керніган прям бодрячком мужик, молодець! Ромеро засвітився, куди без нього. У Александреску очі запалали, коли мова про шаблони зайшла. Понасміхалися з Java 💻, розповіли, як Степанов замовив собі 3 пляшки вина (вгадайте, до чи після того, як вигадав STL), один раз навіть прозвучало слово Rust. Гейлсберґ якось невдало спробував охрестити Б'ярне BDFL. Ще купа вельми цікавих людей посвітили обличчями. Та й таке. Раджу короч!

Ну а щоб трохи збалансувати враження, потім можна полірнути оцією чудовою статтею про те, чому 💻 котиться в прірву через свою (майже) непорушну політику збереження зворотної сумісності. Там про те, скільки за останні роки додали фічей в мову та стандартну бібліотеку та скільки з них реально досі живі. Дізнався, що вже навіть std::function неофіційно вважається застарілою, і треба використовувати щось інше (але з бібліотеки звісно не видалять, бо купа коду написана). До тієї самої прірви C++ котитися ще доволі далеко, але їм би все-таки щось вирішувати з розміром комітету, бо той цирк, що зараз, на користь аж ніяк не йде.

Ну а дядьку Б'ярне можу хіба що побажати побільше здоровʼя та ще раз подякувати за таку топову мову!
YouTube The Story of C++: The World's Most Consequential Programming Language | The Official Story This is the story of C++, one of the world’s most widely-used and consequential programming languages. C++ divides opinion, resists replacement, and has outlasted almost everything built to supersede it. C++ The Documentary traces the full arc, from its…
  • 🔥 10
  • 👍 3
  • 🤣 1
Post #516 1.15K
Я доволі лояльно ставлюся до багатьох мов програмування. Багатьма з них користуюся, інші просто пробував і здебільшого всі поважаю. Але одне лишається незмінним:

Я ненавиджу Bash 💻 усім своїм єством!

Я ненавиджу його читати й ніколи не пишу. Того тижня попросив 🅿️ зробити собі тул для Nushell 🆕, і щойно він закінчив, я тут же заборонив йому використовувати вбудований Bash.

Авжеж це не дуже допомогло 🙁 Усі моделі так надрочені на той клятий баш, що їм до сраки якийсь Nushell. Я прямо в системний промпт прописав, що це НЕ баш, що це навіть не POSIX-оболонка, написав відмінності, написав аналоги для типових шел-патернів — по барабану. Воно продовжує мене дрочити своїми 2>&1 і 2>/dev/null, комбінує команди через && та пише декілька ls у рядок, щоб подивитися вміст кількох директорій за один виклик. Nushell на це, звісно, скаржиться, або ж це просто дає не ті результати, і модель починає переписувати команди по пʼять разів, доки не вгадає синтаксис. Буквально «вгадає» — інакше це назвати не можна. Ось де чудово видно, що це аж ніяк не інтелект.

Ну добре, біс із тим Pi. Запущу-но старий-добрий Claude Code 💻, подумав я. Не чіпав його місяць узагалі, може півтора. Здавалося б… місяць… це ж ніщо. У мене деякі пет-проєкти по 2 роки лежать, а я потім їх відкриваю й продовжую, наче останній коміт зробив учора. Такий собі анабіоз.

Але не в цьому випадку! Відкрив claude, він наче на вигляд такий самий, але поводить себе інакше. Самі моделі реагують інакше, ярмо відчувається інакше! Тули Grep та Glob зникли, і ця хуйня тепер все ганяє через Bash. Я розумію, що вони зробили свій супер-пупер автоматичний «інтелектуальний» режим, де інша(?) модель оцінює, наскільки безпечно виконувати команди, і тепер це такий типу дефолт. Але я дід — мені таке не треба. Я люблю сам оцінити, що треба, а що не треба викликати. От тільки не коли воно мені висирає по 15 рядків на баші замість запустити два ґлоба та три ґрепа!

Так, я міг би не вимахуватися, а бути читати баш, як усі. Але ви ж розумієте, що річ не в ньому? Річ у виборі.

Не стоїть вибір між «використовувати ШІ з Bash» та «використовувати ШІ з Nushell» — є вибір «використовувати ШІ з Bash» або «не використовувати ШІ», бо воно просто не працює інакше. А скільки разів ви вибирали саме TypeScript 🕸 чи Python 💻 для своїх чергових пет-проєктів, бо на них ШІ знається краще? Закладаюся, що були ліпші альтернативи за кількома параметрами, окрім хіба що швидкості розробки.

І навіть тулзи вам не належать. Вони встановлені у вас локально на компі, ви не чіпаєте їх місяць, а потім гоп — а там усе інакше. Ваші звички, які ви формували, більше не актуальні; налаштування не працюють — читайте мануал знову, витрачайте свій час, бо хтось вирішив, що вашому ярму (гг) час оновитися.

Єдине рішення, яке лишається вам: робити щось із використанням ШІ чи без. «Але ж, Сіпласпластик, — вигукнете ви, — якби не ШІ, то багато моїх ідей взагалі не матеріалізувалися б!» — і матимете в чомусь рацію. Хоча я все частіше розмірковую: а може воно було й на краще?

Так чи інакше, щодо себе звернув днями увагу, що з появою ШІ я значно більше почав програмувати саме руками, ніж до того (бо раніше просто нічого не робив 😌). Цікавий ефект.
  • 🔥 18
  • 😁 11
  • 👍 5
  • 🤣 3
Post #515 1K
Сіпласпластик Тупий телеграм десь загубив мою превʼюшку посилання, і я не зміг її повернути )
А непогано вийшло врешті!
  • 👍 14
  • 🥰 5
  • 🤔 1
  • 👀 1
Post #513 1.15K
Колись купив собі ZigBee-адаптер SkyConnect (aka ZBT-1) від Home Assistant. Підʼєднав до ZHA, і якось воно працювало доти, доки не перестало. А цими вихідними нарешті дійшли руки сісти й спробувати полагодити.

Я переконаний, що проблема була саме в налаштуваннях 🍓 Raspberry Pi 3, на якому мій HA досі крутиться, але все одно вирішив з нього мігрувати, тож заразом і решті вирішив дати раду. І біс мене сплутав перешити бутлоадер на цьому ZigBee-адаптері (побачив, що версія застара 🤷‍♂️) через офіційну вебтулзу.

Ну й звісно воно повисло в процесі саме на екрані з написом «не відʼєднуйте пристрій від компа», тож за пів години я зробив вольове рішення відʼєднати 😅 І все. Кінець. Більше тулза його не розпізнала.

Пощастило, що комп його досі бачив, хоча нічого зробити з ним вже не міг. А в мене якраз валявся мікроконтролер на проці від Pico 2, та ще й з Debug-портом (SWD)! Зашив туди debugprobe і почав відновлювальні дії.

Спершу треба було зібрати чистий бінарь прошивки бутлоадера для ZBT-1. На щастя все з відкритими сирцями, тож у докері чік-чік — і готово. Далі розкрив корпус адаптера, щоб глянути, що на платі. А там є маленькі пласкі контакти для даних (SWDIO), синхронізації (SWCLK) та землі (GND), а значить можна підʼєднатися програматором.

Підколхозив якихось дротів, «програматор» підʼєднав до компа через USB, адаптер увімкнув у павербанк, щоб він отримував живлення, тримав руками оті всі контакти, щоб не паяти, а мізинчиком натиснув Enter на клавіатурі, щоб запустити прошивку через openocd, і вуаля — нічого не вийшло 😂

Щоб OpenOCD знав, як шити пристрій, у нього там конфіги якісь є. А під цей чип не було. Тому спробував pyOCD, який значно зручніший. Знову не вийшло. Пару разів дружина допомагала тримати контакти, але швидко знудилася, бо все одно безрезультатно.

Наостанок спробував probe-rs. З ним нарешті пощастило! 🎉 Не з першого разу, але врешті 5 секунд (і години три до того) — і готово! Перемога раста 🤓 І коли бутлоадер ожив, далі вже через веб зафігачив туди прошивку для ZigBee.

Є в мене друган, і в нього завжди серйозний такий підхід до всього: інфраструктура, віртуалки, high availability — по-дорослому, а я навпаки намагаюся завжди малою кровʼю обійтися. Якщо в мене Docker, то в нього Proxmox і Kubernetes, якщо в мене Synology, то в нього TrueNAS, у мене ZHA, у нього Zigbee2MQTT. І оце нещодавно я зауважив, що врешті я все-таки приходжу ближче до того, що в нього, тільки значно пізніше 😆 Короч, викинув я той ZHA і поставив Zigbee2MQTT — все працює тіп-топ! (Тепер думаю про TrueNAS гг).

До речі, якщо не в темі про ZigBee, то в дружньому, але нині, на жаль, напівмертвому каналі пан Шевцов розповідав про цей та інші протоколи.
  • 👍 12
  • 😁 5
  • 🔥 4
Post #512 1.01K
Отже, любі друзі, цей день настав. Ми підняли DC++!

Половина з вас, певно, і не знає, що це таке, бо протокол майже мертвий. Та десь після пʼяти розрядів деплоя інфраструктури ми побачили пульс!

Як це все працює? Насправді DC++ — це назва клієнтської програми, а сам протокол називається ADC (Advanced Direct Connect). Це гібридний протокол: має бути щонайменше один хаб, до якого підʼєднуються клієнти. Хаб забезпечує фічі на кшталт текстового чату, пошуку файлів, моніторингу підʼєднаних клієнтів тощо. Для передачі файлів клієнти звʼязуються один з одним через P2P.

Останні можуть працювати в активному або пасивному режимі. Для успішного обміну принаймні один клієнт має бути активним. Активні клієнти можуть приймати зʼєднання зовні, а пасивні можуть їх лише ініціювати. Та завдяки тому, що вони обидва підʼєднані до хабу, це не проблема. Якщо активний хоче щось стягнути з пасивного, то він каже про це хабу, той передає пасивному, а той вже сам ініціює зʼєднання, щоб з нього щось стягнули.

Ще в ADC (порівняно з DC) додали хешування файлів + підтримку TLS.

Для звʼязку самих мереж вирішили використовувати Tailscale. Проблема була в тому, що в моїй тейл-мережі вже 30+ вузлів, а у другана взагалі kubernetes-кластер зі своєю моташкою, і нікому з нас не хотілося надто це переналаштовувати чисто під цей випадок. Ми перебрали купу різних топологій, і щоразу впиралися то в якісь обмеження самого Tailscale, то ще в щось. (Думатимете, що питати на співбесідах по System Design, згадайте цей допис — кращого не знайдете, їй-богу). Врешті зупинилися на окремій спільній мережі з певними додатковими нюансами (якщо захочете, розповім детальніше) — запрацювало!

Дві наші головні помилки:

1. Ми зробили низку припущень, на базі котрих ми кинулися щось будувати, бо «ну, звучить збс» і «та хулі там», але згодом припущення виявлялися хибними: врешті час вже витрачений, а токени спалені. Тож порада: не намагатися перестрибнути декілька кроків, а почати реально з найбазовіших штук і переконатися, що вони працюють. Ніби по декілька десятків років досвіду в кожного, а робили як новачки якісь 🤷‍♂️
2. Своєрідне продовження попереднього пункту: ми за звичкою бахнули одразу ACL, де все закрутили, і полірнули файрволами — компи наче в одній мережі, але пакети не біжуть 🙁 Пішли від зворотного: тимчасово дозволили взагалі все, а далі почали закручувати. Тут допомогла можливість писати тести в тейлскейловому ACL — можна одразу прописати, хто до кого мусить ходити, а далі прибирати права.

Що маємо в результаті: окрема повністю незалежна й закрита від зовнішнього світу мережа, в якій є лише наші DC-клієнти та хаб. Можемо обмінюватися файлами за пів тисячі кілометрів один від одного по шифрованому каналу. Можемо вибирати, які файли шарити і які качати з яким пріоритетом, з підтримкою дозавантаження. Можемо слати у вбудованому убогому чаті келих пива в ASCII. Єдина залежність на чужу інфраструктуру — це координатор Tailscale, який за бажання можна замінити на власний Headscale.

А ваші сучасні технології так можуть? 😎
  • 🔥 19
  • 👍 5
  • ❤‍🔥 2
  • 👏 1
  • 🤣 1
Post #511 779
До слова про втрачені технології, які ми з друганом днями відродили з попелу.

Треба було перекинути великі файли (в ідеалі навіть більш ніж один раз). Як це зробити в сучасному світі? Ну, можна залляти кудись у хмару й зашарити. Але це якось тупо, бо спочатку, виходить, один туди заливає, а потім інший стягує — довго, незручно, ще й потребує чужих серверів.

Можна використати Syncthing, але ж він саме для синхронізації. Якщо один хоче поділитися терабайтною текою, а іншому зараз треба лише один файл звідти, то воно ж все одно все посінкає. Налаштовувати вибіркову синхронізацію головняково, доведеться якось по теках то все розпихувати, просити один одного — забагато роботи на рівному місці.

Якщо взяти FTP, то він суперповільний і з кепським пошуком. Можна звісно файловий HTTP-сервер задеплоїти — якийсь copyparty абощо — та це зовсім неспортивно й нецікаво. А умовний IPFS навпаки — забагато присідань треба зробити, та й пошук теж не альо.

AirDrop той же вимагає, щоб пристрої були фізично поруч. Аналоги на кшталт Taildrop існують, але воно в стані альфа вже роки, та й не надто стабільне — якщо звʼязок переривається, то потім тільки спочатку пересилати.

Гіпотетично можна використати торенти, які проблему перерваного завантаження чудово вирішують. Але торенти не надто самостійна технологія, бо треба якийсь трекер, треба ті торенти туди публікувати тощо. Як це все убезпечити — окреме питання.

Загальну ситуацію чудово підсумовує оця цитата невідомого автора:
сукааа чим блядь зумери файли кидають, невже якимсь тіктоком нахуй


Вочевидь це слушний момент, щоб згадати технології дідів… і мій дружбан згадав! Технологію, яка колись була популярніша за сам Інтернет! Технологію, що в декого викличе теплих почуттів не менше за виступ Лелеки. Не просто технологію — цілий культурний прошарок епохи розквіту локальних мереж в Україні…
  • 😁 12
  • ❤‍🔥 2
Post #510 1.03K
Лайнофікацією вже нікого не здивуєш — всім і так очевидно, що все стає гірше з часом, інколи доволі швидко.

Про продукти великих компаній навіть і говорити сенсу нема: там користувачі — це лише цифри на дашборді, менеджери воюють за владу, а команди розробників не розуміють, що вони роблять і в якому напрямі рухаються.

У стартапах же або в маленьких продуктових компаніях головна мета завжди — набрати користувачів і продатися. Ну або не продатися й тягнути лямку самостійно. Та доволі швидко постає питання, як заробляти гроші. І якщо продукт спочатку був безплатний, то відповідь на нього рідко кому вдається знайти, не змінюючи продукт, яким вони завоювали собі всіх тих користувачів.

Згадайте Dropbox. Це була геніальна ідея: є одна тека, ви кладете в неї будь-що — і воно відразу зʼявляється на інших пристроях. А ще в ній була підтека Public, яка автоматично роздавалася в інтернет. Можна було покласти туди index.html, і вуаля — у вас власний статичний сайт. Потім шарінг з друзями спаплюжили, Public прибрали, якісь гуглодоки власні накрутили — складно, незручно, незрозуміло, глючно. Лайно, отже. Шо там зараз, не знаю навіть — певно, ШІ.

Або був (і є) такий колись прикольний сервіс Pushbullet. Геніальна й проста ідея: можна перекидати посилання між пристроями. З одного надіслав — на іншому пуш прийшов. Натискаєш — автоматично відкривається в бравзері. На настільних компах тоді не було нормальних сповіщень (та й досі нема), тож там одразу відкривалося. Зручно. Потім звісно згівнили то все: додали якісь контакти з чатами, синхронізацію буфера обміну, файли й ще бозна-що. Може вже теж ШІ, хз.

Такі приклади я можу пів дня наводити: TeamViewer, Hamachi, μTorrent, Skype, CCleaner, Nero Burning ROM, Docker Desktop, Plex, Opera… — список можна продовжувати нескінченно. Ви більшість з цих назв навіть не знаєте вже, бо це лайно нікому не потрібне.

Цікаво інше: деяким з них ніхто не прийшов на заміну. Нє, ну альтернативи звісно були і є, але отак щоб прям зробити мінімально й зручно, як «оригінал» — то ні. Чому?

Тільки не треба радити Syncthing замість дропбокса або замість пушбулета через телеграм посилання перекидати, бо воно ж у рази менш зручне. Короч, міленіали вже все просрали — може зумери за 10 років здогадаються щось таке перевинайти. Чи ні?
  • 😐 12
  • 🔥 5
  • 😁 3
  • 😢 3
  • 👍 2
  • 🌚 1
  • 🙈 1
Post #509 1.55K
Всі нині показилися з агентними ШІ-системами. Звісно, цим всім добром треба якось керувати, тож є всілякі Claude Code, Codex, Gemini CLI, Copilot CLI, OpenCode, Pi, Crush, Hermes тощо. Зазвичай всі ці штуки називають загальним словом harness.

І мені прям око різало оце харнес, харнес… усюди. But fear no more! Зараз ми позбудемося цього мерзенного англіцизму раз і назавжди. Пропоную вашій увазі питомий український термін — ярмо! Схвалено верховним комітетом ШБТ 💙, лаконічне, усім знайоме, передає суть ідеально — кращого слова годі й шукати. Лишилося зробити його загальновживаним у цьому контексті, тому використовуйте, поширюйте.

Я, до речі, різні ярма спробував і наразі потихеньку пробую перелізати на 🅿️, бо з ним здається, ніби зможу досягти саме того, що мені треба (і не доведеться все писати з нуля).
  • 😁 30
  • 🔥 7
  • 🤨 4
  • 🤣 1
Post #508 1.42K
Після перегляду доповіді Гіккі натрапив на ще одну статтю про вибір мови в часи повсюдного використання ВММ для програмування. Чувак там, звісно, втоплює теж за Clojure 💻, але аргументи наводить обґрунтовані.

Зокрема посилається на… кхм… «коричневу межу» (мій довільний переклад brownfield barrier) з іншої статті — емпіричну величину, що являє собою кількість рядків коду, після якої ШІ-агенти починають тупити. Каже, мовляв, після 100 тис. LOC — уже шо зря.

Ми не так давно маленькою командою накидали проєкт на понад 80 тисяч рядків на Python, і ніби ознак такої проблеми не зауважили. Але в нас цикломатична складність мізерна — у районі 0,06 на рядок коду, — бо по-перше, запарилися все норм структурувати й модуляризувати, а по-друге, сам прототип не надто складний окрім декількох місць. Хоча складна частина там в SQL-запитах радше.

Попри це в певну мить вносити нові зміни в проєкт стало доволі боляче, особливо в режимі, коли всі активно навалюють код в одні й ті ж файли. Коли потім там чувак сам залишився, то навів ладу.

Але повернімося до кложі. Автор оце стверджує, що цією мовою банально складніше досягти коричневої межі, адже змістовність в ній значно вища. Нагадую, що сам-то я на кложі не пишу, хоча трошечки кодив на Janet; плюс я шанувальник Red і REBOL, а вони в цьому сенсі від ліспа не відстають — і я цьому твердженню про щільність значущого охоче вірю!

Ще там є посилання на цікаве дослідження з використання токенів різними мовами, і початково кложа була на першому місці, доки її не скинула звідти J. Остання, до речі, — це ASCII-діалект 🍏, тоді як сам APL пролетів через неефективну токенізацію. Ну, а C++ там звісно пасе задніх і лише трохи краще за C, хоча для кого це секрет.

У статті підіймаються й недоліки теж. Наприклад, той факт, що ВММ-ки гублять в ліспах дужки 😆 Я сам був очевидцем цього десь рік тому, та може відтоді щось помінялося на краще.

Короч хз, висновків якихось не буде — я просто отримав задоволення від статті й вирішив поділитися. Почитайте, бо вона значно глибша, ніж я оце переказав, до того ж спирається на вельми свіжі дані.
Context is everything Simple Made Inevitable: The Economics of Language Choice in the LLM Era Two years ago, I wrote about managing twenty microservices at Qantas with a small team. The problem was keeping services in sync, coordinating changes across system boundaries, fighting the entropy of a codebase that grew faster than our ability to reason…
  • 👍 8
  • 🔥 1
  • 😁 1
Post #507 1.21K
За свою карʼєру я чомусь обійшов стороною два трактати: «The Design and Evolution of C++» пана Страуструпа та «Simple Made Easy» пана Гіккі. І якщо стосовно першого в мене навіть в думках не було це читати, то друге вочевидь було прикрою помилкою, яку я вчора взявся виправити: з подачі пана Соловйова сів і подивився.

До деяких постулатів я останніми роками й сам дійшов, а до деяких поки ще ні. А міг просто глянути відос 15 років тому й одразу бути мудрим ще відтоді!

Раптом хто не в темі: цей типок є автором мови Clojure 💻 — найприємнішого LISPʼа сучасності (яким надихаються зокрема Janet 👩‍🦰 та jank 💻 — десь вище згадував, пошукайте), але в доповіді про цю мову не йдеться.

Ще там днями документалка вийшла про Річа та кложу на кшталт тієї, що кілька місяців тому була про Гвідо ван Россума та пайтон. ЇЇ теж глянув, але не сильно надихнувся на щось — мабуть, для фанатів робили, щоб ті на старі дріжджі впали.
YouTube "Simple Made Easy" - Rich Hickey (2011) Rich Hickey, the author of Clojure and designer of Datomic, is a software developer with over 30 years of experience in various domains. Rich has worked on scheduling systems, broadcast automation, audio analysis and fingerprinting, database design, yield…
  • 👏 10
  • 👍 6
  • 🥰 3
  • 👀 1
Post #506 1.39K
Коли мова заходить про використання генеративного ШІ в проєкті на роботі (особливо у великих компаніях), серед основних перепонів є завжди такі:
1. Лячно надсилати дані на чужі сервери всіляких Anthropic чи OpenAI (особливо якщо проєкт для замовника).
2. Згенерований код може бути підозріло схожий на чийсь ще, бо всі ВММ навчалися переважно на чужих відкритих сирцях.

З другим нічого не можу порадити. А стосовно першого… Річ у тім, що ШІ допомагає не лише код писати, але й аналізувати: знайти, що, де і як використовується, побудувати ментальну модель, пояснити звʼязки тощо. Тому доки ваша компанія розбирається, як хостити нормальну модель у власній хмарі, вам на допомогу приходять локальні моделі.

Жодне спілкування в чаті з надто загальними описами проблеми та копіпастою повідомлень про помилки не буде настільки ж ефективним, як використання агентної системи, яка може досліджувати код самостійно. Для прикладу: я днями намагався зібрати Xmakeʼом 💻-проєкт під WASM — нічого не виходило. Декілька годин спілкування з Perplexity коту під хвіст. Наступного дня дав копайлоту 💻 подивитися: він повивчав CMake-файли з самого кьюта, подивився на те лайно, що написане в Xmake, і врешті згенерував мені повністю робоче правило трохи менше ніж за годину.

Як повторити те саме з локальною моделлю? Ну, спершу треба… «запустити» модель. Я використовую LM Studio, бо є нормальний GUI та за потреби вміє працювати й у headless-моді.

Одна з найтоповіших моделей нині — Gemma 4 від ґуґла. Я вибрав Gemma 4 26B A4B з 8-бітним квантуванням. Тут правило просте: беріть те, що влізає на ваше залізо. E2B та E4B — для слабших пристроїв, A4B з так званим Mixture-of-Experts для макбука, 31B без додаткових приписок — не бачу сенсу.

Якщо у вас macOS, то постає ще вибір між MLX та GGUF. За моїми особистими відчуттями MLX завантажується в памʼять значно швидше. Але пишуть, що швидкість генерації починає відчутно падати з ростом контексту. А нам якраз доведеться працювати з великим контекстом, тому, певно, краще одразу брати GGUF.

Отже, стягнули модель, завантажили в памʼять. Можна прямо в LM Studio поспілкуватися в чатику, та сенсу в цьому мало. Натомість беремо OpenCode і додаємо цю модель туди (~/.config/opencode/opencode.jsonc):
{
"$schema": "https://opencode.ai/config.json",
"provider": {
"lmstudio": {
"npm": "@ai-sdk/openai-compatible",
"name": "LM Studio (local)",
"options": {
"baseURL": "http://127.0.0.1:1234/v1"
},
"models": {
"google/gemma-4-26b-a4b": {
"name": "Gemma 4 26B A4B"
}
}
}
}
}


Далі запускаємо:
opencode -m google/gemma-4-26b-a4b

Ну, або просто opencode і вже всередині вибрати через /model. І вуаля — тепер у вас особистий локальний майже клод код 💻.

Так, це вочевидь не Opus і, мабуть, навіть не Haiku, але для багатьох задач і цього достатньо! Пробуйте.
  • 👍 26
  • 🔥 3
  • 🌚 1
Post #505 944
Все ж приємно бачити, що 💻 потроху позбувається класичних способів поцілити собі в ногу.

Наприклад, усі ми знаємо, що C++ не ініціалізує змінні, і тому там може опинитися сміття, прочитавши яке можна піти за чужими адресами абощо. Ну, вгадайте шо? Більше ні! Точніше так, але є «але».
void foo() {
int d; // не ініціалізуємо
bar(d); // хоба! — не UB
}

Раніше цей код призводив до так званої невизначеної поведінки (UB — undefined behavior), а нині вона вельми визначена: відтепер це нова категорія — помилкова поведінка (erroneous behavior). Утім це не значить, що ваші змінні почнуть раптом занулятися чи робити щось притомне. Натомість змінна отримає «невизначений» стан (такий собі undefined, який не можна перевірити). Стандарт ніби не описує, що саме там має бути, тож усі компілятори робитимуть на свій розсуд. Але тепер вони принаймні зобовʼязані написати помилку при спробі це значення використати (не обовʼязково під час компіляції — може бути і в рантаймі).

А якщо дуже-дуже хочеться повернути UB, то можна використати новий атрибут 😆
void foo() {
int d [[indeterminate]];
bar(d); // Фух, старий-добрий UB :)
}


З інших приколів: прибрали порівняння масивів. Раніше можна було писати так:
int arr1[5];
int arr2[5];
bool same = arr1 == arr2; // тепер помилка

Не те щоб хтось дійсно таке писав, окрім джунів на співбесідах. Та й компілятори на це скаржилися з 2019 року. Але новачків це все одно плутає, бо arr1 та arr2 — це просто вказівники на початок масивів, і такий код порівнює їхні адреси, а не вміст. Добре, що позбулися.

Хоча знов-таки… Якщо дуже хочеться, то можна повернути стару поведінку, наприклад, через хак з приведенням типу до звичайного вказівника унарним плюсом 😅
int arr1[5];
int arr2[5];
bool same = arr1 == +arr2; // працює


Отже, C++ стає дедалі суворішою мовою стосовно таких дрібниць, що в більшості випадків є хибним кодом, і водночас не позбавляє свободи. Може в цьому й полягає секрет, чого вона так довго тримається на плаву?
  • 👍 13
  • 😁 1
Post #504 972
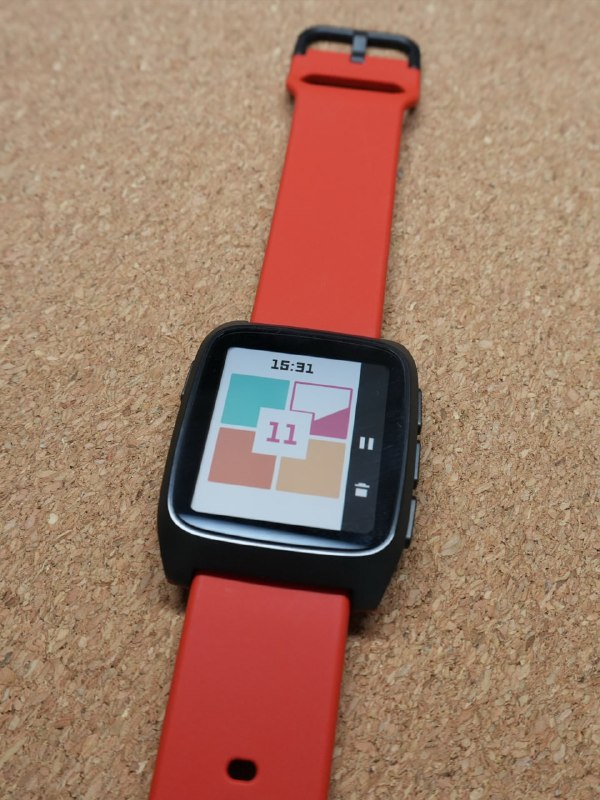
Сіпласпластик Памʼятаєте, я колись розповідав, що Pebble воскрес? Так ось вони там конкурс програм запустили, і я нашвидку (за 16 годин плюс-мінус ще стільки ж) накарлякав прогу. Починав писати на 🕸, але якось так тяжко пішло, ще й ШІ-шка не допомагала, а радила маячню.…
Тупий телеграм десь загубив мою превʼюшку посилання, і я не зміг її повернути )
Pebble Appstore Brush teeth - Pebble Appstore A tooth-brushing timer divided into four sections — your wrist vibrates at each transition. Adjust the duration per section (up/down), swap color themes (lon
  • 👍 3
  • 🤣 3
Post #503 913
Памʼятаєте, я колись розповідав, що Pebble воскрес? Так ось вони там конкурс програм запустили, і я нашвидку (за 16 годин плюс-мінус ще стільки ж) накарлякав прогу.

Починав писати на 🕸, але якось так тяжко пішло, ще й ШІ-шка не допомагала, а радила маячню. Тому перемкнувся на 💻 — і одразу стало легше дихати. Накидав скінченний автомат, декілька візуальних шарів, збереження стану в постійне сховище, вивід з фонового виконання.

До речі програмувати було значно легше, аніж дизайнити. Лише тільки для іконки, яка показується на годиннику в головному меню, довелося трохи спітніти. Хотів спочатку змусити ШІ-шку згенерувати мені SVG, але вийшло лайно. Тому завантажив її у Figma 💻, перемалював векторний path руками, експортнув — теж не сподобалося через відсутність піксельного вирівнювання. Далі зібрав із сирців Aseprite, завантажив туди експортовану PNG та попіксельно намалював руками.

З анімаціями ще складніше. На Pebble викориcтовується власний векторний формат PDC (фактично прото бінарний опис команд для малювання), який підтримує лише path, circle та precise_path — навіть без кривих! Path від precise path відрізняються типом координат: у першого викориcтовуються uint16, а в другого — fixed point 13.3 (13 бітів на цілу частину та 3 біта на дріб).

Існує якийсь скрипт 11-річної давнини svg2pdc.py на Python 2, але він працює вельми кепсько: підтримує лише SVG Tiny 1.2, до того ж згенеровані анімації були з артефактами. Щоб розібратися, написав парсер PDC на Kaitai Struct 🏗, а також посидів в ImHex. ШІ-шка мені нагенерила переглядач під бравзер. Скрипт урешті викинув — довелося написати власний. Самі анімації зробив у Figma покадрово й екпортнув кожний кадр як SVG. Прогнав скриптом — ніби норм.

При публікації ще виявилося, що екран годинника зʼїдає кропаль пікселів на краях, тому додав відступ і переробив лейаут. Загалом задоволений: SDK доволі простий і прикольний, сішку не люблю, хоча цього разу зайшло норм, емулятор зручний, результат подобається.

Тепер справа за вами! Якщо не западло, підіть накидайте мені лайків ❤️ там — дуже хочеться виграти собі годинник на дурняк 😂
  • 🔥 19
  • 👍 4
  • 😁 2
Older posts →
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →