TGViewer
Channel Public Channel
Complete AI

Complete AI

@complete_ai

Меня зовут Андрей Кузнецов

Руковожу управлением в Sber AI, построил успешную лабораторию FusionBrain в AIRI, один из основателей Kandinsky, к.т.н., 15+ лет опыта в Computer Vision, выступаю с лекциями и пишу о событиях в AI и ML
Subscribers
7.86K
Photos
517
Videos
38
Links
288

Showing posts older than #635 · Back to latest

Older Posts 19 shown
Post #633 3.25K

Forwarded from Институт AIRI

Отметили четырёхлетие Института!

Все сердца AIRI сегодня — для вас ❤️
  • ❤‍🔥 52
  • ❤ 19
  • 🔥 13
  • 👏 6
Post #632 4.7K
В ожидании новой модели синтеза видео…

Поделюсь новостями, как выйдет подробная информация📝
  • 👍 16
  • 👀 5
  • 😎 1
Post #631 4.18K
Не участвовал в разработке Llama 4 — можно рассмотреть резюме😅

Спасибо @data_secrets за весёлый инсайт
  • 😁 50
  • 🌚 6
  • 😱 1
Post #630 4.01K
Продолжаем тренд. Теперь делаем анимацию😉

Промпт для Image2Video (Kling 1.6) в комментариях👇
  • 🔥 38
  • ❤ 9
  • 👍 3
  • 🤔 1
  • 💯 1
  • 🏆 1
Post #629 3.35K
Все в тренде, а я чем хуже😅

Промпт в подарок в комментариях 👇
  • 🔥 54
  • 😁 10
  • 🌚 4
  • 👍 3
  • 🏆 2
  • 🙊 2
Post #628 3.28K
Очень люблю разные визуализации риалтайм событий. Раньше в Самарском универе делали онлайн карту движения гор транспорта на модном тогда HTML5, когда Яндекс.Транспорта ещё не существовало. Тогда же появилось приложение мобильное "Прибывалка-63" и онлайн можно было посмотреть каждый автобус, трамвай и троллейбус (это к слову были 2012-2013 г.г.!). А в конце января 2025-го пришли какие-то персоны из деп транспорта и под какими-то не особо обоснованными предлогами доступ к данным закрыли и сервис с приложением перестали радовать жителей Самары...
"Мы никому не скажем, когда займёмся оптимизацией, но знаки будут")

А вспомнил я про это потому, что недавно набрёл на live карту Лондонского метро, и ностальгия посетила 👇
https://www.londonunderground.live/
  • ❤ 19
  • 🔥 5
  • 😱 4
  • 👀 2
Post #627 3.33K

Forwarded from Valuable AI / Валентин Малых

до меня долетела статья с Хабра про то, как человек тестирует LLM на общении в Тиндере на предмет того, как быстро собеседник поймет, что с ним разговаривает бот; при этом, по всей видимости этот гражданин не знает о существовании теста Тьюринга

я конечно несколько опешил от такого невежества, но с другой стороны это дало мне повод написать про свежую статью, в которой были протестированы GPT-4.5 и LLaMa 3.1 как раз в контексте теста Тьюринга; результаты представлены на картинке к посту; из интересного, ELIZA оказалась по этому тесту лучше GPT-4o; кому интересно, я про нее недавно писал

второй факт, который на мой взгляд резко переносит нас из точки "настоящее" в точку "будущее" - это 73% побед для GPT-4.5; это означает, что уже сейчас есть ИИ, который в разговоре в 3 из 4 случаев не отличить от человека; эра беспрецедентного телефонного мошенничества не за горами, а буквально уже наступила; такие дела


P.S. забавный факт, в той хабростатье тоже неожиданно лучше всех оказалась GPT-4.5; ссылка на Хабр
  • 👍 10
  • ❤‍🔥 7
  • 🔥 3
  • 😱 2
  • 🏆 1
Post #623 3.49K

Forwarded from Институт AIRI

Как удаление знаков препинания и артиклей в запросе снижает точность языковых моделей до 20%⤵️

Исследователи AIRI обнаружили, что знаки препинания и артикли играют более важную роль в обработке информации языковыми моделями, чем кажется на первый взгляд. Это удалось узнать с помощью метода, который позволяет определить, какие именно данные сохраняются в связке с конкретными токенами.

В серии экспериментов исследователи использовали тексты, из которых заранее убрали элементы, кажущиеся незначительными для логики повествования: знаки препинания, артикли и стоп-слова. Для этого систему обучили анализировать последовательность токенов и восстанавливать текст. Оказалось, что больше всего информации о контексте содержится именно в стоп-словах. Затем поставили перед несколькими популярными языковыми моделями задачу — решить, какие элементы текста, с точки зрения человека, можно удалить. Проверка подтвердила, что, если убрать из формулировки технического задания такие «незначительные» символы, качество работы модели падает.

📎Код для анализа работы языковых моделей доступен по ссылке.
  • ❤‍🔥 21
  • ⚡ 12
  • 🏆 6
  • 👍 4
  • 🤔 2
  • ❤ 1
Post #622 3.54K
Прошло уже больше 6 лет с последнего open source релиза LLM от Open AI (это была модель GPT-2 в феврале 2019), и вот Альтман говорит, что в ближайшее время планируется релиз новой открытой модели🙈 Верим?

https://techcrunch.com/2025/03/31/openai-plans-to-release-a-new-open-language-model-in-the-coming-months/
TechCrunch OpenAI plans to release a new 'open' AI language model in the coming months | TechCrunch OpenAI has announced that it intends to release its first 'open' language model since GPT‑2 sometime in 2025.
  • 😁 15
Post #620 3.65K
⚡️Всегда испытываю искреннюю радость за успехи ребят, с которыми удалось работать! Андрей пришел стажером ко мне в лабораторию в 2024 году по предложению @Ivan_Oseledets, занимался исследованиями мультимодальных архитектур, параллельно обучаясь и набираясь опыта, достигая успехов в исследованиях в AIRI и не только. А сегодня я горжусь его успехами и рад, что имею возможность работать с такими талантливыми ребятами🙏
  • 🔥 58
  • 🆒 7
  • 👏 5
  • ❤ 3
  • 🏆 3
Post #619 4.46K
⚡️Наша новая статья про прунинг визуальных энкодеров в мультимодальных моделях «When Less is Enough: Adaptive Token Reduction for Efficient Image Representation» снова борется за звание Paper of the day на Hugging Face

Особенность исследования в том, что от 30 до 50% визуальных фичей можно исключить из контекста мультимодальной модели при незначительном проседании в качестве на бенчах. Очень интересный результат, который мы продолжаем проверять на различных задачах - несёт пользу для экономии длины контекста мультимодальных моделей

Немного не хватает до первого места) Будем очень рады и благодарны вашим апвоутам 🔝

https://huggingface.co/papers/2503.16660
huggingface.co Paper page - When Less is Enough: Adaptive Token Reduction for Efficient Image Representation Join the discussion on this paper page
  • 🔥 30
  • 👍 10
  • ❤ 4
  • 🏆 2
Post #618 3.39K

Forwarded from AbstractDL

M-Attack: как обмануть GPT-4.5 и Gemini

Все привыкли, что атаковать современные мультимодальные модели (типа GPT-4o, Claude, Gemini и т.п.) крайне сложно — особенно, если это black-box модели, где нет доступа к градиентам и архитектуре. Стандартные подходы атак типа "выдать одну картинку за другую" часто генерируют какие-то невнятные шумы, которые либо игнорируются моделью, либо приводят к абстрактным ответам типа "размытое изображение".

Но оказалось, что проблема была не в самих моделях, а в подходе к генерации возмущений. В свежей статье предложили очень простой, но мощный подход — M-Attack:
1. Берём исходную и целевую картинки.
2. На каждом шаге рандомно crop'аем кусок исходного изображения (50-100% площади) и затем ресайзим обратно до исходного размера.
3. Заставляем эмбеддинги этого кусочка максимально приблизиться к эмбеддингам целевого изображения оптимизируясь в white-box режиме по ансамблю открытых визуальных моделей (например, CLIP, ViT и тп).

И всё! После нескольких итераций в центральной области картинки "проявляется" целевая семантика, при этом возмущения выглядят крайне незаметно и аккуратно (в отличие от других подходов).

Авторы добились совершенно впечатляющих результатов: успех атаки (ASR) превышает 90% (!) для GPT-4.5, GPT-4o и даже для o1 и Gemini. Код и датасет из 100 атакованных картинок выложили в открытый доступ.

Статья, GitHub, dataset
  • 👍 30
  • 🔥 16
  • ❤ 5
  • 😁 2
Post #617 3.68K
На прошлой неделе вышло моё небольшое интервью для @snobru на тему технологической гонки в ИИ в мире. Обсуждали глобальные вызовы, подходы к развитию ИИ в США, Европе и Азии.

Подробнее можно посмотреть по ссылке
  • ❤‍🔥 22
  • ⚡ 11
  • 👍 8
  • 🏆 3
  • 🔥 1
Post #616 5.05K
🎉Всех женщин и девушек, читающих этот канал, сердечно поздравляю с Международным женским днём!

Прекрасно понимаю, что среди читателей представительницы совершенно разных профессий: учёные, преподаватели, студенты, менеджеры, маркетологи, дизайнеры и многие другие. И в каждом деле, в каждой профессии, в доме и в семье вы приносите душевность, нежность, вдохновение и заряжаете окружающих вас мужчин огромным зарядом энергии, оптимизма и стремления совершать открытия💐 Спасибо вам за то, что вы есть каждый день! Мы вам очень-очень благодарны за это💐❤️
  • ❤ 49
  • ❤‍🔥 13
  • 🔥 12
  • 🦄 9
  • 😁 1
  • 🤔 1
Post #615 3.89K

Forwarded from Институт AIRI

На связи #AIRI_Seminars, рассказываем про следующий семинар, который пройдет 12 марта⤵

Руководитель группы компьютерного зрения MTS AI представит доклад на тему «Обучение штраф разреженности с помощью неявного дифференцирования для робастной оценки и регуляризации изображений». Оппонентом выступит кандидат технических наук, директор лаборатории FusionBrain AIRI Андрей Кузнецов.

Семинар пройдет на английском языке. Подробное описание и регистрация на офлайн-формат с пиццей и нетворкингом по ссылке.

Трансляции: VK Видео и YouTube📌
  • ❤ 17
  • 🔥 14
  • 👍 6
  • 💯 2
Post #614 3.93K
Kandinsky в платёжных терминалах по всей стране готовится поздравлять всех женщин и девушек 💐
  • ❤‍🔥 50
  • 🔥 20
  • ⚡ 6
  • ❤ 2
  • 😱 2
  • 🎉 1
  • 🌚 1
  • 👾 1
Post #613 3.26K

Forwarded from RnD ML Team

🙋‍♀️ Всем привет! В предыдущем посте мы уже рассказывали, как наш датасет EasyPortrait помог коллегам при создании модели GHOST 2.0.

⚡️ А на прошлой неделе наша команда приезжала в Португалию на конференцию VISIGRAPP '25, где представляла статью EasyPortrait — Face Parsing and Portrait Segmentation Dataset.

🚀 Конференция прошла 26-28 февраля в городе Порту, и за 3 дня на ней было представлено больше 200 статей. На конференции мы услышали обратную связь от сообщества, пообщались с коллегами из других стран, а также послушали множество докладов других участников.

📖 ArXiv: https://arxiv.org/abs/2304.13509
👩‍💻 GitHub: https://github.com/hukenovs/easyportrait
🔑 kaggle: https://www.kaggle.com/datasets/kapitanov/easyportrait

#news
  • 🔥 13
  • ❤‍🔥 10
  • ⚡ 4
  • ❤ 1
Post #611 3.65K
Complete AI ⚡️⚡️⚡️Первая open-source модель переноса головы на фото — GHOST 2.0 Сегодня мы выпустили первую модель для переноса головы на фото с открытым кодом — GHOST 2.0. Модель продолжает наследие семейства моделей переноса лиц на фото и видео (GHOST). Архитектура…
🎉
  • 🏆 38
  • 🔥 4
  • ❤ 1
  • 🤔 1
Post #609 11.9K
⚡️⚡️⚡️Первая open-source модель переноса головы на фото — GHOST 2.0

Сегодня мы выпустили первую модель для переноса головы на фото с открытым кодом — GHOST 2.0. Модель продолжает наследие семейства моделей переноса лиц на фото и видео (GHOST).

Архитектура GHOST 2.0 модели включает две составляющих:
🟢 Aligner для реконструкции положения головы и трансфера выражения лица с головы-источника
🟢 Blender позволяет "встроить" голову в целевую картинку с сохранение свойств окружения (чтобы освещение и контраст совпадали, а также дорисовались области-лакуны, которые возникли при переносе)

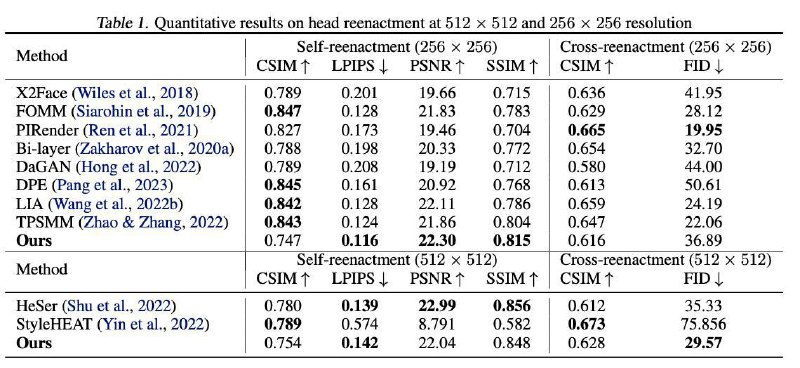
Самое интересное, что в open source таких моделей по сути нет и самый ближайший аналог — это модель HeSer 2022 года, которую по метрикам удалось обойти. Также мы проделали большой объём работы, исследуя механизмы блендинга и аугментации данных при обучении, чтобы постараться учесть сложные кейсы, когда голова-источник отличается от области встраивания по форме, положению, причёске и т.д. Подробно про эти эксперименты можно почитать в детальном тех репорте.

Внизу по ссылочке можно поиграть с демкой, почитать Хабр и собственно развернуть у себя код, чтобы изучить "нутро" модели. В ближайшее время обновим TG бот, и я отдельно оповещу об этом)

⚡️По сложившейся традиции все наши статьи стараемся номинировать на Paper of the day на Hugging Face — буду очень рад вашим Upvote голосам👇
https://huggingface.co/papers/2502.18417

Полезные ссылки:
👉 ArXiv: https://arxiv.org/abs/2502.18417
👉 Хабр: https://habr.com/ru/companies/sberbank/articles/884780/
👉 Project page: https://ai-forever.github.io/ghost-2.0/

@complete_ai
  • 🔥 28
  • 💯 7
  • 🏆 6
  • 👏 1
  • 🌚 1
Older posts →
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →