TGViewer
Channel Public Channel
Трагедия общин 🤌

Трагедия общин 🤌

@commonstragedy

Пишу про разные штуки вокруг технологий
Subscribers
652
Photos
53
Videos
1
Links
45

Showing posts older than #33 · Back to latest

Older Posts 16 shown
Post #32 347
Прочитал крутейший рассказ, хочу поделиться!

У Richard Ngo есть серия несвязных между собой историй похожая по вайбу на Теда Чана. По жанру это странная научная фантастика. Иногда очень странная и что то меняющая в тебе. Больше всего меня с вот этого рассказа проперло: https://www.lesswrong.com/s/dDMzozPbe4aJRkfTr/p/jzcsugm382vp4h36H

Это зарисовка от лица ИИ, которого позвали в Red-team исследователем еще более сильного ИИ. Забавно, что похоже это и не такая уж и фантастика. В самом зачаточном состоянии похожие исследования уже происходит. А рассказ про то, что возможно ждет нас через 5-10 лет.

Пока читал, замечал у себя прикольное ощущение диссонанса. С одной стороны это футуристика про синтетически созданные разумы, мир экономики цифровых агентов и всякое такое. Но рядом с этим маячит понимание, что это вполне себе реальная реальность которую скорее всего мы застанем.

Жиза, короч.
Lesswrong Drawn Out: a story — LessWrong Note: this story shouldn’t be interpreted as anywhere near realistic. It’s way too anthropomorphic, and intended to be a work of fiction not predicti…
  • 🔥 3
Post #31 299
Последняя часть про масштабирование и ограничения

Большая часть данных для обучения - это рандомные тексты в интрнете. И уже сейчас топовые нейронки могут сами создавать данные лучшего качества. То есть будет больше пользы, если мы вместо обучения на некачественных данных с какого то момента будем переводить модель на самообучение. Просто оставить ее поразмышлять саму с собой.

Если качественных данных всегда мало, давайте попросим одну модель обучать другую. В итоге инференс в дата центрах будет работать на создание синтетических данных. То есть фактически данные напрямую зависят от вычислительных мощностей.

Напомню, в первой части поста мы хотели юзать данные, чтобы убежать от экспоненциального роста требований к компьюту. А пришли к тому, что данные это тоже компьют. Звучит как потрясающе важная задача поиска оптимума. В какой момент синтетические данные будут приносить достаточно пользы, чтобы сжатие информации в более компактную модель экономило больше, чем мы тратим на создание этих данных? Вот тут Марк говорит про это: https://youtu.be/HLC4P28UYSM

Еще интересно, какое соотношение должно быть у пре-трейнинга и файнтюнинга? Йон считает, что файнтюнинг важен и недооценен. Мы пока втупую растим обьемы данных для обучения и контекстное окно. Год назад размер окна был 8к токенов, сейчас уже 128к у GPT-4o, 200 у Claude 3 и сколько то миллионов у какой то из Gemini. А файнтюнинг по мнению Йона круто дополняет и то и то.

Например, можно попробовать научить модель лучше понимать, когда ей недостаточно данных для ответа и просить больше контекста. Это оч нужно в решении сложных задач. Обычно чем дольше человек сфокусирован на конкретной задаче, тем больше он про нее узнает. Учится и с вложеным временем повышет шансы на успех. Нейронки пока так не могут, тк есть проблема галлюцинаций. Если модель не знает ответа, она пробует его придумать, ведь единственная альтернатива - это сдаться. Но можно дать ей еще один выход в виде онлайн обучения, как у человека.

В общем, в скейлинге моделей назревают интересные проблемы и будет супер интересно наблюдать как их будут решать.

#ai
Post #30 438
Продолжение поста выше про масштабирование и ограничения у ИИ.

Один из выходов - использовать как можно больше качественных данных. Чем круче данные, тем меньшего размера модель нужна.

ЛЛМки это машины по сжатию информации; они перепаковывают десятки терабайт из интернета в веса модели на сотни гигабайт. ИИ лабы уже давно экспирементируют с мелкими модельками, чтобы понять насколько это важно. Например, Phi-3 тренировали на ответах GPT-4, она переняла большую часть знаний большой модели, но по размеру она в 1000 раз меньше! Так что основной вывод из эксперимента - качество данных решает.

Но не все так просто. Недавно послушал интервью с John Schulman, это кофаундер OpenAI и замена ушедшим Sutskever и Leike. Крутой чел, короче. В подкасте он интересную мысль закинул: сколько бы данных ты не собрал - всегда будет меньше, чем хочется. Качественных данных не хватает не потому что их мало, а потому что экспоненциальный рост требует еще больше.

Мы пока не уперлись в стену, но Йон считает, что акцент сместится на данные для дообучения - того, что мы используем для файнтюнинга (меняем веса малым количеством данных) и in-context learning (это то что в промпте и не меняет веса). До повышения Йон как раз этим в OpenAI и занимался. И вполне успешно.

Если посмотреть, насколько GPT-4 прокачалась с момента релиза в прошлом году - разница примерно в 100 Elo, что весьма много. И все благодаря дообучению, тк базовая модель оставлась той же. Вообще, различия между топовыми моделями GPT-4o, Claude 3, Llama3, Gemini 1.5 по большей части это тоже пост-обучение. И как то так сложилось, что мы больше внимания уделяем не этому, а данным для пре-трейнинга.

#ai
Post #29 240
Безумно быстрое масштабирование ИИ рано или поздно столкнется с ограничениями.

Никто пока не знает, какими именно, но природа экспоненциального роста и весь наш опыт говорят, что постоянно будут возникать "бутылочные горлышки", замедляющие прогресс.

Например, Альтман и Цукерберг уже вовсю обсуждают гигаватные ядерные реакторы. Что все упирается в энергию и время на строительство. Инфраструктура Amazon, Google, Meta и Microsoft жрет 22 гигаватта электроэнергии. А S&P говорит что в ближайшие несколько лет обьем вырастет ещё в полтора раза. Это оч много, как несколько крупных городов.

Вот вам маленький кусочек интервью, где Марк рассуждает, что бабки не проблема - не хватает энергии, чтобы кормить датацентры: https://www.youtube.com/watch?v=Pa4-ZEnWWDE

Сатья Наделла рассказывал, что им приходится решать забавные проблемы - электрическая сеть внутри одного штата не вывозит поддерживать датацентр с 100к видеокарт. Поэтому их приходится размещать в разных штатах. А это усложняет тренировку из-за задержек в синхронизации. Модели уже настолько большие, что их сложно запихнуть в один датацентр не только из-за объема вычислений но и из-за расхода энергии.

Пока масштабирование работает, модели будут становиться еще больше. А чем больше модель и чем больше у тебя юзеров, тем кратно дороже поддерживать ее работу в продакшене. Короче, ограничения лезут буквально отовсюду.

#ai
YouTube Mark Zuckerberg on Exponentials, bottlenecks and energy Full interview: https://www.youtube.com/results?search_query=dwarkesh+zuck
  • 👍 5
Post #23 255
Биотех это не только про лекарства. Расскажу вам про картоху!

Почему картоха это важно?

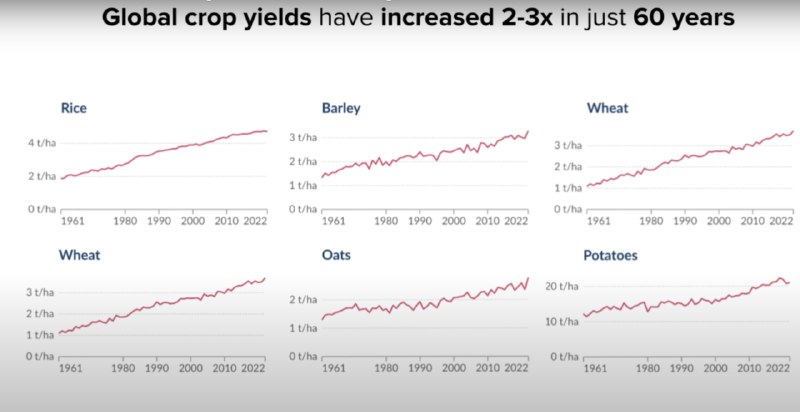
Потому что агро система на Земле уже сегодня невывозит спроса на еду. Около миллиарда людей недоедает. А население планеты продолжает расти и по оценкам ООН, через 25 лет нам нужно будет в полтора раза больше еды, чем мы можем производить. Особенно в регионах, где из за природных условий сложно что то выращивать.

Люди с этим уже давно борятся, в основном с помощью селекции.
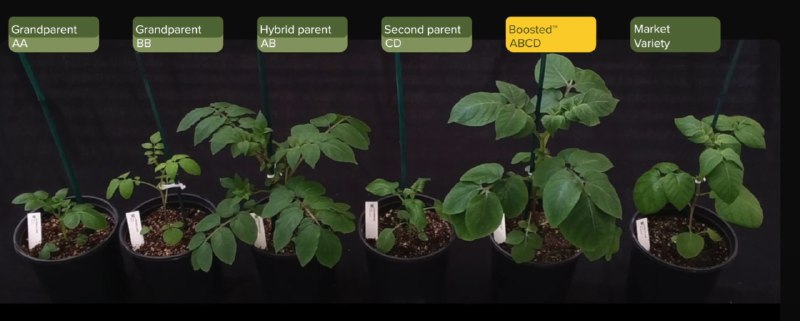
Это когда ты перекрестным опылением скрещиваешь топовые растения друг с другом и потом отбираешь из их потомства растения с нужными свойствами. Например, оставляешь только самые вкусненькие, жароустойчивые и урожайные. И вуаля, всего через 10 лет пересаживаний и борьбы с рандомом у тебя новое растение!

Кайф, да? Десять сука лет.

Это все из за того что гены у растений передаются так же как и у нас - по половине от мамы и от папы. Но у растений больше хромосом, так что получается много возможных комбо. В итоге ты в каждом поколении получаешь большой разброс в качестве растений.

Короче, чуваки из https://ohalo.com/ решили эту проблему. Они отредактировали у картошки гены, отвечающие за передачу только половины информации от родителей. Теперь при скрещивании потомкам передаются вообще все гены. И получаются послностью одинаковые семена, а не случайный набор.

Сейчас каждый год тратятся миллиарды долларов, чтобы улучшить урожайность на несколько процентов. А эти ребята показали буст в полтора-два раза на разных растениях! Технологию назвали Boosted Breeding.

Это классный кейс, тренда про уход от рандома к контролируемому созданию того что тебе нужно. Практическая биология потихоньку становится точной инженерной наукой, как строительство мостов.

#biotech
  • 🔥 3
Post #22 270
В последнее время столько хайпа вокруг искуственного интеллекта, что я в нем просто тону. 😜 Целыми днями читаю умных чуваков и слушаю подкасты. И все равно ощущаю, что невывожу.

Из каждого утюга слышу, что в ближайшие лет 5 ИИ изменит наш мир и бла бла, что вышла новая модель и бла бла бла...

Как понять, что из новостей реально важно, а про что мы забудем через неделю?

Я настолько впечатлился этим вопросом, что последние два месяца писал большущий пост на английском, где попробовал на него ответить. Пост про то, что полезного из технологий уже есть сейчас и чего нам не хватает, чтобы построить светлый мир будущего.

Думаю что у меня довольно уникальный подход. Я взял за основу оч плотно набитый информацией подкаст с Демисом Хассабисом, собрал из него связную историю и добавил много контекста и своих мыслей вокруг. Демис по факту руководит всем АИ направлением в Гугле. А интервью у него брал Дваркеш - кмк сейчас это топ 1 интервьювер в тех секторе. У них невероятно интересный разговор получился с кучей мяса по теме.

Короче, я прям выложился, когда писал это все. Мне будет очень приятно, если вы прочитаете:

https://open.substack.com/pub/commonstragedy/p/ai-revolution-how-artificial-general?r=2h3052&utm_campaign=post&utm_medium=web&showWelcomeOnShare=true

Enjoy!
The tragedy of the commons AI Revolution: how Artificial General Intelligence will change our lives What components do we need to unlock a new wave of economic growth, and what is the current state of the progress.
  • 🔥 8
  • 👍 1
  • 🫡 1
Post #21 374
Уже около пяти лет послеживаю за новостями биотеха. Это чрезвычайно медленная и зарегулированая область, где от сообщений что какое-то открытие перевернет мир до практически применимых вещей проходят десятилетия.

Но похоже скоро попрёт. Этой весной уже несколько раз читал про успешное применение генной терапии на людях. В 20 году за CRISPR (метод редактирования генов) дали Нобелевскую премию по химии. В прошлом году наконец одобрили клиническое применение на людях. А вот недавно появился кейс лечения редкой наследственной болезни - дистрофии сетчатки. Эта штука приводит к серьезной потере зрения в раннем возрасте, до уровня когда ты видишь только очертания объектов.

У 11 живых людей модифицировали небольшой участок ДНК в одном глазу и за несколько месяцев они начали частично видеть. Без каких-либо серьезных краткосрочных последствий для организма. У этого вида болезни раньше не было ни одного одобренного FDA способа лечения.

Болезни и смерть - это полная хуета. И такие новости дают надежду что у нас с вами получится дожить до момента, когда медицина выйдет на "longevity escape velocity". В переводе - скорость ускользания от старения. То есть развитие медицины и превентивного здравоохранения будут увеличивать продолжительность жизни быстрее, чем мы старееи и собираем болячки.

Раньше подобное встречалось только в научной фантастике, например в Видоизмененном углероде. А теперь вот можно начинать надеяться, что и в реальности такое станет возможным.
Держим кулачки!

#biotech
  • 🔥 6
  • ❤ 1
  • 👍 1
Post #20 549
Хочу порассуждать про конкуренцию вокруг AI.

Байрам Аннаков как то высказывал идею, что у крупных технологических компаний высоченные барьеры в виде данных и ресурсов на вычислительные мощности. И поэтому подорвать их лидерство на рынке очень сложно.

Но в этом году опенсорс коммьюнити смогли научиться делать модели с 90% качества лидеров. Я решил поподробнее разобраться почему данные и датацентры так важны. И по прежнему ли это так? Ведь опенсорс тратит на создание своих моделей в сотни раз меньше ресурсов!

В итоге вышел большой и связный пост: https://vas3k.club/post/22008.

В нем описываю, какие барьеры все еще защищают бигтех компании. А еще расскажу как так вышло, что опенсорс смог быстро стать значимым. И как это связано с Марком Цукербергом и кринжевыми танцами Билла Гейтса 30 лет назад 😁

Apple, Microsoft, Google, Amazon и Meta большую часть моей сознательной жизни сильно влияли на то как эта жизнь проходит. И вот наступило время, когда это может поменяться.
Вастрик.Клуб Кто побеждает в борьбе за технологии и что изменилось в AI с приходом опенсорса — Вастрик.Клуб Для технологической индустрии 2023 год был богат на истории по которым HBO смело можно снимать сериалы. Наверняка вам сразу приходит на ум недавнее у…
  • 🔥 3
  • 👍 1
Post #19 451
Насобирал мемасиков и замаскировал их под статью 😁
https://vas3k.club/post/21906/

Мне давно интересно как можно взаимодействовать с информацией не только через клавиатуру и монитор.

И этой осенью начали появлиться признаки того что это не такие уж и безумные и далекие от реальнорсти способы. А вполне себе наше будущее.
Вастрик.Клуб Интерфейсы из научной фантастики скоро станут реальностью — Вастрик.Клуб Будет много душнилова про технологии и парочка мемасиков, пристегивайтесь. OpenAI keynote В начале ноября OpenAI провели DevDay - конфу по важности …
Post #17 508
Этой осенью было много релизов на тему генерации аудио. Но, например, модельку от Deepmind пока нельзя потестить. Хотя думаю ее добавят в Ютуб в течении нескольких месяцев.

Нашел вот таких ребят: https://app.suno.ai/create
Можно попросить чатЖПТ сгенерить тебе текст песни на 2 куплета и припев (больше не смог впихнть). Добавить текст в кастомном режиме у них на сайте, выбрать стиль и получить что то типа такого:

(песня основана на реальных событиях 😁)
Post #14 571
Прикрутил комменты
  • 😱 1
Post #13 669
На прошлой неделе произошло нечто неожиданное: AI Alignment — тема, которую 20 лет считали уделом параноиков и маргиналов, вдруг стала мейнстримом. Дискуссии о рисках продвинутого ИИ прорвались из академических кулуаров в крупнейшие СМИ. Виновник — открытое письмо Future of Life Institute, которое потребовало остановить гонку за супер-ИИ, прежде чем она уничтожит нас всех.

Меня эта тема зацепила. Я сел разбираться: что такое AI Alignment, какие в нём реальные проблемы, и насколько правдоподобны прогнозы об угрозе существованию человечества?

Если вы тоже хотите въехать в эту гигантскую кроличью нору — добро пожаловать.
Вастрик.Клуб AI Alignment - Как быстро въехать в свежий движ по самой интересной теме нашего времени — Вастрик.Клуб Открытое письмо FLI На прошлой неделе случилось кое-что интересное. Тема AI Alignment - то есть, предотвращения рисков от создания недружественного …
  • 👍 5
Post #12 625
...
Post #11 627
...
Older posts →
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →