TGViewer
Channel Public Channel
BRAIn Lab: Optimization and Beyond

BRAIn Lab: Optimization and Beyond

@brainlaboratory

Канал лаборатории фундаментальных исследований ИИ.
В фокусе: оптимизация в ML, GenAI, математика ИИ, ИИ для науки, федеративное обучение.
Научный руководитель: Александр Безносиков @abeznosikov
Subscribers
1.16K
Photos
261
Videos
8
Links
78

Showing posts older than #240 · Back to latest

Older Posts 7 shown
Post #238 1.43K
Приглашаем на семинар: «Глобальный иерархический оптимизационный алгоритм для задач назначения большой размерности»

🎙 Докладчик: Максим Гончаров, Руководитель направления прогнозной аналитики и оптимизации, Axenix

📍 Где и когда:
Пятница, 26 июня, 16:00 МСК

О чём пойдёт речь?
🔵Многие реальные задачи назначения настолько велики, что их невозможно решить «в лоб». Солвер либо работает неприемлемо долго, либо упирается в ограничения памяти, либо теряется в бесконечном переборе вариантов.
🔵Кажется очевидным разбить такую задачу на части и решать по отдельности. Но тут возникает новая проблема. Независимые решения отдельных блоков часто оказываются либо несогласованными между собой, либо заметно хуже глобального оптимума.
🔵На семинаре мы обсудим подход для задач с иерархической структурой, который позволяет одновременно масштабироваться на большие размерности и сохранять качество решения.


На семинаре разберём:
🔵Почему классические методы перестают работать на задачах большой размерности;
🔵Какие проблемы возникают при наивной декомпозиции на подзадачи;
🔵Как организовать итеративное согласование между блоками, чтобы учитывать межблочные связи;
🔵Почему такой подход позволяет получать решения, близкие к оптимальным, без необходимости решать всю задачу целиком


📆 Добавить семинар в ваш календарь
🔗 Ссылка на запись семинара

P. S. Если не сможете присутствовать — запись семинара появится на нашем Rutube-канале. А пока можно посмотреть предыдущие выпуски!
  • 🔥 8
  • ❤ 4
  • 👍 4
  • 🤯 2
Post #237 1.4K
🤗Приглашаем на совместный Reading Club c AI Talent Hub уже сегодня

Поговорим про оптимизаторы для эффективного обучения моделей — почему их выбор решает всё: скорость, память, качество. И что делать, когда GPU мало, а обучать надо.

🎤 Глеб Молодцов, сотрудник BRAIn Lab, проведёт нас через свежие статьи и поделится исследованием, которое прямо сейчас на ревью в EMNLP 👀

Презентация уже в комментариях ⬇️

Запись семинара

https://t.me/aitalenthubnews/2800
Telegram Al Talent Hub 🏖 Последний выпуск #ReadingClub: делаем pretraining LLM эффективнее и красиво уходим в закат на каникулы 🗓 15 июня в 19:00 Предобучение LLM всё ещё остается самой дорогой стадией: много GPU, много памяти, много времени — и очень высокая цена ошибки в выборе…
  • ❤ 7
  • 🔥 6
  • 👏 5
Post #228 1.2K
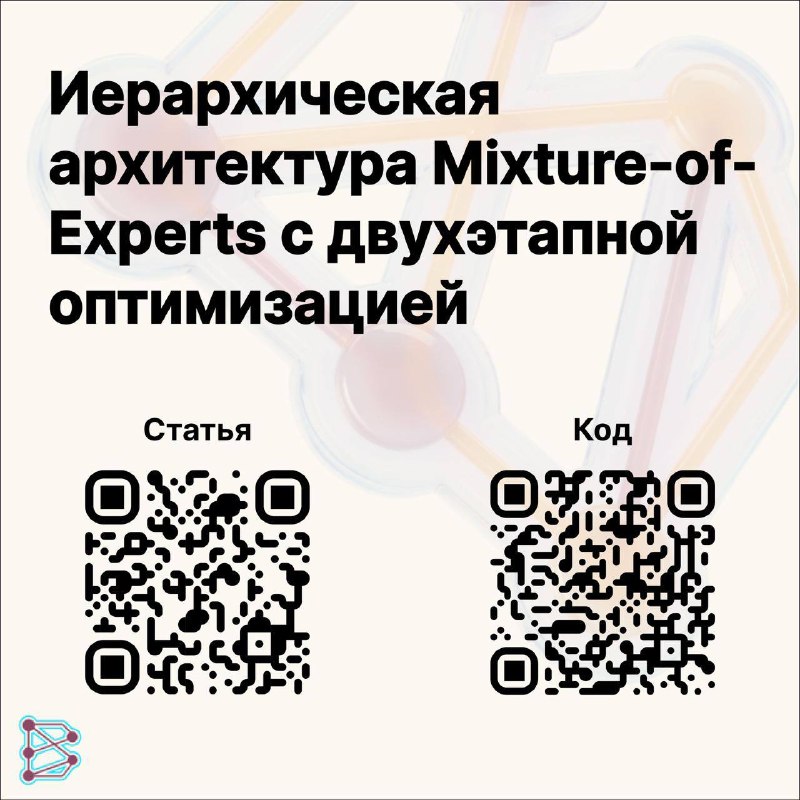
Разбираем нашу новую работу, принятую на KDD 2026 (и на воркшоп ICML!)

Hierarchical Mixture-of-Experts with Two-Stage Optimization

[статья]
[код]

В sparse MoE-моделях почти всегда возникает routing collapse: роутер начинает отправлять токены в одних и тех же экспертов.

Но проблема глубже, чем просто imbalance.

Современные grouped MoE обычно хорошо балансируют нагрузку между устройствами — но ценой снижения diversity. Эксперты начинают учиться похожим функциям, а разные группы становятся частично избыточными.

Получается фундаментальный trade-off:
⚖️ balance против specialization.

💡 Что мы предлагаем?

Hi-MoE разделяет routing optimization на два уровня.

🔵 Inter-group regularization: балансирует нагрузку между группами экспертов и GPU.
🔵 Intra-group regularization: снижает overlap между экспертами внутри группы и усиливает specialization.

Вместо одного balancing loss — иерархическая routing objective.

Мы показываем, что такая схема:
🔸уменьшает routing collapse
🔸снижает gradient coupling между экспертами
🔸увеличивает routing diversity
🔸и при этом сохраняет стабильную балансировку нагрузки

📊 Результаты:

🔵 nanoGPT-1B
PPL 2.947 vs 2.977 у MoGE
CV 0.23 vs 0.25

🔵OLMoE-7B на 58B токенов
−5.6% perplexity
−40% CV

🔵Swin-MoE 1B на Tiny ImageNet
Лучший Acc@1 и лучший CV среди baselines

Отдельно интересно, что группы экспертов начинают специализироваться на разных визуальных признаках: одни — на foreground-объектах, другие — на текстурах или частях тела.

Hi-MoE — это drop-in objective: метод встраивается в существующие top-k MoE без изменения inference pipeline.

👆 В карточках — почему balance и specialization конфликтуют в обычных MoE и как Hi-MoE разводит их на два уровня оптимизации

#разборстатьи@brainlaboratory
  • 🔥 10
  • ❤ 5
Post #227 995
Раз в полгода мы проводим внутреннюю встречу лаборатории. В фокусе - ключевые результаты: поездки на конференции, премии, завершенные исследования, презентации текущих проектов и направлений.

На встречи приглашаются студенты наших курсов. Для всех ребят это возможность пообщаться с командами лаборатории и определить подходящее направление для работы и коллабораций.

О том, как это было, и о масштабе нашей команды - в видео 🥹🫶
  • 🔥 22
  • ❤ 7
  • 🥰 2
Post #226 796
BRAIn Lab: Optimization and Beyond 🧠 Приглашаем на научный семинар BRAIn Lab 📅 9 июня в 12:00 (мск) | Онлайн Тема: Bridging the Attention Gap: Complete Replacement Models for Complete Circuit Tracing In mechanistic interpretability, existing sparse circuit tracing methods primarily focus…
⏰Напоминаем о семинаре, стартуем меньше, чем через час!

Материалы семинара доступны в комментариях.
  • ❤ 2
Post #224 1.4K
🧠 Приглашаем на научный семинар BRAIn Lab

📅 9 июня в 12:00 (мск) | Онлайн

Тема: Bridging the Attention Gap: Complete Replacement Models for Complete Circuit Tracing

In mechanistic interpretability, existing sparse circuit tracing methods primarily focus on decomposing MLP activations, while treating attention patterns as fixed and uninterpretable components. In this talk, we discuss our method of Low-Rank Sparse Attention — Lorsa — and Complete Replacement Models — CRMs, which combine transcoders for MLPs with Lorsas for attention layers. This gives us an interpretable view for every computational block and the attribution graph for the entire model.


Спикер: Rui Lin — PhD student из Fudan University, сотрудник OpenMOSS

Исследователь в области интерпретируемости языковых моделей


Во второй части семинара спикер поделится последними результатами команды в области редактирования знаний мультимодальных моделей. После доклада к обсуждению также присоединятся Guancheng Zhou — PhD student из Xi'an Jiaotong University — и Wang Zhiwu — PhD student из Xi'an Jiaotong University.

📆 Добавить семинар в календарь
🔗 Ссылка для подключения
  • 🔥 9
  • ❤ 4
  • 👏 3
Post #218 1.01K
Об оптимизации и ИИ — интервью Александра Безносикова изданию «Коммерсантъ Наука» ⤵️

Один из самых молодых докторов наук в России, руководитель BRAIn Lab, Александр Безносиков рассказал о том, как устроена научная работа в сфере оптимизации и машинного обучения, зачем сегодня идти в науку, и чего там ожидать.

📎Читайте в карточках, а полную версию интервью по ссылке.
  • ❤ 19
  • 👍 10
  • 😁 2
  • ✍ 1
Older posts →
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →