TGViewer
Channel Public Channel
BRAIn Lab: Optimization and Beyond

BRAIn Lab: Optimization and Beyond

@brainlaboratory

Канал лаборатории фундаментальных исследований ИИ.
В фокусе: оптимизация в ML, GenAI, математика ИИ, ИИ для науки, федеративное обучение.
Научный руководитель: Александр Безносиков @abeznosikov
Subscribers
1.16K
Photos
261
Videos
8
Links
78

Showing posts older than #218 · Back to latest

Older Posts 7 shown
Post #216 923
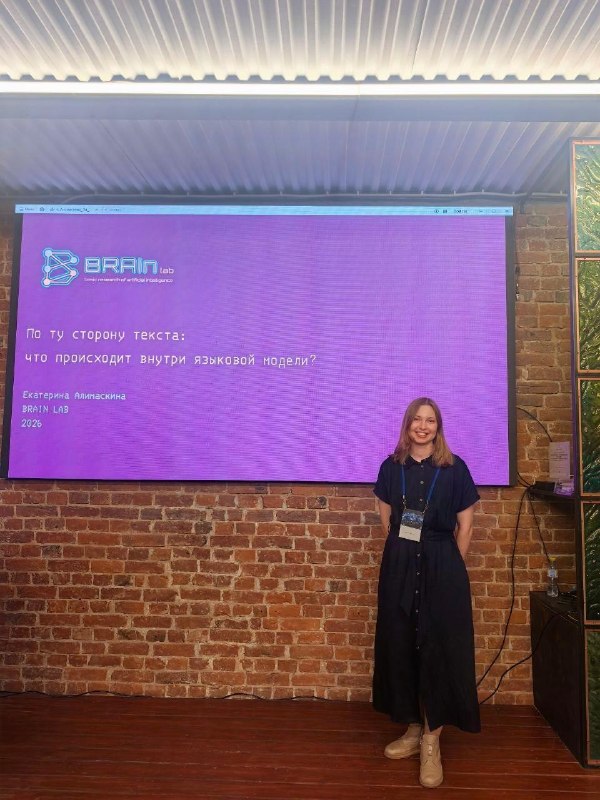
Всю прошлую неделю проходила конференция от ODS.ai — Data Fest 2026🚀

От нашей лаборатории в секции ALLMs выступила научная сотрудница Екатерина Алимаскина.

Тема доклада: «По ту сторону текста: что происходит внутри языковой модели?»

О чём говорили:
🌸 По финальному ответу не всегда понятно, что происходило внутри модели. Она может прийти к правильному ответу не тем путём, которым потом его объясняет, или звучать уверенно, хотя на самом деле достраивает правдоподобный, но неверный факт.
🌸 Обсудили, как исследователи пытаются заглянуть внутрь LLM: находить внутренние признаки, определять, какие из них влияют на ответ, и лучше понимать причины ошибок моделей.


❤️ Впечатления Екатерины:
Самым классным оказалось общение после выступления — было много заинтересованных вопросов и живых обсуждений. С некоторыми участниками дискуссия продолжилась уже онлайн, после конференции.

Спасибо всем докладчикам за интересные выступления, а участникам — за вопросы, идеи и интерес к теме!


❤️Рады быть частью сообщества и делиться своими результатами с коллегами.

Презентация Екатерины — в комментариях ⬇️
  • 🔥 29
  • ❤ 15
  • 🥰 2
  • 🏆 2
  • 🍌 1
  • 🍾 1
  • 💅 1
  • 💊 1
Post #215 862
BRAIn Lab: Optimization and Beyond 🧠 Приглашаем на научный семинар BRAIn Lab 📅 2 июня в 11:00 (мск) | Онлайн Тема: Learning-Based Algorithms for Solving Combinatorial Optimization This talk explores learning-based optimization paradigms that deeply integrates data, models, and algorithms…
Напоминаем о семинаре с приглашенным гостем, стартуем уже через два часа ⏰

Презентация с семинара уже в комментариях!
  • 😁 3
  • 👌 1
Post #214 988
Обзор конференции ICLR 2026 за одну минуту

Мы долго выбирали видео и фото с конференции, чтобы поделиться с вами атмосферой одной из лучших конференций по машинному обучению и искусственному интеллекту.

Ииии в первый день лета еще раз передаем приветы из солнечного Рио ☀️
  • 🔥 27
  • ❤ 16
  • 🥰 9
  • 😁 3
Post #210 1.5K
🧠 Приглашаем на научный семинар BRAIn Lab

📅 2 июня в 11:00 (мск) | Онлайн

Тема: Learning-Based Algorithms for Solving Combinatorial Optimization
This talk explores learning-based optimization paradigms that deeply integrates data, models, and algorithms for combinatorial optimization. For binary integer programming, a Monte Carlo policy gradient method is employed to achieve efficient sampling and search within the feasible region. For the quadratic assignment problem, an integrated framework of offline training and online fine-tuning is constructed, balancing solution accuracy and scalability. In complex constrained path planning and directed acyclic graph-based heterogeneous scheduling, lazy mask decoding and heuristic search are synergistically combined. Extensive experiments demonstrate that the learning-based algorithms exhibit significant advantages in solution quality, feasibility, and robustness.


Спикер: Zaiwen Wen — Boya Distinguished Professor в Пекинском университете (PKU)
Специалист в области алгоритмов оптимизации, машинного обучения и ИИ. Лауреат China Youth Science and Technology Award (2016), член редколлегий ведущих международных журналов, вице-президент Operations Research Society of China.


📆 Добавить семинар в ваш календарь
🔗 Ссылка для подключения
  • 🔥 15
  • 👍 2
  • 😁 1
Post #206 1.29K
🎤 Wildberries & Russ (RWB) провели Inside AI Meetup

От нашей лаборатории выступил Владимир Солодкин — ведущий исследователь Института ИИ МФТИ.
Тема: «Автоматическое дообучение гардрейлов»

О чём говорили:
• Гардрейлы (модели защиты) — важное дополнение к LLM для бизнеса. Они блокируют попытки извлечь запрещённую, конфиденциальную или некорректную информацию.
• Показали мультиагентное решение, которое в реальном времени анализирует новые способы атак (из научных статей, блогов и интернета) и автоматически дообучает модели защиты.
• Обсудили эволюционную модификацию не только гардрейлов, но и автоматическую генерацию новых типов атак — тоже через мультиагентную систему.


💬 Получили ценную обратную связь и много вопросов. Это подтверждает: безопасность ответов LLM остаётся ключевой задачей для всех сфер, где используют большие языковые модели.

🔬Кроме вопросов безопасности в нашей лаборатории продолжаются исследования различных аспектов использования и обучения LLM.

Презентация Владимира — в комментариях ⤵️
  • 🔥 15
  • ❤ 2
  • 😁 2
Post #203 1.35K
🎤Вчера участвовали в конференции Центрального Университета "Научный телеграф".

В секции "Математика: от абстракций к приложениям" студент бакалавриата Тимофей Белинский презентовал статью лаборатории, которая прошла на ICML:

"SoftSign: Smooth Sign in Your Optimizer For Better Parameter Heterogeneity Handling"


😇Тимофею плюсик за представление лаборатории в дружественном университете, где мы в прошлом году читали курс по оптимизации.

Как мы поняли, конференция проходит второй раз, выглядит очень стильно, как и сам университет.

Ну и, конечно, как мы знаем, путь к A⭐ тернист

Для студентов и начинающих ресерчеров такие конференции - классная возможность начать общаться с научным комьюнити и пробовать себя в публичных выступлениях!


Делимся презентацией Тимофея в комментариях ⤵️
  • 🔥 13
  • ❤ 9
  • 🥰 4
Post #194 1.21K
Возвращаемся с обещанным разбором статьи, принятой на ACL 2026!

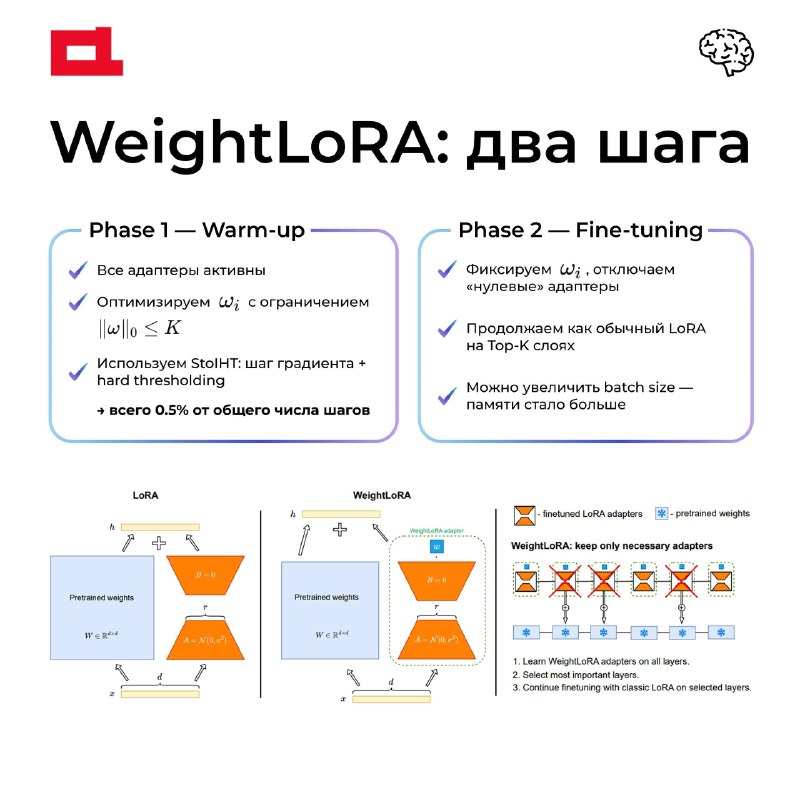
WeightLoRA: Keep Only Necessary Adapters

[статья]
[код]

Когда файн-тьюнишь LLM через LoRA, обычно делаешь примерно так: выбираешь слои, ставишь адаптеры на все из них и тренируешь. Логика понятна — чем больше параметров обновляешь, тем лучше.

Но есть нюанс.

Не все адаптеры одинаково нужны. Мы проверили на DeBERTa: из 36 адаптеров на self-attention слоях вклад у них в лосс очень разный. Часть из них почти ничего не делает. Зачем тогда держать их в памяти и тратить на них градиенты?

💡 Что мы предлагаем?

К каждому LoRA-адаптеру добавляем скалярный вес ωᵢ. В самом начале обучения (≈ 0.5% числа итераций) оптимизируем эти веса при ограничении на ℓ₀-норму: оставляем только Top-K адаптеров, остальные зануляем. Потом выкидываем ненужные и дальше тренируем как обычный LoRA.

Всё. Никакой сложной архитектуры поверх.

WeightLoRA+
идет чуть дальше: вместо того чтобы просто выбрасывать адаптеры, удваиваем ранг у оставшихся. Бюджет параметров тот же, что у LoRA, но распределён по важным слоям, а не равномерно по всем.

📊 Цифры:

🔵WeightLoRA: в ~2 раза меньше обучаемых параметров, качество сопоставимо с LoRA
🔵WeightLoRA+: LoRA-бюджет, лучше результат
🔵Проверили на DeBERTa, Llama3-8B, Qwen3-8B, Llama3.1-70B, BART
🔵GLUE, GSM8K, HellaSwag, BoolQ, ARC-C, SQuAD, XSum...

Один паттерн, который проявляется стабильно: глубокие слои важнее, value-проекции выбираются чаще query и key. Это метод находит сам, без подсказок

Подписывайтесь @brainlaboratory

#разборстатьи@brainlaboratory
  • ❤ 17
  • 🔥 2
  • 👌 1
Older posts →
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →