
Возвращаемся с обещанным разбором статьи, принятой на ACL 2026!
WeightLoRA: Keep Only Necessary Adapters
[статья]
[код]
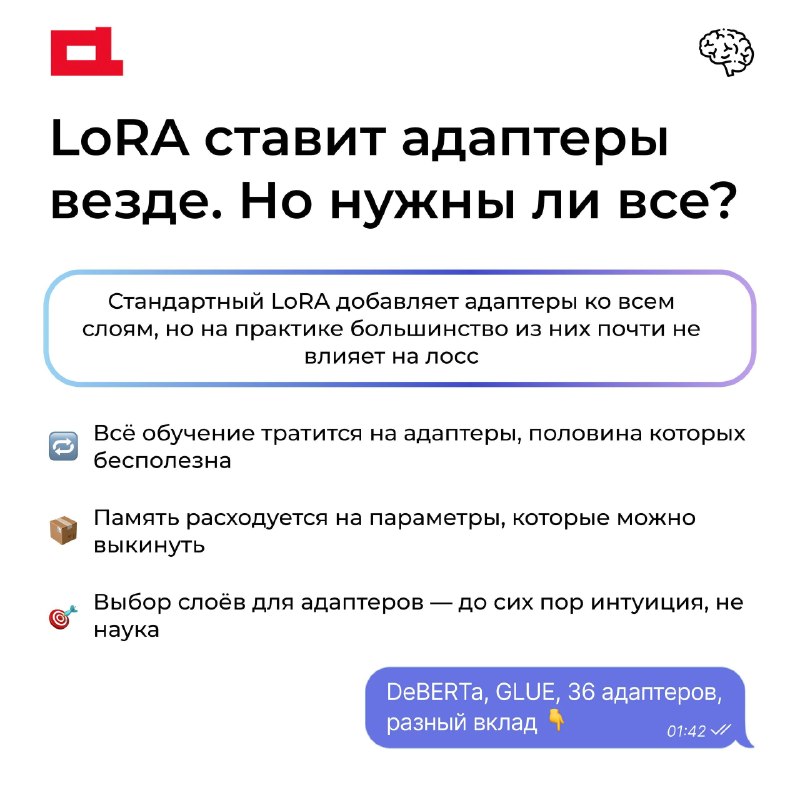
Когда файн-тьюнишь LLM через LoRA, обычно делаешь примерно так: выбираешь слои, ставишь адаптеры на все из них и тренируешь. Логика понятна — чем больше параметров обновляешь, тем лучше.
Но есть нюанс.
Не все адаптеры одинаково нужны. Мы проверили на DeBERTa: из 36 адаптеров на self-attention слоях вклад у них в лосс очень разный. Часть из них почти ничего не делает. Зачем тогда держать их в памяти и тратить на них градиенты?
💡 Что мы предлагаем?
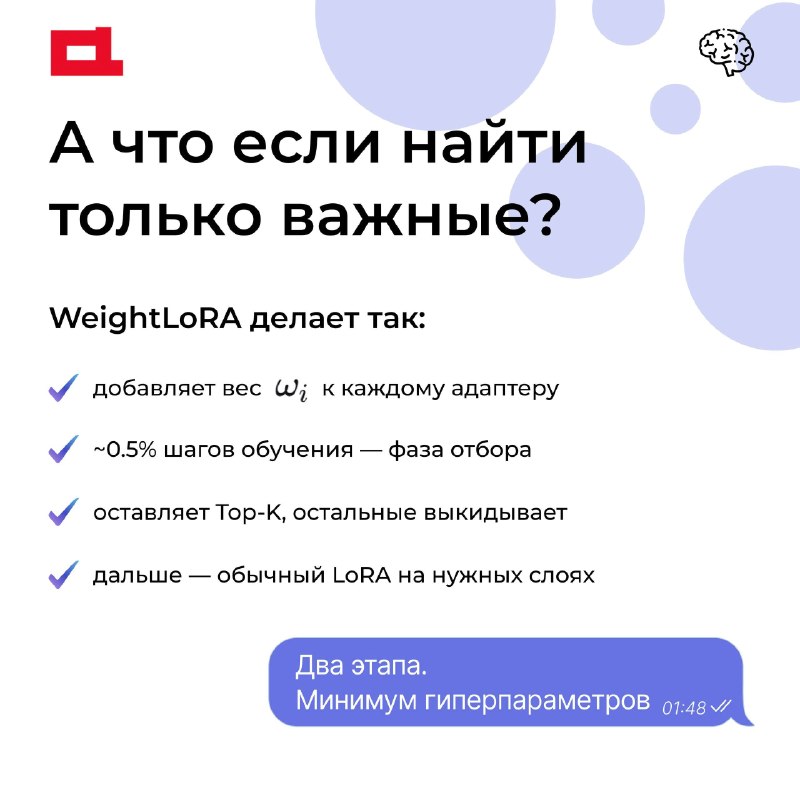
К каждому LoRA-адаптеру добавляем скалярный вес ωᵢ. В самом начале обучения (≈ 0.5% числа итераций) оптимизируем эти веса при ограничении на ℓ₀-норму: оставляем только Top-K адаптеров, остальные зануляем. Потом выкидываем ненужные и дальше тренируем как обычный LoRA.
Всё. Никакой сложной архитектуры поверх.
WeightLoRA+ идет чуть дальше: вместо того чтобы просто выбрасывать адаптеры, удваиваем ранг у оставшихся. Бюджет параметров тот же, что у LoRA, но распределён по важным слоям, а не равномерно по всем.
📊 Цифры:
🔵WeightLoRA: в ~2 раза меньше обучаемых параметров, качество сопоставимо с LoRA
🔵WeightLoRA+: LoRA-бюджет, лучше результат
🔵Проверили на DeBERTa, Llama3-8B, Qwen3-8B, Llama3.1-70B, BART
🔵GLUE, GSM8K, HellaSwag, BoolQ, ARC-C, SQuAD, XSum...
Один паттерн, который проявляется стабильно: глубокие слои важнее, value-проекции выбираются чаще query и key. Это метод находит сам, без подсказок
Подписывайтесь @brainlaboratory
#разборстатьи@brainlaboratory
Post #194
1.21K




- ❤ 17
- 🔥 2
- 👌 1