
Разбираем нашу новую работу, принятую на KDD 2026 (и на воркшоп ICML!)
Hierarchical Mixture-of-Experts with Two-Stage Optimization
[статья]
[код]
В sparse MoE-моделях почти всегда возникает routing collapse: роутер начинает отправлять токены в одних и тех же экспертов.
Но проблема глубже, чем просто imbalance.
Современные grouped MoE обычно хорошо балансируют нагрузку между устройствами — но ценой снижения diversity. Эксперты начинают учиться похожим функциям, а разные группы становятся частично избыточными.
Получается фундаментальный trade-off:
⚖️ balance против specialization.
💡 Что мы предлагаем?
Hi-MoE разделяет routing optimization на два уровня.
🔵 Inter-group regularization: балансирует нагрузку между группами экспертов и GPU.
🔵 Intra-group regularization: снижает overlap между экспертами внутри группы и усиливает specialization.
Вместо одного balancing loss — иерархическая routing objective.
Мы показываем, что такая схема:
🔸уменьшает routing collapse
🔸снижает gradient coupling между экспертами
🔸увеличивает routing diversity
🔸и при этом сохраняет стабильную балансировку нагрузки
📊 Результаты:
🔵 nanoGPT-1B
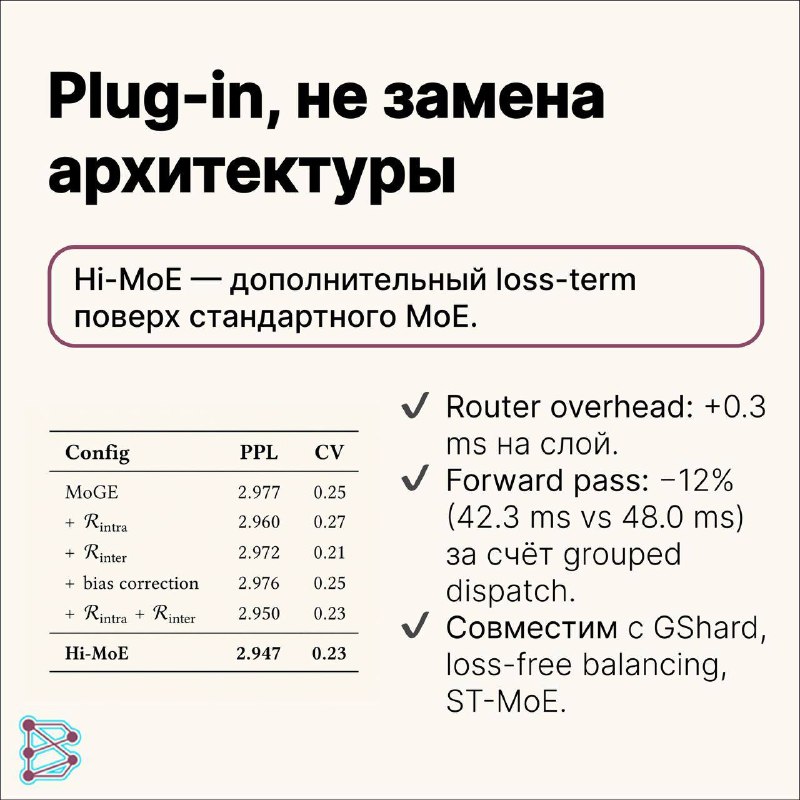
PPL 2.947 vs 2.977 у MoGE
CV 0.23 vs 0.25
🔵OLMoE-7B на 58B токенов
−5.6% perplexity
−40% CV
🔵Swin-MoE 1B на Tiny ImageNet
Лучший Acc@1 и лучший CV среди baselines
Отдельно интересно, что группы экспертов начинают специализироваться на разных визуальных признаках: одни — на foreground-объектах, другие — на текстурах или частях тела.
Hi-MoE — это drop-in objective: метод встраивается в существующие top-k MoE без изменения inference pipeline.
👆 В карточках — почему balance и specialization конфликтуют в обычных MoE и как Hi-MoE разводит их на два уровня оптимизации
#разборстатьи@brainlaboratory
Post #228
1.2K


- 🔥 10
- ❤ 5