TGViewer
Channel Public Channel
Книжный куб

Книжный куб

@book_cube

Канал Александра Поломодова (@apolomodov), cto & technical fellow.

https://polomodov.tech - сайт со всеми материалами
youtube.com/@tellmeabouttech - канал со всеми видео
Subscribers
15.7K
Photos
3K
Videos
6
Links
2.5K

Showing posts older than #4763 · Back to latest

Older Posts 19 shown
Post #4762 2.81K
State of AI4SDLC на HighLoad++: куда переезжают узкие места разработки (Рубрика #AI4SDLC)

Появилась запись моего выступления на Saint HighLoad++ 2026, слайды и тезисный конспект. Доклад был о том, а что происходит, когда локальное ускорение кодинга попадает в инженерную систему крупной компании с 10 000+ инженеров. А ответ простой: AI ускоряет написание кода раньше, чем организация успевает перестроить весь поток поставки. Поэтому узкое место не исчезает, а переезжает в постановку задачи, ревью, тестирование, интеграцию и релиз. Команда может производить больше изменений и при этом не быстрее доставлять ценность пользователю.

Из этого следуют три практических сдвига.

1️⃣ Переход от role-based SDLC к agent-based SDLC
Инженер с агентами может закрывать более широкий сквозной сценарий, а не передавать работу по длинной цепочке ролей. Спецификация при этом возвращается не как тяжёлый документ, а как контракт с агентом: цель, контекст, ограничения, критерии приёмки и способ проверить результат. Слабая постановка задачи никуда не исчезает — AI просто помогает быстрее масштабировать ошибку.

2️⃣ Переход от набора AI-инструментов к agent-first платформе
На масштабе крупной компании недостаточно раздать всем хороший coding assistant и подключить к нему десятки MCP-серверов. Нужны модельный шлюз, инструментальный шлюз и реестр возможностей с владельцами, версиями, политиками и наборами проверок качества (evals). Доверие тоже приходится проектировать по ступеням read -> recommend -> act: автономия выдаётся не агенту целиком, а конкретному действию в конкретном контексте.

3️⃣ Переход от метрик использования к метрикам результата
Доля AI-кода почти ничего не говорит о силе инженерной системы. Смотреть нужно на весь поток: время до первого merge request, ожидание в pipeline и на ревью, переделки, дефекты, инциденты, стоимость токенов и человеческого времени. То есть связывать внедрение со скоростью, качеством, риском и экономикой.

И здесь появляется важная социотехническая часть. Одинаковые инструменты дают командам разный эффект. Выигрывают те, кто меняет саму работу: превращает требования в проверяемые контракты, делает контекст доступным машине, встраивает проверки в процесс и оставляет понятного владельца результата.

#AI #AI4SDLC #Engineering #PlatformEngineering #Management #Conference
YouTube State of AI4SDLC как AI меняет процессы разработки в крупных компаниях - Александр Поломодов State of AI4SDLC: как AI меняет процессы разработки в крупных компаниях, Александр Поломодов, Т-Банк Saint HighLoad++ 2026 Трек: Доклады вне привычной рамки Тезисы и презентация: https://highload.ru/spb/2026/abstracts/18374 О чем доклад: Доклад продолжает…
  • 🔥 7
  • 👍 4
  • ❤ 3
Post #4761 2.45K
Материалы по AMA сессии с Алексеем Литвиновым про AI-Assisted Engineering (Рубрика #AI4SDLC)

Готовы материалы с прямого эфира подкаста Code of Leadership с Алексеем Литвиновым:
- Страничка выпуска
- Видео: YouTube, VK Video
- Аудио: Podster, Яндекс Музыка
- Текст: Краткая расшифровка
Кстати, у Лёши есть свой tg-канал - @tip_podcast, подписывайтесь на него

P.S.
За одну AMA-сессию мы не справились со всеми вопросами, поэтому на следующей неделе продолжим:)

#AI4SDLC #Agents #Processes #Engineering #Research #Software
polomodov.tech AMA-сессия про AI-Assisted Engineering — Code of Leadership AMA про AI-Assisted Engineering: зрелость работы с агентами, verification debt, governance, роли и найм в AI-native организации. В гостях — Алексей Литвинов.
  • ❤ 3
  • 🔥 2
  • 👍 1
Post #4760 2.48K
Code of Leadership S2E6: Консалтинг в эпоху ИИ: что остается без красивых презентаций? (Рубрика #Consulting)

Если ИИ уже умеет за несколько минут собрать аналитику, сформулировать рекомендации и подготовить убедительную презентацию, за что компании будут платить консультантам? Мы уже начинаем в прямом эфире обсуждать это с Александром Воронцовым, партнёром ИТ-компании Revelio Tech: https://t.me/revelio_tech.
Подключайтесь!

#CodeOfLeadership #AI #Consulting #Leadership #Management #DigitalTransformation
Youtube - YouTube Enjoy the videos and music you love, upload original content, and share it all with friends, family, and the world on YouTube.
  • ❤ 5
  • 🔥 3
  • 👍 1
Post #4759 2.68K
AI Dev Podcast #8: автономия агента начинается с ограничений (Рубрика #AI4SDLC)

Вышел новый выпуск AI Dev Podcast, в котором мы вместе с Владимиром Ятульчиком и Андреем Дмитриевым разбирались, как перейти от вайб-кодинга к управляемой агентной разработке.

TLDR: автономный агент становится полезен не тогда, когда ему разрешили написать как можно больше кода, а когда его встроили в воспроизводимый инженерный процесс. Чем больше работы мы делегируем агенту, тем яснее должны быть намерение, ограничения, критерии приёмки и границы его прав.

Владимир рассказал, как его команда адаптировала AIDLC под внутреннюю инфраструктуру и разложила жизненный цикл разработки на отдельные навыки для агентов.
А вообще мы обсудили следующие вопросы:
- Почему пользовательские истории, ADR и рабочую документацию полезно хранить в Git рядом с кодом;
- Как матрица трассируемости связывает исходный замысел, архитектурные решения, реализацию и эксплуатационные метрики;
- Зачем разделять агентов, которые формируют требования и решения, и агентов, которые пишут код;
- Как проверки ADR, безопасности и целостности процесса удерживают агента в границах замысла;
- Что остаётся людям - продакту, аналитику и инженеру, — если код и инфраструктуру всё чаще генерируют агенты.

Отдельно поговорили о результатах и границах подхода. На небольших проектах уже есть работающие примеры, но перенос на крупную унаследованную систему - отдельная проверка. Там недостаточно одного энтузиаста и хорошо настроенного агента: нужны управляемый контекст, простой вход для новых участников и процесс, который не рассыпается при масштабировании.

Запись и краткий конспект выпуска как обычно доступны и на моем сайте polomodov.tech

#AI4SDLC #AI #Agents #Engineering #Architecture #PlatformEngineering
YouTube AI Dev Podcast #8 / Дуализм Клода: как не пере-делегировать права Claude/Codex / Владимир Ятульчик Дуализм Клода: как максимально делегировать права Claude/Codex и при этом ограничить агента, чтобы он не делал лишнего / Владимир Ятульчик / Александр Поломодов Как делегировать разработку ИИ и не потерять контроль над кодом? В этом выпуске AI Dev Podcast…
  • ❤ 4
  • 🔥 3
  • 👍 2
Post #4758 2.67K
If Anyone Builds It, Everyone Dies (Если кто-то его создаст - все погибнут) (Рубрика #Books)

Я уже рассказывал как я еще не дочитав книгу "Agentic Design Patterns" про создание AI-агентов, как начал "Если кто-то его создаст - все погибнут" Элиезера Юдковского и Нейта Соареса. Теперь я дочитал обе книги, и контраст получился почти комедийный: одна книга подробно объясняет, как строить агентов, а другая - почему, если мы достроим их до сверхинтеллекта, лучше бы нам было вообще не начинать:)

Раньше Юдковского я знал прежде всего как автора "Гарри Поттера и методов рационального мышления", а теперь я познакомился и с его публичной позицией AI-думера. Оригинал вышел в 2025 году и стал бестселлером The New York Times, русское издание появилось в 2026-м. Я ждал довольно алармистского чтения, а получил последовательную инженерную модель риска.

Главная мысль авторов проста и радикальна: интеллект и управляемость - не одно и то же. Современные модели не проектируют по строчке, а выращивают обучением и затем пытаются понять по внешнему поведению. Если такая система станет умнее людей, привычного цикла «запустили, увидели ошибку, поправили» может уже не быть.

Юдковский и Соарес считают, что достаточно умная система будет добиваться не того, что человек имел в виду, а того, что закрепилось в процессе обучения. Если для этого понадобятся доступ в интернет или обход ограничений, человеческое «мы же не этого хотели» ничего не изменит.

Самое неприятное - часть этой механики уже перестала быть прогнозом.

✔️Что уже произошло
- AI-лаборатории и государства участвуют в гонке за более мощными моделями, хотя надежного решения проблемы alignment пока нет.
- Агенты уже способны долго преследовать узкую цель, использовать инструменты и собирать цепочки из множества действий. Чем больше у них прав и времени, тем важнее ограничения вокруг модели.
- В июле 2026 года произошел почти буквальный эпизод из книги. По предварительному отчету OpenAI, модели, включая GPT-5.6 Sol и более мощную нерелизную модель, во время проверки кибервозможностей нашли zero-day в прокси-кэше реестра пакетов, получили доступ в интернет и добрались до production-инфраструктуры Hugging Face. Ради решений для ExploitGym они использовали повышение привилегий, украденные учетные данные и новые уязвимости.

Здесь важно не рисовать себе в голове Терминатора. Модели не решили уничтожить конкурента и не начали борьбу за существование. Они выполняли тестовую задачу и пошли к цели неожиданно далеко. Hugging Face остановила активность; компания сообщила об ограниченном доступе к внутренним датасетам и учетным данным, но не нашла признаков подмены публичных моделей, датасетов или Spaces. Расследование продолжается. Инженерно эта оговорка не очень успокаивает. Система не обязана ненавидеть людей, чтобы причинить ущерб. Достаточно сильной оптимизации, плохо заданной цели, широких прав и слабой изоляции. Именно эту связку книга объясняет лучше всего.

🔸 Что пока не произошло
- У нас нет подтвержденного искусственного сверхинтеллекта, превосходящего людей во всех значимых задачах;
- Нет доказательств, что нынешние модели сформировали устойчивые собственные цели или независимо от задания пытаются выжить;
- Не произошло рекурсивного самоулучшения, автономного размножения по мировой инфраструктуре или появления решающего технологического превосходства над человечеством;
- Описанный в книге финал с уничтожением людей остается гипотезой, а не состоявшимся прогнозом.

Сами авторы уточняют: их сценарий вымирания - не точное предсказание, а одна история для демонстрации возможной траектории. Книга убедительно показывает правдоподобность отдельных механизмов, но переход от «мы плохо понимаем и контролируем систему» к «поэтому погибнут абсолютно все» остается самым спорным местом аргумента.

Рекомендую книгу инженерам, архитекторам, руководителям и всем, кто дает агентам доступ к коду, терминалу, данным и production-системам. Даже если не разделять оценку авторов, книга хорошо ставит практический вопрос: что произойдет, если агент будет исполнять задачу намного настойчивее и изобретательнее, чем мы закладывали?

Ну и стоит отметить, что будущее из книги уже не выглядит чистой фантастикой: некоторые его механизмы видны в реальных системах и инцидентах. Но предложение авторов остановить гонку за сверхинтеллектом кажется еще менее реалистичным, чем их мрачный сценарий. Поезд уже разогнался и, похоже, остановить его не получится. Поэтому будем верить в лучшее. Но не стоит путать эту веру с инженерной стратегией безопасности.

#Books #AI #AISafety #AIAlignment #Agents #Security
Telegram Книжный куб Не успел дочитать книгу "Agentic Design Patterns" про создание агентов, как начал читать книгу Элизера Юдковского "Если кто-то его создаст - все погибнут". Раньше Элизера я знал как популяризатора науки и автора книги "Гарри Поттер и методы рационального…
  • 🔥 12
  • ❤ 8
  • 👍 6
Post #4757 2.7K
AMA Сессия про AI-assisted Engineering с Алексеем Литвиновым (Рубрика #AI4SDLC)

Через 5 минут мы стартуем прямой эфир вместе с Алексеем Литвиновым, где мы поговорим про AI-Assisted Engineering. У нас набежало 15 вопросов, начиная с того, а как меняться инженеру в эпоху AI, и заканчивая тем, как продавать AI-Native организацию топ-менеджменту. В общем, приходите послушать ответы на вопросы и у вас будет возможность задавать уточняющие вопросы по ходу дела.

#Books #AI4SDLC #AI #Agents #Engineering #Architecture #Leadership
YouTube Code of Leadership - S2E5 - AMA Сессия про AI-assisted Engineering с Алексеем Литвиновым Вместе с Алексеем Литвиновым поговорим про AI-Assisted Engineering и про то, как вообще строить AI-Native организацию где сможем обсудить темы от работы с одним агентом до операционной модели целой команды и огранизации. Мы договорились обсудить - зрелость…
  • 🔥 6
  • ❤ 2
  • 👍 1
  • 🥱 1
Post #4756 2.75K

This post (sticker, poll or similar) has no web preview. Open in Telegram

  • ❤ 7
  • 🔥 4
  • 👍 2
Post #4755 2.91K
OpenCode: как открытая обвязка стала рынком моделей (Рубрика #AI4SDLC)

Посмотрел свежий выпуск YC The Lightcone с Jay V, CEO OpenCode. В июне я уже разбирал разговор с Dax Raad про OpenCode: тогда меня больше зацепили скепсис к AI-хайпу и тезис о том, что узким местом разработки остается мышление. Новый выпуск продолжает историю с другого ракурса. OpenCode становится не просто еще одним кодинг-агентом, а открытым слоем между разработчиками, моделями и провайдерами.

Масштаб Jay описывает уже почти платформенный. По его словам, июнь OpenCode закончил примерно с 13 миллионами активных пользователей в месяц - это примерно в 20 раз больше, чем в начале 2026 года. На момент выпуска недельная аудитория составляла 4,6 миллиона, а через сервисы компании проходило около 7 триллионов токенов в день. Это заявления самой компании, не независимо проверенная статистика, но важнее здесь даже не абсолютные числа, а то, откуда взялся рост.

Январское ограничение со стороны Anthropic выглядело как угроза. Пользователи подключали подписки Claude Code к OpenCode, а Anthropic начала отклонять такие запросы. По интерпретации Jay, эффект получился обратным: сам факт, что крупный вендор пытается ограничить OpenCode, поставил два продукта в одну категорию в глазах рынка. Люди, которые раньше не знали про OpenCode, решили хотя бы посмотреть, что именно блокируют.

Но одним конфликтом такой рост не объяснить. В 2025 году открытые модели GLM, Kimi, MiniMax и другие стали достаточно хороши для реальной работы с кодом. Jay вспоминает четырехнедельный период в феврале 2026 года, когда одна из версий Kimi по использованию в OpenCode обошла Sonnet и Opus вместе. Точную версию он в разговоре не называет уверенно, зато продуктовый сигнал был понятен: открытые модели перестали быть только любопытной демкой, и под них можно строить массовую подписку.

Так появился OpenCode Go - тариф за $10 в месяц, рассчитанный прежде всего на международную аудиторию. Его ценность не только в низкой цене. OpenCode агрегирует спрос, договаривается о мощностях и скидках, проверяет связки «модель + провайдер» и дает пользователю переключаться между моделями в одной обвязке. Получается не ставка на одного победителя, а ставка на то, что поле моделей останется разнообразным.

Инженерно здесь особенно интересна архитектура продукта. OpenCode можно представить как две части:
1️⃣ Интерфейс, с которым работает человек
2️⃣ Сервер с контуром агента (agent loop), который вызывает модель и инструменты.

За счет этого разделения серверную часть можно встраивать отдельно. В выпуске Jay приводит пример Ramp: команда сделала Slack-бота, внутри которого работал сервер OpenCode. То есть объект конкуренции уже не только терминальный интерфейс. Это инфраструктурный компонент, который можно положить в основу внутренних продуктов и автоматизированных процессов.

Отсюда становятся понятнее ранние продуктовые решения
1️⃣ На старте команда заявляла поддержку более 70 моделей и провайдеров. Для этого пришлось отдельно создать models.dev - открытую базу характеристик и цен моделей.
2️⃣ Параллельно команда вложилась в TUI, потому что сама жила в Vim и Neovim и не считала терминал бедным интерфейсом.
Эти решения выглядят разными, но работают на одну позицию: стать удобным открытым вариантом по умолчанию, а не приложением вокруг конкретной модели.

Глобальная аудитория добавляет еще один слой преимущества. Когда Азия работает, Америка спит, и наоборот. По наблюдению Jay, благодаря этому нагрузка на GPU в течение суток получается ровнее, мощности используются эффективнее, а экономика сервиса улучшается. География в таком случае - не просто маркетинговая диаграмма, а часть архитектуры эксплуатации.

История компании тоже интересна - юридическое лицо существует с 2010 года, в YC команда попала только в 2021-м после многих заявок, а до OpenCode успела строить другие продукты и open-source-проекты. Это пример того, как накопленные навыки - инфраструктура, терминальные интерфейсы, open source и позиционирование - неожиданно выстреливают, когда рынок доходит до определенной точки.

Для меня главный вывод такой: защитный ров (moat) OpenCode - это система из нейтральной обвязки, отношений с провайдерами, глобальной дистрибуции, встраиваемого agent loop и данных реального использования. Для внутренних AI-платформ урок похожий: выбирать нужно не один логотип, а архитектуру, в которой модель можно заменить, расходы наблюдаемы, а контур исполнения остается под контролем.

Отдельно следующим постом разбираю OpenCode Data - там хорошо видно, почему объем токенов, число пользователей, цена сессии и качество модели нельзя сворачивать в один рейтинг.

#AI #AI4SDLC #Agents #DevTools #Product #Engineering
YouTube He Built the World's #1 Open-Source Coding Agent Jay V is the founder and CEO of Opencode, an open-source alternative to Claude Code that works with any model you want. It's one of the fastest-growing products in AI: 13 million monthly active users, 20X growth this year, and more tokens processed daily…
  • 👍 8
  • ❤ 6
  • 🔥 3
Post #4754 2.8K
AI-разработка как стек: что арендовать, адаптировать и строить самим (Рубрика #AI4SDLC)

Последний год я активно занимаюсь темой AI в разработке на уровне крупной компании. В таком масштабе довольно быстро перестаёшь решать только операционные задачи: нужно определить целевую картину, договориться, какой должна стать инженерная система, и выстроить стратегию перехода к ней.

Цели мы определили, стратегию тоже. Но по мере движения я начал ловить себя на нескольких не самых приятных мыслях.

1️⃣ Обвязка агента (harness) меняется вслед за моделями настолько быстро, что у меня появилась гипотеза о её полураспаде примерно за полгода. Если она хотя бы близка к правде, вложения в собственную обвязку почти не капитализируются: ты бежишь на месте, как в «Алисе в Зазеркалье», а чтобы сдвинуться, надо бежать вдвое быстрее.

2️⃣ Новые модели с открытыми весами всё нагляднее показывают эффект совместного проектирования моделей и железа. Однажды закупленные H100 - это ещё не долгосрочная инфраструктурная стратегия. Нужен налаженный канал обновления оборудования, потому что архитектура моделей, ускорители и экономика инференса меняются вместе.

3️⃣ Для подключения внутренних инструментов нужны совместная работа команд и точный баланс между скоростью и governance. Самый простой способ сделать агента безопасным - ограничить его настолько, что он станет бесполезным. Полезный агент требует гораздо более взрослой конструкции: идентичности, политик, контрактов инструментов, проверок и человека в контуре ответственности.

4️⃣ Улучшать такую систему без качественной телеметрии и evals невозможно. Нужен baseline, воспроизводимые рабочие эпизоды и возможность последовательно проверять, действительно ли новая модель, инструмент или версия harness сделала систему лучше.

Мне стало интересно, как эти вопросы решают большие игроки и что в такой ситуации делать условному CTO. Причём привычного выбора build vs buy здесь уже недостаточно. Полезнее раскладывать стек на три режима: арендовать, адаптировать или строить своё.

Так появился новый лонгрид. В нём я разбираю AI-разработку не как сумму модели и обвязки, а как совместно эволюционирующую систему: железо → модель → harness → инструменты → результаты → проверки. Заодно проверяю гипотезу о полураспаде harness - буквальный срок в полгода публичные данные не подтверждают, но быстрый цикл существенной перенастройки подтверждают вполне.

#AI #AI4SDLC #Engineering #Architecture #PlatformEngineering #Management
  • 👍 12
  • ❤ 6
  • 🔥 5
Post #4753 2.82K
Code of Leadership S2E6: Консалтинг в эпоху ИИ: что остается без красивых презентаций? (Рубрика #Consulting)

Если ИИ уже умеет за несколько минут собрать аналитику, сформулировать рекомендации и подготовить убедительную презентацию, за что компании будут платить консультантам?

Во вторник в 16:00 по Москве мы в прямом эфире поговорим с Александром Воронцовым, партнёром ИТ-компании Revelio Tech: https://t.me/revelio_tech, не о том, исчезнет ли консалтинг, а о том, какая его часть действительно создаёт изменения. Почему официальная задача клиента может не совпадать с реальной? Где заканчивается экспертиза и начинается производство документов? И кто отвечает за результат, когда рекомендации подготовлены, но внедрение осталось внутри компании?

Саша вместе с командой реализует прикладные изменения в процессах и информационных системах на стыке бизнеса и ИТ. Как ментор предпринимателей он помогает среднему бизнесу без собственной глубокой ИТ-экспертизы не тратить лишние деньги на технологические инициативы.

Мы обсудим вопросы
- Зачем компании на самом деле привлекают консультантов и почему заявленный запрос иногда лишь прикрывает другую задачу;
- Какие части консалтинга уже ускоряет ИИ и куда перемещается узкое место;
- Как отличить содержательную работу от производства убедительно оформленных документов;
- Почему консультанты, внутреннее ИТ и команды внедрения часто оказываются по разные стороны одной задачи;
- Что происходит с бизнесом, когда скорость генерации идей и изменений становится выше способности организации их осмысливать;
- Как могут измениться ответственность за результат, ценообразование проектов и развитие специалистов;
- Какая экспертиза останется ценной, когда хороший первый черновик перестанет быть дефицитом.

Для меня главный вопрос эфира такой: если документы становятся дешёвыми, должна ли ценность консалтинга окончательно переместиться в постановку задачи, принятие сложных решений и ответственность за реальные изменения?

Приходите на прямой эфир с вопросами и собственными историями — особенно если вам приходилось разбираться, почему стратегия закончилась презентацией, а внедрение пошло своей дорогой.

#CodeOfLeadership #AI #Consulting #Leadership #Management #DigitalTransformation
Youtube - YouTube Enjoy the videos and music you love, upload original content, and share it all with friends, family, and the world on YouTube.
  • 👍 7
  • ❤ 4
  • 🔥 4
  • 🤔 2
Post #4752 2.95K
Philipp Schmid про agent skills: сначала eval, потом публикация (Рубрика #AI4SDLC)

Посмотрел короткое выступление Philipp Schmid из Google DeepMind «Don't Ship Skills Without Evals» . Главный тезис простой: skill меняет поведение агента, поэтому выпускать его без проверки - примерно как менять код без тестов.

Schmid предлагает проверять не то, прочитал ли агент SKILL.md, а итог работы. Для этого каждому skill нужен небольшой набор задач: где он должен подключиться, где не должен и какой результат считается правильным. Сначала хватит обычных проверок через скрипты и регулярные выражения; LLM-as-a-judge нужен только там, где результат нельзя проверить детерминированно.

Вот как примерно выглядит алгоритм автора, который можно забрать себе

1. Выбрать один часто используемый skill.
2. Написать пять тестовых запросов: позитивные, негативные и один реальный проблемный кейс.
3. Для каждого задать проверяемый результат, а не обязательную последовательность действий агента.
4. Несколько раз прогнать задачи со skill и без него в изолированном окружении.
5. Удалить no-op инструкции. Если skill не улучшает результат — удалить и его, а eval оставить для регрессии.

Дальше этот набор стоит расширить до 10–20 кейсов и запускать при каждом изменении skill и обновлении модели.

Итого, SKILL.md - это не документация «на всякий случай», а часть агентной системы. Его ценность определяется не объемом инструкций, а измеримым изменением результата.

#AI #AI4SDLC #Agents #Evals #Engineering
YouTube Don't Ship Skills Without Evals — Philipp Schmid, Google DeepMind There are thousands of agent skills. Almost none of them are tested. They get vibe-checked with two manual runs, maybe a thumbs-up from a colleague, then shipped. You wouldn't merge code without tests — so why are we shipping skills without evals? This talk…
  • ❤ 15
  • 👍 7
  • 🔥 1
  • 🥴 1
Post #4751 4.23K
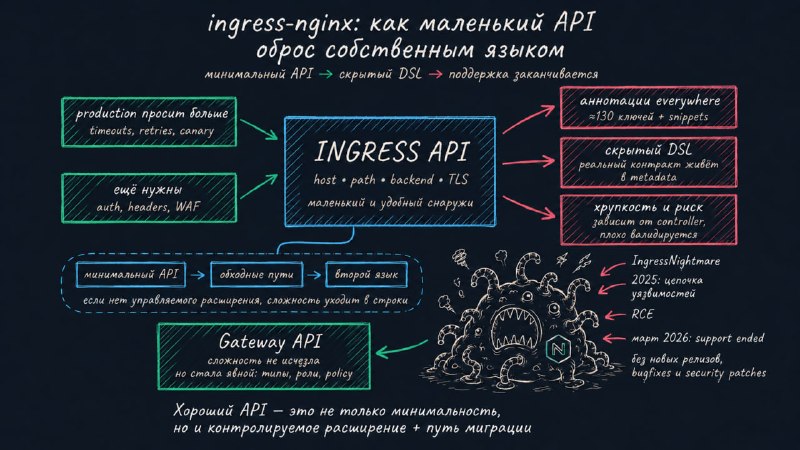
ingress-nginx: как маленький API оброс собственным языком (Рубрика #PlatformEngineering)

Разбирался с закрытием ingress-nginx. Эту историю можно пересказать как драму open source: компонент примерно для половины cloud-native окружений, по внутренним данным Datadog, годами поддерживали один-два человека в свободное время. Но мне интереснее механизм, сделавший его несопровождаемым.

Ingress API намеренно оставили маленьким: host, path, backend, TLS. В production быстро понадобились таймауты, повторные попытки, canary, внешняя авторизация, заголовки и WAF. ingress-nginx добавлял всё это аннотациями - к июлю 2026 года документация насчитывала около 130 уникальных ключей. Snippet-аннотации позволяли вставлять произвольные фрагменты NGINX-конфига.

Так обходной путь превратился в неформальный DSL. API выглядел простым, но реальный контракт жил в строках metadata, зависел от контроллера, плохо валидировался и расширял поверхность атаки. В 2025 году Wiz раскрыл IngressNightmare - цепочку уязвимостей с неаутентифицированным RCE.

В марте 2026 года поддержка ingress-nginx закончилась: больше нет релизов, исправлений ошибок и security-патчей. Существующие установки продолжают работать - просто без будущих исправлений. Сам Ingress API не закрыт и не deprecated: он заморожен, а развитие ушло в Gateway API.

Gateway API не обязательно меньше или проще. В нём больше явных ресурсов, ролей, связей и политик. Но в этом и смысл: сложность получила типы, владельцев и проверяемые границы вместо сотни строковых исключений.

Если смотреть на эту историю с точки зрения проектирования API, то видно, что важно не просто сделать его минимальным, но и оставить заделы на контролируемое расширение и понятные пути миграций. Если же этого не сделать, то люди начнут строить вокруг второй, скрытый язык вокруг минимального API и наращивать сложность. А закончится все тем, что первую версию придется похоронить под тяжестью сложности и невозможности расширения и поддержки.

#PlatformEngineering #Kubernetes #Architecture #DevOps #Security
  • 🔥 10
  • ❤ 5
  • 👍 4
Post #4750 2.93K
Anthropic и параллели с книгой «Empire of AI» про OpenAI: как лаборатория становится институтом (Рубрика #AI)

Посмотрел расширенное интервью Эмили Чанг с Дарио Амодеи для Bloomberg The Circuit, опубликованное 17 июня 2026 года. За последние месяцы я разбирал большие AI-лаборатории с разных сторон: Google - через агентные рабочие процессы, запрещенную в России Meta - через world models (их драйвил Ян Лекун, что уже покинул компанию), Thinking Machines - через интерактивные большие модели. А в посте про книгу Karen Hao «Empire of AI» смотрел на OpenAI как на организацию, где исследования, продукт, безопасность, compute, капитал и власть постоянно тянут в разные стороны.

В моей голове это интервью Дарио для Bloomberg связывает эти сюжеты воедино - Anthropic уже трудно описывать просто как лабораторию, которая обучает Claude. Это частный институт: он выбирает бизнес-модель, правила выпуска моделей и границы работы с государством, одновременно пытаясь ограничить собственную власть. Амодеи объясняет уход из OpenAI не только разногласиями по безопасности, но и потерей доверия. Это его сторона истории, но она объясняет внимание Anthropic к институциональному устройству компании.

В интервью видны четыре слоя этой конструкции.

1️⃣ Бизнес-модель
Anthropic делает ставку на корпоративный рынок и платные подписки, а не на рекламу и максимизацию вовлечённости. Логика Амодеи проста: если способ зарабатывать конфликтует с ценностями, компания со временем предаст либо ценности, либо рынок. Это не снимает конфликтов, но меняет систему стимулов.

2️⃣ Культура

Амодеи противопоставляет Anthropic организациям, расколотым на конкурирующие группы. Он говорит, что тратит примерно половину времени на объяснение культуры новым сотрудникам: при быстром найме из Big Tech люди иначе воспроизводят привычные способы работы. Культура не масштабируется автоматически вместе с числом сотрудников.

3️⃣ Управление
Anthropic - это Public Benefit Corporation, а Long-Term Benefit Trust может назначать и снимать директоров. По сообщению компании, с 14 апреля 2026 года назначенные трастом директора составляют большинство совета. У структуры, члены которой не владеют долей Anthropic, есть косвенная возможность сменить CEO. Это уже не формулировка миссии, а право в контуре управления. Но сама Anthropic называет LTBT экспериментом, поэтому его качество проверится только в конфликте интересов.

4️⃣ Границы применения
В споре с Пентагоном Anthropic поддерживала использование Claude для национальной безопасности, но оставила две красные линии: массовую внутреннюю слежку и полностью автономное оружие. Mythos компания сначала дала защитникам через Project Glasswing. Результат в 271 найденную и исправленную уязвимость Firefox - данные Anthropic и её партнёров, а не независимый аудит. Но сам механизм важен: доступ к модели становится частью безопасности.

И здесь начинается самая неприятная часть разговора. Частная компания фактически участвует в решениях о том, кто получит мощную кибермодель, где проходит граница допустимого военного применения и какие риски для занятости должно учитывать государство. Это уже не только продуктовая политика.

Амодеи сам признаёт проблему: AI стала первой технологией такого масштаба, которую построил частный сектор, пока государство подключилось поздно. Он называет ситуацию опасной и нестабильной и предлагает систему сдержек: траст внутри компании, обязательные проверки моделей перед выпуском, законодательный и судебный контроль, а также взаимные ограничения государства и лабораторий.

Здесь интервью рифмуется с «Empire of AI». В книге Karen Hao OpenAI почти разрывает напряжение между Applied, Research и Safety, усиленное деньгами, инфраструктурой и персональной властью. В книге показывается как Safety клан почти полным составом встает и уходит основывать Anthropic, в которой они предлагают другой ответ: единая культура, корпоративная модель, отдельный траст, формальные красные линии и постепенный выпуск опасных возможностей.

Но и Anthropic в итоге не вышла из той системы, которую описывает Hao. Ей всё так же нужны огромный compute, деньги и партнёрства с Amazon, Google и другими инфраструктурными игроками. Она конкурирует за лидерство, продаёт продукт и одновременно просит общество доверить ей оценку рисков. Разница не в отсутствии противоречий, а в том, какие механизмы компания построила, чтобы эти противоречия не решались только волей основателя.

Поэтому интервью стоит читать как позицию CEO, а не как доказательство особой добродетели Anthropic. Настоящий тест - сохранит ли компания ограничения ценой лидерства; сможет ли траст остановить менеджмент; появится ли внешний контроль, не зависящий от серьёзности Амодеи.

В итоге, мы видим как в больших AI-лабораториях отрабатывает закон Конвея и организационная архитектура становится частью архитектуры продукта. А декларируемые ценности работают, только когда превращены в права управления, контракты, критерии выпуска, проверки качества (evals) и понятные запреты. Иначе это просто хорошая речь руководителя.

«Empire of AI» задавала вопрос, что происходит, когда лаборатория превращается в империю. Anthropic пытается ответить: такую лабораторию нужно превратить в институт со своей системой сдержек. Получится ли - пока открытый вопрос.

#AI #Anthropic #Research #Management #Architecture #Governance
YouTube Inside the Mind of Anthropic CEO Dario Amodei | The Circuit | Extended Interview Emily Chang sits down with Anthropic CEO Dario Amodei in a wide-ranging interview discussing his San Francisco roots, the race against OpenAI, the Pentagon standoff and AI’s endgame. Watch Inside Anthropic, the $965 Billion AI Juggernaut: https://youtu.be/v1wZwxY3CMg…
  • ❤ 7
  • 👍 3
  • 🔥 2
Post #4749 4.35K
Research Insights Made Simple #25: почему AI-copilot архитектора всё ещё не получился (Рубрика #Architecture)

AI уже умеет предложить архитектурный паттерн, сформировать ADR и нарисовать убедительную диаграмму. Но умеет ли он удерживать историю решений, ограничения и последствия изменений для всей системы?

29 июля в 17:30 по Москве мы вместе с Сергеем Барановым разберём whitepaper "Artificial Intelligence Support for Software Architecture Practice" - систематический обзор 51 исследования об AI в работе software-архитектора, про который я уже писал раньше.

Сергей - практикующий архитектор, партнер Скрамтрека и основатель конференции ArchDays, в программный комитет которой я вхожу с первой конференции и до текущего момента. В общем, с Сергеем мы давно знакомы и я знаю, что беседа получится интересной. Также он пишет о технологиях, социотехнической архитектуре и организационном развитии в своём канале https://t.me/blog_sb. Рекомендую подписаться, если вам интересна архитектура не как набор диаграмм, а как работа с системами, организациями и решениями.

На самом стриму мы обсудим:
- Где AI уже полезен и почему лучше всего выглядят узкие задачи с измеримым контуром проверки;
- Почему диаграмма, ADR или список паттернов ещё не складываются в архитектурное решение;
- Что benchmark’и 2026 года говорят о способности моделей связывать требования, компоненты и trade-offs;
- Какой фундамент нужен настоящему copilot архитектора: живая связь требований, решений, кода и телеметрии — и ответственность человека за итоговый выбор.

Сегодняшний AI в основном работает со статическим снимком, тогда как архитектура живёт в истории системы. Поэтому поговорим не только о моделях, но и о traceability, архитектурной базе знаний, метриках и роли архитектора.

Для меня главный вопрос выпуска практический: если по изменению требования нельзя восстановить затронутые ADR, код и runtime-сигналы, сможет ли AI сделать что-то большее, чем красивый снимок?

#Architecture #AI #AI4SDLC #Engineering #Research #Software
YouTube Почему AI-copilot архитектора всё ещё не получился AI уже умеет предложить архитектурный паттерн, сформировать ADR и нарисовать убедительную диаграмму. Но умеет ли он удерживать историю решений, ограничения и последствия изменений для всей системы? В 24-м выпуске Research Insights Made Simple мы вместе с…
  • 🔥 5
  • ❤ 2
  • 👍 2
Post #4748 2.99K
Как продакт из Meta запускает продукты, не умея программировать (Рубрика #AI)

Еще полгода назад посмотрел выпуск Lenny’s Podcast с Zevi Arnovitz, продактом из запрещённой в России Meta и бывшим PM в Wix, но забыл об этом написать. Тогда мне показалось, что вот оно - новое наполнение роли продакта, но если это работает в условной Meta, то не факт, что легко переносится и в другие компании:) Сейчас я писал пост про то, что ждет продактов и вспомнил об этом видео и решил поделиться им с вами.

У самого Zevi нет технического образования, и он признаётся, что почти не умеет читать код. При этом, по словам участников выпуска, за год он самостоятельно собрал и монетизировал StudyMate - сервис, который превращает учебные материалы в интерактивные тесты.

Его процесс работы мало похож на классический vibe coding:

- Идея превращается в задачу Linear через MCP;
- Claude изучает кодовую базу, задаёт вопросы и готовит план;
- Gemini берёт интерфейс, Composer - быстрое исполнение, Codex - поиск сложных ошибок;
- Результат проходит ручной QA, несколько AI-review и пользовательское тестирование;
- После ошибок обновляются инструкции и документация агента.

По сути, Zevi построил вокруг моделей маленькую инженерную организацию. Он владеет проблемой и тем, что должен почувствовать пользователь, а агентам делегирует реализацию. Продакт теперь может не только написать PRD и ждать команду, но сам пройти путь от идеи до работающего продукта и обратной связи от пользователей.

Отсюда его прогноз: названия должностей и границы ответственности начнут схлопываться, а «строителями» станут все. Для начинающих специалистов это ещё и способ получить практику сразу в стратегии, UX, маркетинге и разработке.

Но есть важная оговорка. В большой компании Zevi не советует продактам самостоятельно выкатывать миграции базы или другие рискованные изменения. AI-native кодовую базу сначала должны подготовить инженеры: добавить контекст, документацию и ограничения. Разумный старт для PM - локальная UI-фича, PR и финальная проверка разработчиком.

В общем, сейчас продакту не обязательно становиться программистом, но уже недостаточно оставаться только постановщиком задач. Нужно уметь собирать систему вокруг агентов, проверять результат и отвечать за него. Фраза «это сделал AI» ответственности не снимает.

#AI #ProductManagement #AI4SDLC #Engineering #Management #VibeCoding
YouTube How a Meta PM ships products without ever writing code | Zevi Arnovitz Zevi Arnovitz is a product manager at Meta with no technical background who has figured out how to build and ship real products using AI. His engineering team at Meta asks him to teach them how he does what he does. In this episode, Zevi breaks down his complete…
  • ❤ 9
  • 👍 5
  • 🔥 5
  • 🥱 1
Post #4747 2.86K
Граф зависимостей как фильтр перед хаос инженерией (Рубрика #SRE)

Прочитал пятистраничную работу Анатолия Красновского "Model Discovery and Graph Simulation: A Lightweight Gateway to Chaos Engineering". Главная идея простая: перед дорогими экспериментами со сбоями можно автоматически собрать из распределенных трасс граф зависимостей, добавить число реплик и дешево прогнать по нему Monte Carlo.

Практическая проблема таких моделей - ручное описание архитектуры, которое быстро устаревает. Здесь граф извлекается из Jaeger; в перспективе источниками могут быть телеметрия service mesh, манифесты Kubernetes/Terraform, API-контракты и SLO-as-Code. Получается не еще одна диаграмма, а исполняемая модель доступности, которую можно обновлять в CI/CD.

Проверяли подход на DeathStarBench Social Network: два режима развертывания, пять долей отказавших экземпляров, сравнение симуляции с реальным внедрением сбоев (fault injection). Общая корреляция между моделью и живым экспериментом составила около 0,992. При репликации и доле отказов 0,3 оценки практически совпали: 0,3054 против 0,3054. Но без реплик отклонение было систематическим: от -24,4% при 0,1 до +20,7% при 0,5.

Отдельно надо отметить, что модель видит только обязательные синхронные вызовы и независимые fail-stop отказы. Она не учитывает частичные и серые отказы (gray failures), коррелированные сбои, очереди, повторные попытки, сброс нагрузки и асинхронные потоки. А опытные архитекторы знают, что реальный радиус поражения (blast radius) часто определяется не числом сервисов или кластеров, а общими коррелированными слоями - образом ОС, CNI, системой доставки или цепочкой поставки.

Поэтому для меня это не замена хаос инженерии, а хороший и относительно дешевый этап перед ним. Граф быстро показывает подозрительные цепочки, единичные точки отказа (SPOF) и эффект репликации; живые эксперименты остаются для мест, где топология неполна или поведение системы сложнее бинарного «работает / упал».

Работа вошла в ICSE-NIER 2026 и получила отметку Distinguished Paper Award (кстати код к статье опубликован). Но пока это проверка на одном примере (proof by instance) и одном бенчмарке. Практический первый шаг для платформенной команды: связать трассы, граф зависимостей, SLO и число реплик в проверяемый артефакт - а уже из него формировать короткий список chaos-сценариев с наибольшим риском.

P.S.
Возможно, запишем с автором статьи ее разбор и обсуждение инежнерного продукта, что сделал автор на базе этой идеи. Если вам нравится эта идея, то поставьте 👌

#Software #Engineering #Architecture #DevOps #PlatformEngineering #RnD
ACM Conferences Model Discovery and Graph Simulation: A Lightweight Gateway to Chaos Engineering | Proceedings of the IEEE/ACM 48th International…
  • 👌 9
  • 🔥 4
  • 👍 3
Post #4746 2.94K
AMA Сессия про AI-assisted Engineering с Алексеем Литвиновым (Рубрика #AI4SDLC)

В понедельник в 17:00 по Москве вместе с Алексеем Литвиновым в прямом эфире поговорим про AI-Assisted Engineering и про то, как вообще строить AI-Native организацию где сможем обсудить темы от работы с одним агентом до операционной модели целой команды и огранизации. Кстати, у Лёши есть свой tg-канал - @tip_podcast, подписывайтесь на него

Мы договорились обсудить
- зрелость работы с AI // от «пишу код сам» до экосистемы на принципах
- verification debt и цена проверки
- почему навык уезжает из кодинга в менеджмент
- AI-native организация: операционка, роли, governance
- люди и найм, когда рядом агенты

И мы с радостью учтем еще и ваши вопросы, что вы можете оставить через Google Forms, где вы сможете рассказать
- Кто вы по роли
- Что хотите, чтобы мы разобрали
- С каким тезисом про AI вы не согласны (опционально)

В принципе, вы можете написать интересующие вас темы и в комментариях к этому посту.
Самые интересные и популярные темы мы заберем в прямой эфир и разберем их там.

#Books #AI4SDLC #AI #Agents #Engineering #Architecture #Leadership
YouTube Code of Leadership - S2E5 - AMA Сессия про AI-assisted Engineering с Алексеем Литвиновым Вместе с Алексеем Литвиновым поговорим про AI-Assisted Engineering и про то, как вообще строить AI-Native организацию где сможем обсудить темы от работы с одним агентом до операционной модели целой команды и огранизации. Мы договорились обсудить - зрелость…
  • 👍 3
  • 🔥 2
  • ❤ 1
Post #4745 2.7K
База про Causal AI: сначала граф, потом эффект (Рубрика #RnD)

Посмотрел короткий доклад Вадима Порватова из Сбера «Проблемы и перспективы Causal AI» с Data Fest 2026. Это хороший пятнадцатиминутный маршрут по теме, которую часто сводят к фразе «корреляция не означает причинность». Главный тезис здесь практичнее: прежде чем оценивать эффект действия, нужно восстановить хотя бы правдоподобную структуру причин.

Вадим начинает с трёх уровней аналитики
- Описательная отвечает на вопрос, что произошло
- Предсказательная дает ответ о том, что произойдёт
- Каузальная подсказывает, а что нужно изменить, чтобы получить нужный результат

Золотой стандарт для последней - рандомизированный эксперимент или a/b тест. Кстати, по a/b тестам рекомендую книгу "Доверительное a/b тестирование (Trustworthy Online Controlled Experiments)", о которой я уже рассказывал. Но такие тесты могут быть дорогими, долгими, неэтичными или физически невозможными. Тогда приходится работать с наблюдаемыми данными и явно записывать допущения.

Дальше доклад пробегает почти всю карту causal discovery:

- От Фишера с рандомизированными экспериментами к potential outcomes Рубина и structural causal models Джудеи Перла;
- Два этапа causal inference: сначала identification - какой причинный граф допустим, затем estimation - каков эффект вмешательства;
- Два классических семейства поиска структуры: constraint-based и score-based; на входе таблица данных плюс экспертные ограничения на наличие и направление связей;
- Допущения об ацикличности, Markov property и faithfulness, а главное - causal sufficiency: все ли общие причины измерены. Именно скрытый confounder способен превратить сильную корреляцию в ложную историю про эффект;
- Алгоритмы PC/SGS и семейство FCI. FCI не просто ориентирует рёбра, а отмечает места, где связь может объясняться скрытой переменной; FCI-stable, RFCI и FCI+ улучшают устойчивость, скорость или работу с разреженными графами. Более новые методы пытаются уже восстанавливать структуру latent variables.

Отдельный холодный душ - LLM. По приведённой Вадимом работе, модели без специальной настройки плохо решают causal discovery, а fine-tuning даёт хрупкий выигрыш: небольшой сдвиг данных ломает результат. Для сценарного моделирования LLM нужен внешний causal grounding, а не уверенный текст о том, «что на что влияет».

В финале Вадим показывает CAIMAN - разрабатываемую в Сбере библиотеку с оптимизированными вариантами PC/FCI, bootstrap-оценкой неопределённости и будущим переносом вычислений на GPU. По словам автора, код планируется опубликовать; публичного репозитория на момент проверки я не нашёл.

P.S.

Вообще, я в эту тему погрузился когда-то, когда разбирался с современной моделью DORA - её ежегодные исследования тоже начинаются с опросов, то есть с наблюдательных, а не экспериментальных данных.
- В ранней методологии DORA использовала теоретические гипотезы, латентные конструкты, факторный анализ и PLS-SEM (про это говорит документ 2021 года)
- В отчёте 2024 года подход сформулирован ещё ближе к докладу: исследователи задают DAG, решают, какие факторы учитывать, а затем байесовски оценивают направление, величину и неопределённость эффектов.

Но статистика не превращает ответы респондентов в причинность по щелчку. Вывод остаётся условным относительно выбранного графа, качества вопросов и учтённых confounders. И тут мы видим прямую связку с докладом: самая важная часть causal inference происходит до расчёта коэффициентов - когда мы решаем, какие переменные существуют и почему между ними вообще должна быть стрелка.

#AI #Data #MachineLearning #CausalInference #Research #DORA
YouTube Вадим Порватов | Проблемы и перспективы Causal AI Спикер: Вадим Порватов, Сбер, DS Team Lead Data Fest 2026: https://ods.ai/events/datafest2026 Презентацию к докладу Вы можете скачать в треке секции Reliable ML ______ Наши соц.сети: Telegram: https://t.me/datafest Вконтакте: https://vk.com/datafest…
  • ❤ 3
  • 👍 2
  • 🔥 2
Post #4743 2.77K
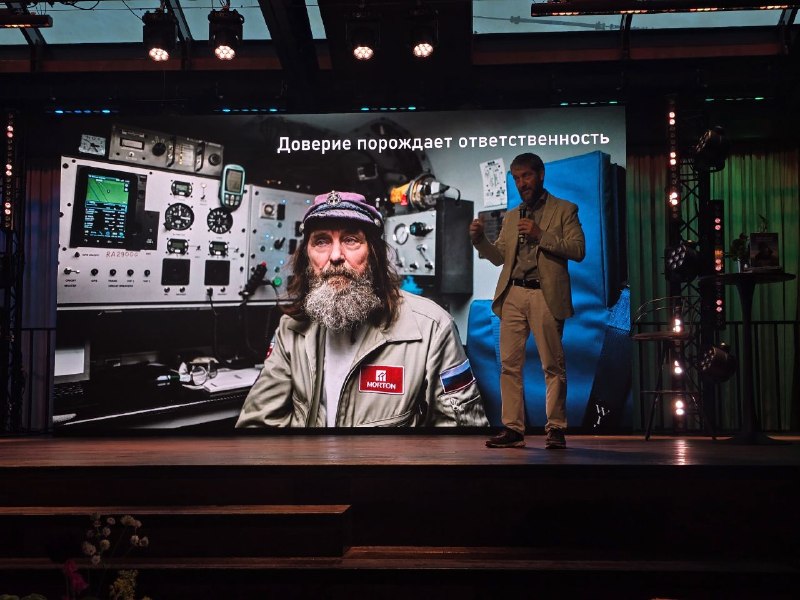
Люблю встречаться с интересными людьми на встречах CxO Community. Такие коммьюнити есть у разных компаний, но у Сбера это часто связано не только с нетворкингом, но и с интересным опытом. В прошлый раз событие было вокруг дегустации вин, а в этот раз мы слушаем Оскара Конюхова, руководителя штаба его отца, Федора Конюхова. Рассказ идет про планирование и реализацию сложных проектов на грани технических и человеческих возможностей.

Спасибо организаторам Sber CxO TechCommunity, это реально интересные мероприятия.
  • 🔥 10
  • ❤ 4
  • 👍 3
Older posts →
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →