TGViewer
Channel Public Channel
Big data world

Big data world

@bigdata_world

Интересные статьи Data Science : Big Data : Machine Learning : Deep Learning

По вопросам сотрудничества- @Daily_admin_info

По иным темам @un_ixtime
Subscribers
2.24K
Photos
413
Videos
64
Links
1.3K

Showing posts older than #1028 · Back to latest

Older Posts 20 shown
Post #1026 597
От экспериментов 🧪 к развертыванию 🚀: MLflow 101 | Часть 01
Улучшите свое путешествие по MLOps, создав спам-фильтр с помощью Streamlit и MLflow

Давайте посмотрим на конвейер, который мы собираемся построить к концу этого блога 👆

Держитесь крепче, потому что это не будет быстрым чтением! потому что сжатие означало бы упущение важных деталей. Мы создаем комплексное решение MLOps https://pub.towardsai.net/from-experiments-to-deployment-mlflow-101-40638d0e7f26
  • 👍 3
Post #1024 563
Наблюдение и аналитика с открытым исходным кодом для приложений LLM

Langfuse — это решение для наблюдения и аналитики с открытым исходным кодом для приложений на основе LLM. Он в основном ориентирован на производственное использование, но некоторые пользователи также используют его для локальной разработки своих приложений LLM.

https://github.com/langfuse/langfuse
GitHub GitHub - langfuse/langfuse: 🪢 Open source agent evals & observability: Trace, evaluate, and improve LLM applications with one open… 🪢 Open source agent evals & observability: Trace, evaluate, and improve LLM applications with one open platform. - langfuse/langfuse
Post #1023 501

Forwarded from Робототехника автономные системы и автоматизация

В этой работе разрабатывается оптимизированный подход машинного обучения для оценки позы рук человека с помощью одних умных часов.

На двух примерах использования мы демонстрируем, что этот интуитивно понятный интерфейс управления позволяет пользователям быстро вмешиваться в поведение робота, временно корректировать свои цели или обучать совершенно новым политикам управления путем имитации.

https://arxiv.org/abs/2306.13192
Post #1022 529
CoTracker — модель для отслеживания любой точки (пикселя) на видео.

Эта архитектура основана на нескольких идеях из литературы по оптическим потокам и отслеживанию и объединяет их в новую, гибкую и мощную конструкцию. Он основан на сети преобразователей, которая моделирует корреляцию различных моментов времени с помощью специализированных уровней внимания.

Бумага: https://arxiv.org/abs/2307.07635
Код: https://github.com/facebookresearch/co-tracker
Демо: https://huggingface.co/spaces/facebook/cotracker

Сайт: https://co-tracker.github.io/
Post #1021 527
Сделай SAM: Segment Anything Model в задачах компьютерного зрения (часть 1).

Всем привет! В прошлой статье мы рассказывали, как можно ускорить процесс разметки данных с помощью интерактивной сегментации, и уже упоминали state-of-the-art-решение в этой области — модель Segment Anything. Сегодня остановимся на том, как можно улучшить качество и производительность SAM: научить модель генерировать более детализированные и гранулярные маски, а также ускорить её работу в 50 раз и адаптировать для мобильных устройств. А в следующей части на примерах покажем, что способности SAM не ограничиваются одной только сегментацией: модель может применяться для решения самых разных задач компьютерного зрения.

Что такое Segment Anything (SAM)? 

SAM (Segment Anything Model) — это сегментационная модель, которая была выпущена Meta AI*  весной 2023 года и быстро стала одной из самых популярных AI-моделей. SAM называют первой фундаментальной моделью в компьютерном зрении и сравнивают с ChatGPT в NLP из-за рекордно большого количества разнообразных данных, которые видела модель (SAM обучалась на датасете SA-1B, содержащем более одного миллиарда масок); а также из-за её способности к zero-shot transfer, то есть способности легко обобщаться для решения смежных задач.

Читать далее https://habr.com/ru/companies/sberdevices/articles/757606/
Хабр Сделай SAM: Segment Anything Model в задачах компьютерного зрения (часть 1) Всем привет! В прошлой статье мы рассказывали, как можно ускорить процесс разметки данных с помощью интерактивной сегментации, и уже упоминали state-of-the-art-решение в этой области — модель Segment...
  • 👍 1
Post #1020 552
Создание простого образа Docker Data Science

В этом кратком руководстве рассказывается о настройке среды обработки данных Python с использованием Docker, описывается создание файла Dockerfile, создание образа, запуск контейнера, совместное использование и развертывание изображений, а также их отправка в Docker Hub. https://www.kdnuggets.com/2023/08/simple-docker-data-science-image.html
KDnuggets Creating A Simple Docker Data Science Image - KDnuggets This concise primer walks through setting up a Python data science environment using Docker, covering creating a Dockerfile, building an image, running a container, sharing and deploying images, and pushing to Docker Hub.
Post #1019 571
Современные большие языковые модели (Large Language Models, LLM) произвели революцию в нашей способности обрабатывать и понимать огромные объемы текстовых данных. Однако эти модели, такие как LLaMA и LLaMA2, часто имеют недостаток: они ограничены фиксированной длиной контекста, что означает, что они не могут работать с длинными последовательностями входных данных при оценке. В данной работе это ограничение решается путем исследования различных методов "экстраполяции длины контекста", что, по сути, позволяет этим моделям понимать и работать с более длинными текстовыми последовательностями.

Ссылка на статью: https://arxiv.org/abs/2308.10882
Ссылка на код: https://github.com/abacusai/Long-Context

Обзор статьи: https://andlukyane.com/blog/paper-review-giraffe
GitHub GitHub - abacusai/Long-Context: This repository contains code and tooling for the Abacus.AI LLM Context Expansion project. Also… This repository contains code and tooling for the Abacus.AI LLM Context Expansion project. Also included are evaluation scripts and benchmark tasks that evaluate a model’s information retrieval cap...
Post #1018 570
Post #1017 686
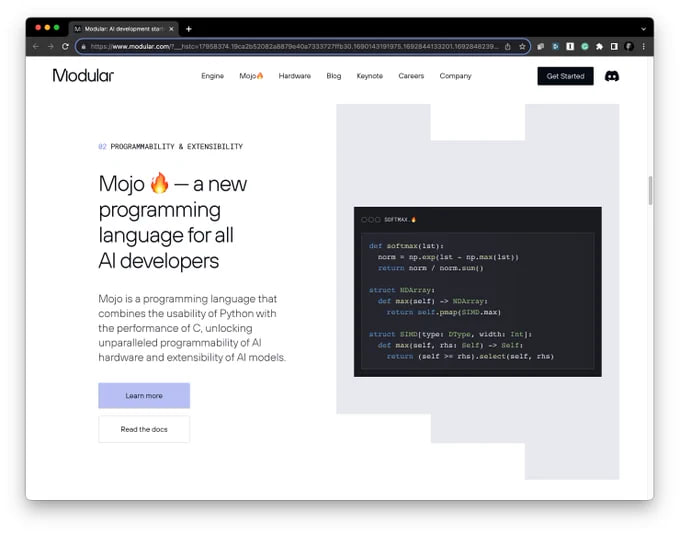
Сможет ли Python пережить это? Компания Modular, стоящая за Mojo, только что собрала 100 миллионов долларов на исправление инфраструктуры искусственного интеллекта для разработчиков. Это много денег! Mojo — это язык программирования для разработчиков искусственного интеллекта, который в 35 000 раз быстрее Python https://venturebeat.com/ai/modular-looks-to-boost-ai-mojo-with-100m-funding-raise/
Post #1016 592
Понимание автоматической дифференциации в 30 строках Python

Я инженер по машинному обучению и использую в своей работе такие библиотеки, как Tensorflow и Pytorch, для обучения нейронных сетей. И я давно не хотел написать простейший фрагмент кода для выполнения так называемого автоматического дифференцирования , которое лежит в основе обучения нейронных сетей. https://vmartin.fr/understanding-automatic-differentiation-in-30-lines-of-python.html?utm_source=substack&utm_medium=email
www.vmartin.fr Victor MARTIN ~ Understanding Automatic Differentiation in 30 lines of Python Understanding Automatic Differentiation in 30 lines of Python. In this article, I will try to iteratively build the simplest code to calculate derivatives automatically on scalars.
Post #1015 634
Квантование наборов данных (DQ) - это новая схема сжатия больших наборов данных в небольшие наборы, которые могут быть использованы для обучения любых нейросетевых архитектур.


🖥 Github: https://github.com/magic-research/dataset_quantization

📕 Статья: https://arxiv.org/abs/2308.10524v1

☑️ Dataset: https://paperswithcode.com/dataset/gsm8k
GitHub GitHub - magic-research/Dataset_Quantization: [ICCV2023] Dataset Quantization [ICCV2023] Dataset Quantization. Contribute to magic-research/Dataset_Quantization development by creating an account on GitHub.
Post #1012 582
StableVideo: текстовое редактирование диффузионного видео с учетом согласованности

Методы на основе диффузии могут генерировать реалистичные изображения и видео, но они затрудняют редактирование существующих объектов в видео, сохраняя при этом их внешний вид с течением времени. Это предотвращает применение моделей распространения для естественного редактирования видео в практических сценариях. В этой статье мы решаем эту проблему, вводя временную зависимость в существующие модели распространения, управляемые текстом, что позволяет им генерировать согласованный внешний вид для редактируемых объектов. https://rese1f.github.io/StableVideo/
Post #1011 584
Бесконечное радио создаваемое нейронными сетями. Open-source проект

Привет всем увлеченным нейронными сетями или тем, кто хочет вникнуть в технологии. Сегодня я хотел бы познакомить вас со своим захватывающим проектом с открытым исходным кодом «Бесконечное нейронное радио». Бесконечное, потому что lofi музыка и подкасты могут генерироваться нейронными сетями бесконечно. В этой статье я бы хотел углубиться в то, как все работает изнутри.

Вдохновением для этого проекта послужило для меня разочарование в моем любимом музыкальном приложении. Поскольку со временем приложение стало не удобным для меня, я почувствовал потребность создать что‑то свое с лофи‑музыкой — жанра, который помогает сосредоточиться во время программирования или просто служит расслабляющим фоном в вечернее время. Приложение содержит цитаты, сгенерированные нейронными сетями, в сопровождении GIF‑анимации в пиксельном стиле, которая тоже частино сгенерировано нейронными сетями. Если подкасты вам не по душе, вы можете их отключить и выбрать только нейронную музыку или даже настроиться на радиостанцию, которая уже делается людьми.

Узнать как работаетhttps://habr.com/ru/articles/755788/
Хабр Бесконечное радио создаваемое нейронными сетями. Open-source проект Привет всем увлеченным нейронными сетями или тем, кто хочет вникнуть в технологии. Сегодня я хотел бы познакомить вас со своим захватывающим проектом с открытым исходным кодом «Бесконечное нейронное...
Post #1010 572
GigaGAN: крупномасштабная сеть GAN для преобразования текста в изображение

GigaGAN — это GAN с параметрами 1B, которая может масштабироваться в 36 раз больше, чем StyleGAN. Модель от Adobe/CMU доказывает, что GAN можно масштабировать до больших наборов данных и оставаться стабильными.

https://mingukkang.github.io/GigaGAN/
Post #1009 640
Стэнфорд только что выпустил все лекции профессора Кристофера Поттса по курсу Stanford XCS224U: «Понимание естественного языка»


Код: https://github.com/cgpotts/cs224u/
Видео: https://www.youtube.com/playlist?list=PLoROMvodv4rOwvldxftJTmoR3kRcWkJBp
GitHub GitHub - cgpotts/cs224u: Code for Stanford CS224u Code for Stanford CS224u. Contribute to cgpotts/cs224u development by creating an account on GitHub.
  • ❤ 1
Post #1008 1.42K
Простая нейронная сеть без библиотек и матриц. Обучение с учителем

Руководство? Гайд? В общем ремейк описания моего опыта создания простой, а главное понятной любому новичку нейросети :) https://habr.com/ru/articles/755096/
Хабр Простая нейронная сеть без библиотек и матриц. Обучение с учителем Некоторое время назад у меня впервые зародилось желание написать свою нейросеть и поэкспериментировать с ней, с тех пор я собирал попадающуюся мне информацию, но до дела...
Older posts →
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →