TGViewer
Channel Public Channel
BigData

BigData

@bigdata_1

Data Science : Big Data : Machine Learning : Deep Learning : LLM : Нейроннные сети

По всем вопросам @evgenycarter
Subscribers
3.19K
Photos
778
Videos
98
Links
851
Recent Posts 14 shown
Post #1058 443
⚡️ GLM-5.3-Flash — новая открытая мультимодальная модель для программирования и ИИ-агентов

Компания Z.ai опубликовала веса GLM-5.3-Flash — первой нативно мультимодальной модели в линейке GLM-5. Она умеет работать с текстом и изображениями, писать код, использовать инструменты и выполнять продолжительные агентные задачи.

Под капотом:

🔹 320 млрд параметров, но для каждого токена активируются только 18 млрд;

🔹 контекстное окно до 1 млн токенов;

🔹 гибридная архитектура со sparse- и linear attention для снижения затрат при обработке больших контекстов;

🔹 обучение на мультимодальном корпусе объёмом 30 трлн токенов;

🔹 лицензия MIT, разрешающая коммерческое использование.

По данным разработчиков, GLM-5.3-Flash превосходит GLM-5.2 в тестах и реальных сценариях, приближается к Claude Opus 4.8 в программировании и агентных задачах, но обходится примерно в десять раз дешевле при использовании через API.

Локальное развёртывание поддерживают SGLang, vLLM, TokenSpeed и KTransformers. Правда, слово Flash здесь означает эффективность относительно флагманских моделей, а не возможность запуска на обычном домашнем компьютере: модель всё ещё очень крупная.

https://huggingface.co/zai-org/GLM-5.3-Flash

📲 Мы в MAX

👉 @bigdata_1
  • 👍 3
  • 🔥 2
Post #1057 715
Открытые модели NVIDIA на 1 диаграмме

Вы, вероятно, знаете NVIDIA как компанию, которая продает графические процессоры (GPU). Но это еще и крупнейший в мире издатель открытых ИИ-моделей (NVIDIAAI), линейка которых выходит далеко за рамки обычных чат-ботов.

Мы захотели понять, как компания, известная прежде всего своим аппаратным обеспечением, создает так много высококачественных моделей и почему она раздает их бесплатно. Поэтому мы поговорили с ctnzr, вице-президентом по прикладным исследованиям глубокого обучения в NVIDIA. Он подробно рассказал нам о всей линейке и идеях, стоящих за ней, которые кратко представлены на диаграмме ниже.


Обзор моделей

1. Рассуждение (Reasoning)
Nemotron - это семейство больших языковых моделей (LLM) от NVIDIA, которые «думают», прежде чем ответить. Эта линейка появилась в 2023 году, а текущее поколение, Nemotron 3, представляет собой гибридную модель с архитектурой MoE (Mixture of Experts), которая выпускается в трех размерах:

* Nano: для быстрых и простых задач.
* Super: для более сложного планирования.
* Ultra: для самых тяжелых логических вычислений.

2. Модели мира (World models)
Cosmos предсказывает следующее состояние физического мира, а не следующее слово. Cosmos 3 - это единая омни-модель, способная генерировать правдоподобное видео сцены, анализировать происходящее и предсказывать, что будет дальше.

3. Робототехника
Isaac GROOT - первая открытая базовая модель (foundation model) для гуманоидных роботов. GROOT 1.7 принимает на вход кадры с камеры и инструкции, выдавая моторные команды в режиме реального времени. Ее аналитическим ядром (ядром рассуждений) является Cosmos Reason.

4. Продакшн
Модели безопасности, распознавания речи и компьютерного зрения. Это те самые базовые блоки, которые делают ИИ применимым в реальных приложениях.

5. Специализированные области

- BioNeMo: для биологии и разработки новых лекарств.
- Alpamayo: для беспилотных автомобилей (с возможностью объяснения каждого принятого решения).
- NVIDIA Ising: для квантовых вычислений.
- Earth-2: для моделирования погоды и климата.

📲 Мы в MAX

👉 @bigdata_1
  • 👍 4
Post #1056 569
🚀 Подборка полезных IT каналов в Max


Системное администрирование, DevOps 📌

https://max.ru/i_odmin Все для системного администратора
https://max.ru/bash_srv Bash Советы
https://max.ru/sysadminof Книги для админов, полезные материалы
https://max.ru/i_odmin_book Библиотека Системного Администратора
https://max.ru/i_devops DevOps: Пишем о Docker, Kubernetes и др.
https://max.ru/tipsysdmin Типичный Сисадмин
https://max.ru/channel_win_sysadmin Системный Администратор Windows
https://max.ru/channel_linux_admin Linux: Системный администратор
https://max.ru/channel_linuxmod Linux
https://max.ru/channel_i_linux Системный администратор
https://max.ru/channel_devopslib DevOps, SRE, Sysadmin
https://max.ru/channel_devops_star DevOps Star (Звезда Девопса)

Excel лайфхак 📌
https://t.me/Excel_lifehack Excel лайфхак

Английский с нуля 🇬🇧
https://max.ru/UchuEnglish

1C разработка 📌
https://max.ru/odin1c_rus Cтатьи, курсы, советы, шаблоны кода 1С
https://max.ru/channel_DevLab1C 1С:Предприятие 8

Программирование C++📌
https://max.ru/cpp_lib Библиотека C/C++ разработчика
https://max.ru/channel_cpp_geek C++ geek

Программирование Go📌
https://max.ru/golang_lib Библиотека Go (Golang) разработчика

Программирование React📌
https://max.ru/react_lib React

Программирование Rust📌
https://max.ru/channel_rust_lib

Программирование Python 📌
https://max.ru/python_of Python академия.
https://max.ru/BookPython Библиотека Python разработчика

Java разработка 📌
https://max.ru/bookjava Библиотека Java разработчика
https://max.ru/channel_java_geek Java Geek

GitHub Сообщество 📌
https://max.ru/githublib Интересное из GitHub

Базы данных (Data Base) 📌
https://max.ru/database_info Все про базы данных

Фронтенд разработка 📌
https://max.ru/frontend_1 Подборки для frontend разработчиков

Библиотеки 📌
https://max.ru/programmist_of Книги по программированию
https://max.ru/proglb Библиотека программиста
https://max.ru/bfbook Книги для программистов

Программирование 📌
https://max.ru/bookflow Лекции, видеоуроки, доклады с IT конференций
https://max.ru/itmozg Программисты, дизайнеры, новости из мира IT
https://max.ru/php_lib Библиотека PHP программиста 👨🏼‍💻👩‍💻

Шутки программистов 📌
https://max.ru/itumor Шутки программистов

Защита, взлом, безопасность 📌
https://max.ru/thehaking Канал о кибербезопасности
https://max.ru/xakkep_1 Хакер Free

Книги, статьи для дизайнеров 📌
https://max.ru/odesigners Статьи, книги для дизайнеров

Математика 📌
https://max.ru/Pomatematike Канал по математике
https://max.ru/phismat_1 Обучающие видео, книги по Физике и Математике

Вакансии в IT📌
https://max.ru/progjob
https://max.ru/channel_rabotait

Мир технологий 📌
https://max.ru/mir_teh Канал для любознательных

Бонус 📌
https://max.ru/piterspb_78 Свежие новости Санкт-Петербурга
https://max.ru/mockva_life Свежие новости Москвы
https://max.ru/piterspb Питер Новости: Санкт-Петербург / СПБ / ДТП
MAX Системный Администратор | Sysadmin Windows & Linux Server. … Купить рекламу: https://telega.in/m/i_odmin Блог практикующего админа. Настройка Windows Server, Active Directory (AD), GPO и терминальных серверов (RDP). Раб…
  • 👎 1
Post #1055 694
⚡️ Fable 5 снова вернулась в Claude.

Модель стала доступна спустя почти три недели после отключения. Ограничения со стороны Anthropic сняли — ранее их вводили из-за формулировки про «угрозу нацбезопасности».

До 7 июля Fable 5 можно использовать в подписках Pro, Team, Max и Premium Enterprise. На модель разрешено тратить до 50% недельных лимитов.

После 7 июля бесплатный доступ закончится — останется только оплата по токенам.

👉 @bigdata_1
  • ❤ 3
Post #1054 819
Как LLM на самом деле генерируют текст — Полный пайплайн инференса 🚀🤖

Многие думают, что нейросети выдают готовый ответ мгновенно, но на самом деле это сложный пошаговый процесс. Разберем его на примере простого запроса: «Что такое гравитация?»

Вот что происходит за кулисами:


1️⃣ ВВОД (INPUT) - Модель получает ваш текст. Для нее это пока просто набор символов.

2️⃣ ТОКЕНИЗАТОР (TOKENIZER) - Текст разбивается на токены: слова, части слов или символы. «Что такое гравитация?» становится списком: [Что], [такое], [грави], [тация], [?].

3️⃣ СЛОЙ ЭМБЕДДИНГОВ (EMBEDDING LAYER) - Каждому токену присваивается вектор (список чисел). Эти векторы кодируют семантический смысл. Теперь модель понимает, что «гравитация» близка к понятиям «сила», «масса» и «физика».

4️⃣ СЛОИ ОБРАБОТКИ (PROCESSING LAYERS) - Векторы проходят через десятки трансформерных слоев (на GPT-4 их 96). Это «раунды размышлений»:
🔸 Внимание (Attention): Модель выясняет контекст и какие слова важны друг для друга.
🔸 FNN: Применяет накопленные знания.

5️⃣ ПРЕДСКАЗАНИЕ ВЕРОЯТНОСТИ (PROBABILITY PREDICTION) - На выходе модель получает вероятности для всех токенов своего словаря. Например, после «Гравитация - это» наиболее вероятным будет токен «сила».

6️⃣ ВЫБОР СЛЕДУЮЩЕГО ТОКЕНА (SAMPLING) - Стратегия выборки (жадная, Top-K, Top-P, Температура) решает, какой токен взять: самый вероятный или более творческий. Это причина, почему один и тот же промт может давать разные ответы.(Опционально: Используется трюк со Спекулятивным декодированием для скорости)

7️⃣ ДЕТОКЕНИЗАТОР (DETOKENIZER) - Выбранный номер токена превращается обратно в понятное слово или символ.

8️⃣ ПОТОКОВЫЙ ВЫВОД (STREAMING OUTPUT) - Полученный токен добавляется к ответу, и модель повторяет ВЕСЬ процесс для предсказания СЛЕДУЮЩЕГО токена.

Упрощенная схема в один клик:

[Текст] ➔ [Токены] ➔ [Векторы смысла] ➔ [Слои «размышлений»] ➔ [Вероятности] ➔ [Выбор токена] ➔ [Повторить до финала]

💡Понимание этого процесса снимает мистику с ИИ. Эффективность LLM зависит не только от размера модели, но и от инференса: скорости обработки, использования памяти (KV Cache), FlashAttention и квантования. Понимание этого пайплайна - ключ к отладке, оптимизации и созданию лучших ИИ-продуктов.

👉 @bigdata_1
  • 👍 6
  • ❤ 1
Post #1051 691
🚀 OpenAI не оставила шансов Fable 5 — состоялся анонс GPT-5.6 Sol!

Главная новость: свежая модель разгромила нашумевшую Mythos в целом ряде тестов. Показательный пример — бенчмарк Terminal-Bench 2.1, где флагманская Sol Ultra выбила 91,9%, оставив Fable позади с её 88%.

О релизе:

Тотальная автономность: ИИ теперь может писать приложения почти без помощи разработчиков, непрерывно выполняя задачи по несколько десятков часов подряд.

Бюджетные альтернативы: Вдобавок к мощной Sol компания выкатила более легкие и доступные версии — Terra и Luna.

Публичный доступ к GPT-5.6 откроют уже в ближайшие недели.

👉 @bigdata_1
  • 👍 3
Post #1050 839
Вместо того чтобы смотреть час Netflix, посмотрите эту двухчасовую лекцию из Стэнфорда — она научит вас большему о том, как строятся LLM вроде ChatGPT и Claude, чем большинство людей, работающих в ведущих компаниях по ИИ, узнают за всю свою карьеру.

👉 @bigdata_1
  • 👍 7
  • 🥰 1
Post #1047 744
Кластер M5 Max
72 ядра CPU и 128 ядер GPU, 512 ГБ унифицированной оперативной памяти
Каждый MacBook подключён ко всем остальным через Thunderbolt 5 (120 Гбит/с).

👉 @bigdata_1
  • 👍 2
Post #1046 1.06K
RAG против Агентов (RAGs vs Agents)

Спросите LLM (большую языковую модель) о данных вашей компании, и она начнет гадать. Два паттерна, которые исправляют это - RAG и агенты, и они решают разные задачи.

RAG (Поисково-ориентированная генерация)

RAG объединяет LLM с поиском информации, чтобы обосновать ответы фактами. Этот процесс состоит из 4 шагов:

• Шаг 1: Запрос пользователя (User Query) векторизуется и отправляется на этап поиска (Retrieval).
• Шаг 2: Компонент поиска извлекает наиболее релевантные фрагменты из базы знаний (Knowledge Base: PDF-файлы, вики-страницы и т.д.).
• Шаг 3: Эти фрагменты вставляются в промпт в качестве контекста.
• Шаг 4: LLM пишет ответ, опираясь на извлеченный текст (Answer grounded).

Особенности: Один поиск. Одна генерация. Дешево, предсказуемо и легко поддается отладке.


Агенты (Agents)

Агенты оборачивают LLM в цикл рассуждений с набором инструментов (Tools) для выполнения конкретных действий.

• Шаг 1: Запрос пользователя поступает в среду выполнения агента (Agent runtime) — цикл рассуждений вокруг LLM.
• Шаг 2: LLM анализирует цель и выбирает нужный инструмент (Чтение, Запись, Редактирование, Bash и т.д.).
• Шаг 3: Среда выполнения (runtime) запускает инструмент и передает результат обратно в LLM.
• Шаг 4: LLM снова проводит рассуждения, выбирает следующий инструмент и повторяет этот цикл, пока задача не будет выполнена.

Особенности: Более гибко. Расходует больше токенов. Сложнее отлаживать, так как ошибки накапливаются от шага к шагу.


Главное эмпирическое правило (из центральной части картинки):

• Используйте RAG, когда ответ находится внутри ваших документов.
• Используйте Агента, когда решение задачи требует действий в других системах.

👉 @bigdata_1
  • 👍 2
  • ❤ 1
  • 🤨 1
Post #1045 920
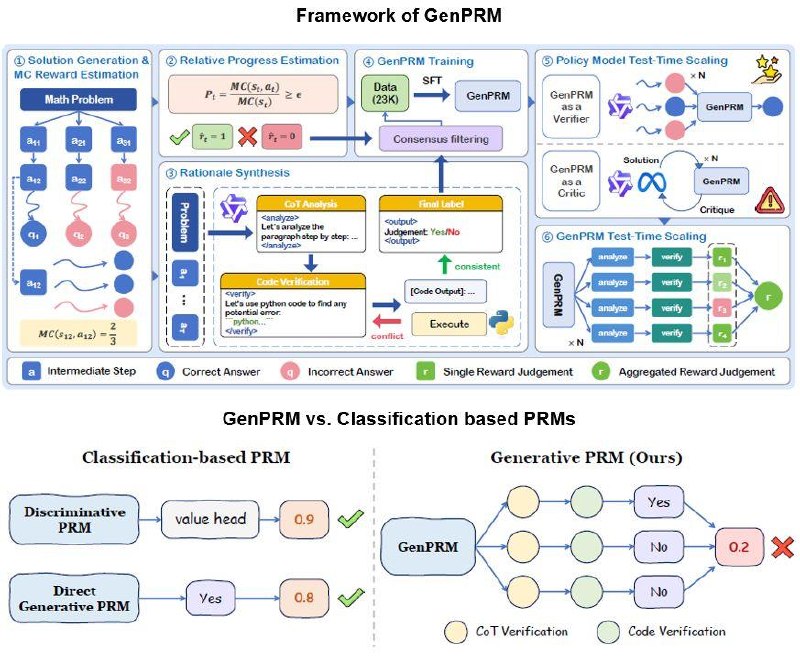
Преодоление узкого места LLM: подход GenPRM к вычислениям во время тестирования Scale с помощью генеративного рассуждения.
Недавно модели вознаграждения процессов (PRM) в качестве верификаторов стали перспективным подходом для повышения производительности LLM. Для решения проблем с PRM в этой статье представлена GenPRM — модель вознаграждения за генеративный процесс, которая выполняет явное рассуждение по цепочке мысли (CoT) с верификацией кода перед вынесением суждений по каждому этапу рассуждения.

👉 Проблемы с текущими PRM:
- Ограниченные возможности контроля и обобщения процессов
- Зависимость от скалярного прогнозирования значений без использования генеративных возможностей LLM
- Невозможность масштабировать вычисления во время тестирования

👉 Фреймворк GenPRM
решает вышеупомянутые проблемы с помощью шестичастной структуры, включающей:
1️⃣ Модель политики генерирует шаги решения, при этом оценки MC оцениваются по траекториям внедрения.
2️⃣ Предлагаемая оценка относительного прогресса (RPE) получает точные метки PRM.
3️⃣ Высококачественные данные надзора процессов, синтезированные с помощью CoT-рассуждения и верификации кода
4️⃣ Консенсусная фильтрация и обучение SFT GenPRM
5️⃣ Обученный GenPRM, функционирующий в качестве верификатора или критика для расширенного масштабирования времени тестирования
6️⃣ Повышение производительности за счёт масштабирования во время тестирования

👉 Масштабирование времени тестирования с помощью GenPRM
1️⃣ Policy Model TTS: GenPRM как проверяющий
- несколько ответов могут быть выбраны из моделей политики, а затем использовать GenPRM в качестве верификатора для выбора конечного ответа в виде параллельных TTS.
2️⃣ Модель политики TTS: GenPRM как критик
- GenPRM можно естественно использовать как критическую модель для уточнения результатов моделей политик, и мы можем масштабировать процесс уточнения с несколькими ходами последовательно по TTS.
3️⃣ GenPRM TTS
- сначала взят пример N путей верификации рассуждения, а затем используй голосование большинством для получения окончательного прогноза, усредняя вознаграждения.

👉 Синтез данных GenPRM
Состоит из трёх этапов:
1️⃣ генерация путей рассуждения и получение меток PRM с помощью оценки Монте-Карло (MC)
2️⃣ оценка прогресса каждого шага с помощью оценки относительного прогресса
3️⃣ синтез обоснований с CoT и верификацией кода, а также вывод меток LLM-as-a-judge с помощью консенсусной фильтрации

📈 Результаты оценки
- GenPRM значительно превосходит предыдущие PRM, имея всего 23K обучающих данных из набора данных MATH.
- при масштабировании времени тестирования 1,5B GenPRM превосходит GPT-4o, а 7B GenPRM превосходит Qwen2.5-Math-PRM-72B на ProcessBench


Blog: https://medium.com/@techsachin/breaking-the-llm-bottleneck-genprms-approach-to-scale-test-time-compute-via-generative-reasoning-0e90e3ffa71e
Paper: https://arxiv.org/abs/2504.00891
Code: https://github.com/RyanLiu112/GenPRM
Models: https://huggingface.co/collections/GenPRM/genprm-67ee4936234ba5dd16bb9943

👉 @bigdata_1
  • ❤ 2
  • 👍 2
Post #1043 969
Anthropic представила Claude Design - отдельный продукт для создания готовых макетов, прототипов, слайдов и сайтов.

В основе сервиса лежит Claude Opus 4.7 - флагманская модель компании с продвинутым пониманием визуала. Главная особенность новинки — не просто генерация интерфейсов, а работа с уже существующими материалами продукта. Claude может анализировать кодовую базу и дизайн-файлы, извлекать из них дизайн-систему и затем автоматически придерживаться фирменного стиля.

То есть сервису не нужно вручную объяснять, какие в проекте используются шрифты, цвета и отступы - он сам подстраивается под бренд. Пока Claude Design доступен в формате research preview для тарифов Pro, Max, Team и Enterprise.

Попробовать: claude.ai/design

#Anthropic #ClaudeDesign #ClaudeOpus #дизайн #прототипы #слайды #сайты #AI #нейросети #технологии


👉 @bigdata_1
  • 👍 3
  • 👎 1
Post #1040 1.29K
🙇‍♂️ Generative AI Learning Roadmap

👉 @bigdata_1
  • 👍 2
Post #1035 1.33K
🌟 Tencent HY-WU: динамические LoRA для редактирования изображений.

Tencent HY опубликовала первую часть серии работ под названием HY-WU (Weight Unleashing). Суть метода в отказе от стандартной парадигмы адаптации, при которой модель получает один фиксированный набор весов для всех задач.

Специальная модель-генератор синтезирует LoRA отдельно под каждый входной пример прямо во время инференса, без дополнительной оптимизации на тест-тайме.

Проблема, которую решает HY-WU, хорошо знакома всем, кто работал с дообучением: когда задачи противоречат друг другу (например, "размыть" против "убрать размытие" или "состарить лицо" против "восстановить"), общий адаптер вынужден идти на компромисс.

Градиенты конфликтуют, и результат оказывается хуже, чем если бы задачи обучались раздельно.

Чтобы не быть голословными, авторы измерили это напрямую: косинусное сходство градиентов между разнородными задачами устойчиво отрицательно, среднее около −0.30, то есть задачи буквально тянут веса в противоположные стороны.
HY-WU предлагает условную генерацию параметров. Модель-генератор (8B параметров) принимает на вход совместное представление изображения и текстового запроса через энкодер SigLIP2, после чего генерирует LoRA-матрицы (~0.72B) и инжектирует их в базовую модель.

Обучение сквозное, только через downstream-loss, без предварительно собранных чекпойнтов адаптеров.

🟡Тесты и результаты

Для тестов выбрали задачу редактирования изображения текстовым запросом - в нем конфликты неизбежны и визуально очевидны.

🟡В попарном human evaluation (GSB) HY-WU выигрывает у всех топовых open-source редакторов с большим отрывом: 67–78% против Step1X, Qwen, LongCat и FLUX;

🟡Среди закрытых систем модель обошла Seedream 4.5 (55.6%) и GPT Image 1.5 (55.5%).

🟡Единственные, кто пока впереди - Nano Banana 2 и Nano Banana Pro.

Tencent проверили: прирост качества дается именно условной маршрутизацией, а не просто увеличением числа параметров. Когда генератор использовали с перемешанными или усредненными условиями, результат проваливался до уровня базовой модели.

Полный SFT с намного большим числом обучаемых параметров давал сопоставимый результат с обычным Shared LoRA, так как в обоих случаях в инференсе применяется одна фиксированная точка в пространстве весов.
Выпущенная работа - первая часть серии исследований по функциональной памяти для генеративных моделей. В планах:

🟢сравнить функциональную память с retrieval-подходами и понять, когда каждый из них уместен;

🟢разработать протоколы онлайн-обучения, при которых модель усваивает новые задачи без деградации на старых;

🟢исследовать масштабирование модели-генератора отдельно от базовой модели.

Помимо этого, в планах выйти за пределы LoRA на другие операторные интерфейсы, распространить метод на видео и агентные системы, а также проработать возможность точечно удалять поведение модели через управление состоянием генератора.

Кроме этого архиполезного исследования Tencent выложили связку из модели-генератора и базовой модели HY-Image-3.0-Instruct, поверх которой она и работает.

Поиграться этой красотой можно, если под рукой простаивает 8х40 GB или 4х80 GB VRAM.


🟡Страница проекта https://tencent-hy-wu.github.io/

🟡Prompt Handbook (китайский) https://docs.qq.com/doc/DUVVadmhCdG9qRXBU

🟡Модель https://huggingface.co/tencent/HY-WU

🟡Техотчет https://github.com/Tencent-Hunyuan/HY-WU/blob/main/assets/report.pdf

🖥 Github https://github.com/Tencent-Hunyuan/HY-WU

👉 @bigdata_1
  • 👍 3
Older posts →

About this channel

How can I read @bigdata_1 without a Telegram account?
TGViewer shows the public web preview Telegram publishes for BigData: recent posts, photos, videos and the subscriber count, with no app, login or account.
How many subscribers does BigData have?
BigData (@bigdata_1) has 3.19K subscribers on Telegram, refreshed roughly every 30 minutes.
Does BigData know I viewed it here?
No. Public channel previews carry no viewer identity, and TGViewer has no accounts or tracking of what you look up.
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →