
Преодоление узкого места LLM: подход GenPRM к вычислениям во время тестирования Scale с помощью генеративного рассуждения.
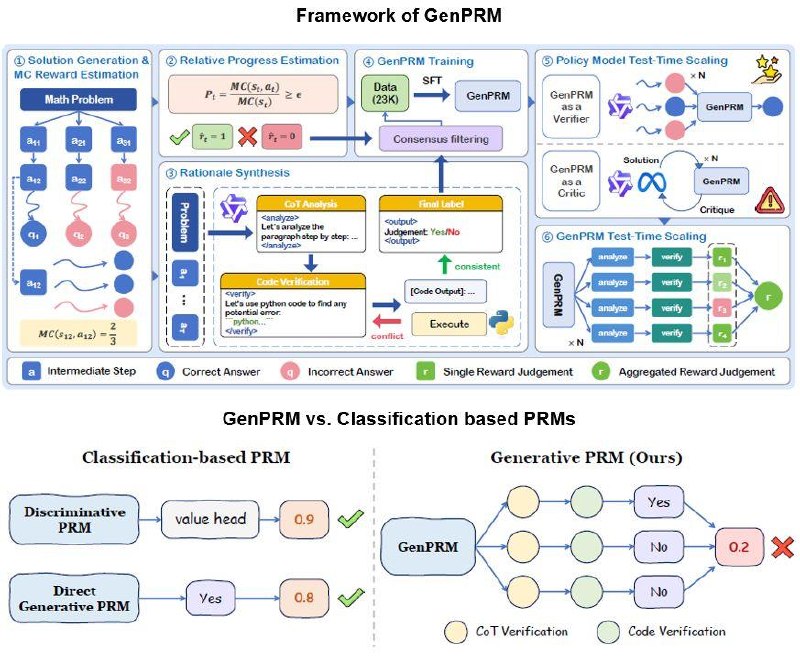
Недавно модели вознаграждения процессов (PRM) в качестве верификаторов стали перспективным подходом для повышения производительности LLM. Для решения проблем с PRM в этой статье представлена GenPRM — модель вознаграждения за генеративный процесс, которая выполняет явное рассуждение по цепочке мысли (CoT) с верификацией кода перед вынесением суждений по каждому этапу рассуждения.
👉 Проблемы с текущими PRM:
- Ограниченные возможности контроля и обобщения процессов
- Зависимость от скалярного прогнозирования значений без использования генеративных возможностей LLM
- Невозможность масштабировать вычисления во время тестирования
👉 Фреймворк GenPRM
решает вышеупомянутые проблемы с помощью шестичастной структуры, включающей:
1️⃣ Модель политики генерирует шаги решения, при этом оценки MC оцениваются по траекториям внедрения.
2️⃣ Предлагаемая оценка относительного прогресса (RPE) получает точные метки PRM.
3️⃣ Высококачественные данные надзора процессов, синтезированные с помощью CoT-рассуждения и верификации кода
4️⃣ Консенсусная фильтрация и обучение SFT GenPRM
5️⃣ Обученный GenPRM, функционирующий в качестве верификатора или критика для расширенного масштабирования времени тестирования
6️⃣ Повышение производительности за счёт масштабирования во время тестирования
👉 Масштабирование времени тестирования с помощью GenPRM
1️⃣ Policy Model TTS: GenPRM как проверяющий
- несколько ответов могут быть выбраны из моделей политики, а затем использовать GenPRM в качестве верификатора для выбора конечного ответа в виде параллельных TTS.
2️⃣ Модель политики TTS: GenPRM как критик
- GenPRM можно естественно использовать как критическую модель для уточнения результатов моделей политик, и мы можем масштабировать процесс уточнения с несколькими ходами последовательно по TTS.
3️⃣ GenPRM TTS
- сначала взят пример N путей верификации рассуждения, а затем используй голосование большинством для получения окончательного прогноза, усредняя вознаграждения.
👉 Синтез данных GenPRM
Состоит из трёх этапов:
1️⃣ генерация путей рассуждения и получение меток PRM с помощью оценки Монте-Карло (MC)
2️⃣ оценка прогресса каждого шага с помощью оценки относительного прогресса
3️⃣ синтез обоснований с CoT и верификацией кода, а также вывод меток LLM-as-a-judge с помощью консенсусной фильтрации
📈 Результаты оценки
- GenPRM значительно превосходит предыдущие PRM, имея всего 23K обучающих данных из набора данных MATH.
- при масштабировании времени тестирования 1,5B GenPRM превосходит GPT-4o, а 7B GenPRM превосходит Qwen2.5-Math-PRM-72B на ProcessBench
Blog: https://medium.com/@techsachin/breaking-the-llm-bottleneck-genprms-approach-to-scale-test-time-compute-via-generative-reasoning-0e90e3ffa71e
Paper: https://arxiv.org/abs/2504.00891
Code: https://github.com/RyanLiu112/GenPRM
Models: https://huggingface.co/collections/GenPRM/genprm-67ee4936234ba5dd16bb9943
👉 @bigdata_1
Post #1045
920
- ❤ 2
- 👍 2