TGViewer
Channel Public Channel
Big Data Science [RU]

Big Data Science [RU]

@bdscience_ru

Big Data Science [RU] — канал о жизни Data Science.
Для сотрудничества: a.chernobrovov@gmail.com
🌏 — https://t.me/bdscience — Big Data Science channel (english version)
💼 — https://t.me/bds_job — channel about Data Science jobs and career
Subscribers
1.62K
Photos
81
Videos
9
Links
546

Showing posts older than #83 · Back to latest

Older Posts 20 shown
Post #82 175
✈️Новый алгоритм управления дронами от MIT
Аэрокосмические инженеры MIT разработали алгоритм, который помогает дронам находить самый быстрый маршрут бесперебойного прохождения препятствий. Это объединяет моделирование полета беспилотника через виртуальную полосу препятствий с данными экспериментов реального дрона, пролетающего по тому же маршруту в физическом пространстве.
Исследования показали, что дрон, обученный по новому алгоритму, пролетел через простую полосу препятствий на 20% быстрее. При этом в некоторых случаях направленный на глобальную, а не локальную оптимизацию, алгоритм замедлял полет дрона, чтобы пройти сложный поворот или сэкономить энергию. Это помогло в конечном итоге обогнать соперников.
https://news.mit.edu/2021/drones-speed-route-system-0810
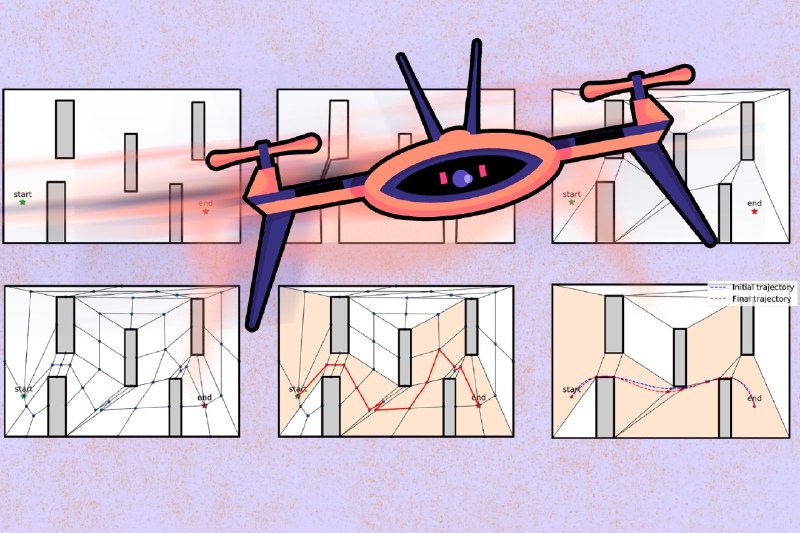
MIT News System trains drones to fly around obstacles at high speeds A new algorithm helps drones find the fastest route around obstacles without crashing. The MIT system could enable fast, nimble drones for time-critical operations such as search and rescue.
Post #81 187
✍🏻SoundStream новый нейронный аудиокодек от Google AI
SoundStream эффективно сжимает речь, музыку и звук с битрейтами, которые обычно используются кодеками обработки для речи. SoundStream опирается на модельную архитектуру, состоящую из сверточной сети кодировщика/декодера и квантователя остаточного вектора, которые обучаются совместно. Благодаря обучению со структурированным отключением на слоях квантователя, одна модель может работать с переменными битрейтами от 3 до 18 кбит/с. Это сравнимо с качеством моделей, обученными с фиксированными битрейтами. Также модель поддерживает реализацию с низкой задержкой и потоковом выводом в режиме реального времени на процессоре смартфона.
Нейросеть состоит из кодировщика, декодера и квантователя. Кодер преобразует входной аудиопоток в кодированный сигнал, который сжимается с помощью квантователя, а затем преобразуется обратно в аудио с помощью декодера. После обучения кодер и декодер можно запускать на разных клиентах для эффективной передачи высококачественного звука по сети. Оценить результаты работы SoundStream и подробнее узнать, как решается проблема квантования кодовых векторов можно здесь: https://ai.googleblog.com/2021/08/soundstream-end-to-end-neural-audio.html
research.google SoundStream: An End-to-End Neural Audio Codec Posted by Neil Zeghidour, Research Scientist and Marco Tagliasacchi, Staff Research Scientist, Google Research Audio codecs are used to efficiently...
Post #80 198
Как настроить гиперпараметры для надежного повышения точности ML-модели: подробный guide
ML-модель и ее предварительная обработка индивидуальны для каждого проекта: гиперпараметры зависят от обрабатываемых данных. Например, в алгоритме логистической регрессии есть разные гиперпараметры (solver, C, penalty), разные комбинации которых дают различные результаты. Аналогично, существуют настраиваемые параметры для машины опорных векторов: gamma, C. Эти гиперпараметры алгоритмов доступны на сайте бесплатной Python-библиотеки Sklearn. Однако, часто разработчику приходится создавать собственные решения, не полагаясь на готовые рекомендации, чтобы разработать ML-модель с высокой точностью, которая зависит от наилучшего сочетания гиперпараметров. Читайте в статье про тестирование различных комбинаций Grid-поиска с библиотекой Sklearn и без нее, проверка результатов кросс-валидацией и выводы насчет эффективности утилизации ресурсов ЦП. https://towardsdatascience.com/evaluating-all-possible-combinations-of-hyperparameter
Post #79 590
Reminder!
Сегодня! 12 августа в 18:00 будет проходить первый митап из серии Citymobil Data Meet-up!
Будем говорить про логистику, городские данные и технологии умных городов, обсудим роль геоданных и проблемы, которые с ними возникают.
Присоединяйтесь к нам, будем разбираться вместе))
Выступают:
- Артем Солоухин (Ситимобил)
- Андрей Критилин (ЦИАН)
- Фёдор Лаврентьев (Яндекс Go)
Не забудьте подготовить вопросы спикерам, после докладов будем общаться и у вас будет возможность их задать 🙂
Ссылка: https://tulu.la/chat/city-mobil-00002d/meetup-0002fv
Post #78 210
🎯ТОП-3 доклада с международной конференции по Learning Representations 2021: краткий обзор от Zeta Alpha
С помощью собственного навигатора по исследованиям ИИ-компания Zeta Alpha составила выжимку из более 800 докладов ICLR 2021, с учетом цитирования и популярности авторов.
1. An Image is Worth 16x16 Words: Transformers for Image Recognition at Scale (Алексей Досовицкий, Лукас Бейер, Александр Колесников, Дирк Вайссенборн, Сяохуа Чжай и др.). Трансформеры, применяемые непосредственно к фрагментам изображений и предварительно обученные на больших датасетах, хорошо работают при классификации изображений и могут превзойти лучшие CNN на больших изображениях. https://openreview.net/forum?id=YicbFdNTTy
2. Rethinking Attention with Performers (Кшиштоф Чоромански, Валерий Лихошерстов, Дэвид Дохан, Синю Сонг, Андреа Гейн, Тамас Сарлос, Питер Хокинс, Джаред Дэвис и др.). Performers, линейные трансформеры с полным рангом и вниманием с помощью методов доказуемой аппроксимации случайных признаков, эффективно работают, не полагаясь на разреженность или низкий ранг. Авторы предлагают матричную декомпозицию механизма самовнимания на матрицы ниже, которые имеют комбинированную сложность, линейную относительно. длина последовательности L: O (Ld²log (d)) вместо O (L²d). https://openreview.net/forum?id=Ua6zuk0WRH
3. PMI-Masking: Principled masking of correlated spans (Йоав Левин и др.). Совместное маскирование коррелированных токенов значительно ускоряет и улучшает предварительное обучение BERT. Вместо случайного маскирования токенов авторы идентифицируют - используя только статистику корпуса - диапазоны токенов, которые сильно коррелированы. Для этого они расширяют точечную взаимную информацию между парами токенов до промежутков произвольной длины и показывают, как обучение BERT с этой целью обучается более эффективно, чем альтернативы, такие как равномерное маскирование, маскирование всего слова, случайное маскирование диапазона и т.д. Эта стратегия работает, не позволяя моделям предсказывать замаскированные слова, а заставляя ее использовать очень мелкие корреляции слов, которые часто появляются рядом друг с другом, чтобы повысить степень изучения более глубоких корреляции в естественном языке. https://openreview.net/forum?id=3Aoft6NWFej
Полный обзор ICLR от Zeta Alpha смотрите здесь: https://www.zeta-alpha.com/post/iclr-2021-10-papers-you-shouldn-t-miss
Post #77
Big Data Science [RU] pinned «⚡️ Ситимобил запускает митапы о применении Data Science в городских и геосервисах, логистике и технологиях умных городов - Citymobil Data Meetup. Первый митап состоится 12 августа в 18:00, онлайн. Звездный состав спикеров с очень интересными темами: 🚕 Артём…»
Post #76 190
🙌🏻Apache Superset – открытый фреймворк для BI и DS-анализа
Став проектом Apache в 2017 году, Superset является мощным BI-инструментом визуализации больших данных, который позволяет пользователям быстро и легко создавать дэшборды, используя простой код, бесплатный конструктор визуализаций и самый продвинутый редактор SQL. Для корпоративного использования особенно важна поддержка разных backend’ов аутентификации (OpenID, LDAP, OAuth, REMOTE_USER) и интеграция со многими СУБД на основе SQL через библиотеку SQLAlchemy. Superset основан на Python, поэтому для его использования рекомендуется сначала установить дистрибутив Anaconda, включающий набор нужных DS-библиотек. Преимущества Apache Superset уже оценили Airbnb, Netflix, Twitter, Yahoo! и множество других компаний, включив его в свои DS-проекты. https://superset.apache.org/
Apache Superset Welcome | Superset Community website for Apache Superset™, a data visualization and data exploration platform
Post #75 214
🔥В 2 раза больше денег от Яндекса: увеличение призового фонда чемпионата по программированию Yandex Cup 2021
Получите свою часть из 6,2 млн рублей, решив реальные задачи одного из 6 треков:
• фронтенд-разработка
• бэкенд-разработка
• мобильная разработка
• аналитика
• машинное обучение
• спортивное программирование.
В этом году ML-трек состоит из четырех направлений:
• анализ текстов на естественном языке
• компьютерное зрение
• распознавание речи
• рекомендательные системы.
Можно выбрать одно направление или участвовать во всех сразу с 20 сентября по 20 октября. Победителей будет четверо, каждый получит 300 000 рублей. Регистрация на чемпионат уже открыта: подайте заявку до 3 октября. С 20 по 26 сентября пройдет пробный тур для знакомства с форматом задач и системой проверки, а с 27 сентября по 3 октября вас ждут реальные соревнования. Финал чемпионата состоится 16 октября.
https://yandex.ru/cup/
Yandex Cup — чемпионат по программированию Попробуйте свои силы в решении нестандартных задач
Post #74 577
⚡️ Ситимобил запускает митапы о применении Data Science в городских и геосервисах, логистике и технологиях умных городов - Citymobil Data Meetup.
Первый митап состоится 12 августа в 18:00, онлайн.
Звездный состав спикеров с очень интересными темами:
🚕 Артём Солоухин (Product Owner Surge Pricing в Ситимобил) поделится своими знаниями о «Switchback-экспериментах и сетевом эффекте»
🏢 Андрей Критилин (Руководитель центра моделирования ЦИАН) расскажет о «Работе с географически неоднородными данными в моделях онлайн-оценки»
🚖 Фёдор Лаврентьев (Head of Internal Efficiency в Yandex Go) выступит с докладом «Границы Москвы: эволюция географии в отчетности Яндекс Такси»
После докладов будет дискуссия со спикерами в которой смогут принять участия слушатели.
Ведущий мероприятия – Алексей Чернобровов.
❗️Регистрация по ссылке: https://citymobil.timepad.ru/event/1730682/
Post #73 196
🏸Что такое мульти-задачное машинное обучение?
Обычно одна ML-модель решает одну задачу, например, классификация изображений или синтез текста. Это называется однозадачное обучение (STL, single-task learning). Но некоторые модели позволяют делать несколько видов прогнозов на одной выборке, например, классификация изображений и семантическая сегментация. Это уже многозадачное обучение (MTL, Multi-task learning). Основными плюсами MTL являются следующие:
• меньший объем обучающей выборки для каждой из отдельных задач за счет укрупнения общего набора данных;
• улучшенное обобщение модели – информация из связанных задач повышает способность модели извлекать полезные данные из датасета и снижает переобучение;
• сокращение длительности обучения – вместо того, чтобы тратить время на обучение множества моделей для решения нескольких задач, обучается единая модель;
• снижение требований к аппаратным ресурсами - ML-модели имеют много параметров, которые необходимо хранить в оперативной памяти. Поэтому для устройств с ограниченной вычислительной мощностью, IoT, лучше иметь одну MTL с некоторыми общими параметрами, а не несколько STL-моделей, которые выполняют ряд связанных задач.
Обратной стороной этих достоинств является снижение производительности. Во время MTL-обучения задачи могут конкурировать друг с другом. Например, когда сегментация экземпляра (сегментирование отдельной маски для каждого отдельного объекта в изображении) обучается вместе с семантической сегментацией (классификация объектов на уровне пикселей), последняя задача часто доминирует, если не использовать механизм балансировки задач.
Кроме того, функция потерь MTL сложнее в результате суммирования отдельных потерь, что затрудняет оптимизацию. Здесь возникает так называемый эффект отрицательной передачи при выполнении нескольких задач и отдельные STL-модели могут работать лучше единой MTL.
В перспективе многозадачное машинное обучение отлично подходит для обработки естественного языка и медицинских исследований, однако сегодняшняя реализация этого подхода еще не полностью покрывает его текущие недостатки.
https://thegradient.pub/how-to-do-multi-task-learning-intelligently/
The Gradient How to Do Multi-Task Learning Intelligently On new multi-task learning methods that automatically learn what to learn together
Post #72 161
✈️2-ой релиз TF-Ranking от Google AI
В декабре 2018 года Google AI представил TF-Ranking – open-source библиотеку на основе TensorFlow для разработки масштабируемых нейронных моделей ранжирования (LTR, learning-to-rank), которые помогают получить упорядоченный список элементов в ответ на пользовательский запрос. В отличие от стандартных моделей классификации, которые классифицируют по одному элементу за раз, LTR-модели получают полный список элементов в качестве входных данных и ищут порядок, который максимизирует полезность всего списка. Больше всего эти LTR-модели распространены в поисковых и рекомендательных системах, но TF-Ranking также применяется в электронной коммерции, построении умных пространств и городов.
В мае 2021 года Google AI выпустил второй релиз TF-Ranking, который обеспечивает полную поддержку встроенного построения LTR-моделей с использованием Keras, высокоуровневого API TensorFlow 2. Модель ранжирования Keras имеет новый дизайн workflow, в т.ч. гибкий ModelBuilder и DatasetBuilder для настройки обучающей выборки, а также конвейер для обучения модели. Также эта версия TF-Ranking поддерживает RaggedTensors, обучающую библиотеку Orbit и еще множество улучшений.
А благодаря углубленному изучению возможностей библиотеки TF-Ranking, команда Google AI создала модель Data Augmented Self-Attentive Latent Cross (DASALC), которая комбинирует преобразование фичей нейросетей с обогащением данных, ансамблевыми методами и ранжированием потерь. DASALC позволяет устранить недостатки LTR-моделей и деревьев решений с градиентным бустингом, сохранив достоинства этих методов.
https://ai.googleblog.com/2021/07/advances-in-tf-ranking.html
https://research.google/pubs/pub50030/
research.google Advances in TF-Ranking Posted by Michael Bendersky and Xuanhui Wang, Software Engineers, Google Research In December 2018, we introduced TF-Ranking, an open-source T...
Post #71 150

Forwarded from Яндекс нанимает | Вакансии для разработчиков

Яндекс открывает регистрацию на чемпионат по программированию Yandex Cup! Призовой фонд вырос в два раза и в этом году составит 6,2 млн рублей.

Участникам предложат задания по бэкенд и фронтенд-разработке, машинному обучению, мобильной разработке, аналитике и спортивному программированию.

Попробовать свои силы могут специалисты старше 18 лет из стран СНГ, трек по спортивному программированию открыт для разработчиков со всего мира. Все участники попадут на радары рекрутеров Яндекса, а разработчики, занявшие первые три места в каждом направлении, смогут пройти собеседование в Яндекс по упрощенной схеме.

Регистрация на чемпионат продлится до 3 октября: https://clck.ru/WXVoD

Присоединяйтесь!
Yandex Cup — чемпионат по программированию Попробуйте свои силы в решении нестандартных задач
Post #70 145
🚗Роботы Яндекса доставят еду американским студентам
6 июля 2021 года Яндекс заключил соглашение о сотрудничестве с американским сервисом доставки еды Grubhub, чтобы доставлять еду в студенческие кампусы США с помощью Роверов. Эти разработанные в Яндексе автономные роботы-курьеры созданы на основе технологий беспилотных автомобилей и могут работать в любую погоду 24/7. Роверы ездят по тротуарам, а дороги пересекают по пешеходным переходам. С начала 2021 года в России роботы привезли тысячи заказов Яндекс.Еда и Яндекс.Лавка. А с апреля они доставляют заказы из ресторанов в американском городе Энн-Арбор в штате Мичиган. https://yandex.ru/company/press_releases/2021/07-06-2021
Компания Яндекс Роботы Яндекса займутся доставкой еды в кампусах американских университетов Яндекс заключил соглашение о сотрудничестве с американским сервисом доставки еды Grubhub. Компания станет партнёром Grubhub по роботизированной доставке в кампусах — студенческих городках при колледжах и университетах в США. Осуществлять доставку будут Роверы…
Post #69 151
☀️В последний месяц лета 2021 успеваем насладиться солнцем, новыми знакомствами и интересными DS-событиями:
• 10 августа, 16:00 МСК Online-митап от Яндекса «Как контролировать расходы на облако» - учимся расходовать cloud-бюджеты более эффективно. Бесплатная регистрация https://cloud.yandex.ru/events/411
• 12-13 августа - всероссийский форум «Цифровая эволюция», г. Калуга, Инновационный культурный центр, ул. Октябрьская, 17а https://digitalregion.ru/
• 19 августа, 11:00 МСК - Онлайн-эфир "Цифровая трансформация малого и среднего бизнеса в российских регионах". Бесплатная регистрация https://events.vedomosti.ru/events/spb_zifrovizavizacia_msb
• 21-22 августа, Москва - первый офлайн-хакатон по развитию CRM-системы нового поколения от компании Т1 Консалтинг с призовым фондом 500 000 рублей https://crmhack.ru/
• 26-27 августа, Москва - восьмой форум «Цифровое предприятие» от группы «Просперити Медиа» и портала CFO-Russia.ru. Роботизация бизнес-процессов, единая модель данных на базе AI и другие практические кейсы от 25 спикеров из разных отраслей экономики. https://www.cfo-russia.ru/meropriyatiya/digen/
yandex.cloud Как контролировать расходы на облако На вебинаре поговорили о том, как пользоваться функцией «Бюджеты» в биллинге.
Post #68 159
👆🏻Что такое AUC - ROC Curve и почему это так важно для оценки качества ML-модели?
Это площадь под кривой ошибок (ROC-кривой) используется как метрика оценки качества алгоритмов классификации. Ее значение лежит в диапазоне [0, 1].
Кривая AUC - ROC измеряет эффективность классификации при различных пороговых значениях. ROC - это кривая вероятности, а AUC - степень или мера разделимости, которая говорит о том, насколько ML-модель способна различать классы. Чем выше AUC, тем лучше модель. Например, при AUC близкой к 1, ML-модель будет хорошо отличать больных пациентов от здоровых. Плохая модель имеет AUC около 0, что означает худший показатель разделимости, что означает, что объекты разных классов будут классифицированы неверно. Если AUC равен 0,5, то модель вообще не может выделять классы.
Чувствительность и специфичность обратно пропорциональны друг другу: увеличивая чувствительность, мы уменьшает специфичность, и наоборот. Снижая порог, мы получаем больше положительных значений, что увеличивает чувствительность и уменьшает специфичность. Наоборот, увеличив порог, получим больше отрицательных значений и более высокую специфичность с низкой чувствительностью.
В мультиклассовой модели можно построить N кривых AUC ROC для N числовых классов, используя методологию One vs ALL. Так, например, если у вас есть три класса с именами X, Y и Z, у вас будет один ROC для X, классифицированный по Y и Z, другой ROC для Y, классифицированный по X и Z, и третий для Z, классифицированный по Y и X.
https://towardsdatascience.com/understanding-auc-roc-curve-68b2303cc9c5
Medium Understanding AUC - ROC Curve In Machine Learning, performance measurement is an essential task. So when it comes to a classification problem, we can count on an AUC - ROC Curve. When we need to check or visualize the performance…
Post #67 149
🙌🏻🚗22 июля 2021 года Яндекс открыл крупнейший в мире датасет беспилотных автомобилей: более 1600 часов движения, разбитых на 600 000 размеченных фрагментов поездок на дорогах России, Израиля и США в разных погодных условиях. Датасет опубликован для конкурса Shifts Challenge в рамках международной конференции NeurIPS 2021, чтобы привлечь внимание к проблеме «сдвига данных» в машинном обучении и снизить неопределенность применения ML-моделей в новых условиях. Все данные обезличены. Датасет содержит высокоточные карты маршрутов и треки всех окружающих машин и пешеходов (их положение, скорость, ускорение и пр.), без персональных данных (номера машин или лица прохожих). Нужно обучить ML-алгоритмы на предоставленных данных и проверить качество их работы в условиях сдвига. Разработчики алгоритмов с лучшим качеством получат денежные призы в 5, 3 и 1 тысяч долларов.
Сайт конкурса: https://research.yandex.com/shifts
Датасет на github: https://github.com/yandex-research/shifts
Подробное описание на habr: https://habr.com/ru/company/yandex/blog/568672/
Новость на официальном сайте Яндекса: https://yandex.ru/company/press_releases/2021/2021-07-22
Shifts Challenge: Robustness and Uncertainty under Real-World Distributional Shift We invite researchers and machine learning practitioners from all over the world to participate in our NeurIPS 2021 Shifts Challenge on robustness and uncertainty under real-world distributional shift.
Post #66 181
💦Из чего состоит ML-pipeline: 3 главных компонента
Если абстрагировать достижения современной ML-инженерии, то для построения эффективного конвейера машинного обучения нужны всего 3 основных инструмента:
• Хранилище фичей (Feature Store) для обработки офлайн- и онлайн-преобразований функций. Feature Store поддерживает контроль версий и должно быть интегрировано с озерами данных и КХД. Также оно должно обеспечивать возможность быстрого обслуживания фичей и оперативного развертывания кода в production. Примеры: Tecton, Hopsworks, Michelangelo Palette, Zipline, Feature Store от Amazon SageMaker и Databricks.
• Хранилище моделей (Model Store) в качестве центрального реестра моделей и отслеживания экспериментов. Оно обеспечивает воспроизводимость версий и отслеживание истории изменений каждой ML-модели, а также связанных артефактов, такие как Git коммиты, pickle-файлы, оценки, регрессия и пр. Примеры: Weights & Biases, MLFlow, Neptune.ai, EthicalML, а также решения от Amazon, Azure, Google.
• Хранилище оценок (Evaluation Store) для мониторинга и повышения производительности моделей. Оно обеспечивает выявление показателей производительности для каждой ML-модели в любой среде, от обучения до production, включая инструменты A/B тестирования и средства построения наглядных дэшбордов. Например, Arize и Neptune.ai.
Дополнительно будут полезны платформы аннотирования данных (Appen), обслуживания ML-моделей (Kubeflow, Algorithmia) и AI-оркестрации (Spell) для координации всех команд, участвующих в MLOps-процессах.
https://towardsdatascience.com/the-only-3-ml-tools-you-need-1aa750778d33
Medium The Only 3 ML Tools You Need At a rapid pace, many machine learning techniques have moved from proof of concepts to powering crucial pieces of technology that people…
Post #65 154
😎Нейросети сервиса Облако Mail.ru помогут сохранить воспоминания
ML-алгоритмы автоматически найдут снимки, сделанные в определённый день, и отобразят их в виде stories, чтобы сформировать пользовательский фотокалендарь, иллюстрирующий памятные события. Благодаря методам распознавания образом, в результат попадут только удачные кадры. А если картинка не понравится пользователю, ее можно удалить прямо из видео-истории. Поделиться анимированной фотогалереей с друзьями можно, отправив ее сообщением или расшарить в VK и Instagram. Обновление уже доступно в мобильном приложении на iOS и Android. https://corp.mail.ru/ru/press/releases/10947/
vk.company VK / Нейросеть Облако Mail.ru выберет лучшие фото для соцсетей С помощью алгоритмов машинного обучения сервис Облако автоматически отбирает снимки, сделанные в определённый день, и отображает их в привычном формате сторис. Так у пользователя формируется своеобразный фотокалендарь, иллюстрирующий памятные события. …
Post #64 167
👀Ищите корпоративное ИИ-решение?
Попробуйте Каталог NGC™ от NVIDIA —реестр ПО, оптимизированного под GPU, для высокопроизводительных вычислений и анализа больших данных в различных отраслях: от чат-ботов ритейла до медицинской визуализации и рекомендательных систем. NGC содержит контейнеры приложений корпоративного уровня, предварительно обученные модели ИИ и отраслевые SDK, которые можно развернуть на локальных системах, в облаке или на границе сети. Например, NVIDIA TAO — это платформа для обучения, адаптации и оптимизации ИИ-моделей, которая позволяет создавать AI-приложения корпоративного уровня без глубоких экспертных знаний и больших датасетах для их обучения. https://www.nvidia.com/ru-ru/gpu-cloud/
NVIDIA GPU-optimized AI Software, Enterprise Services and Support NVIDIA NGC provides access to GPU-optimized AI software, enterprise services and support.
Post #63 148
🔥16 июля 2021 года Яндекс показал первый в мире прототип машинного перевода видео на базе ИИ-технологий биометрии, распознавания и синтеза речи. С ее помощью уже сегодня пользователи десктопного Яндекс.Браузера могут смотреть ролики на английском языке с закадровым переводом. В будущем продукт поддержит и другие языки. https://yandex.ru/company/services_news/2021/2021-07-16
Для тех, кто любит видео – ролик о новой технологии:
https://disk.yandex.ru/d/7DYUm9QSfTPn5A
https://www.youtube.com/playlist?list=PLkMNi_iVG-shtwkqd918VUJ80NIOJ2pQf
Компания Яндекс Яндекс закрыл сделку по покупке банка Яндекс закрыл сделку по покупке банка «Акрополь». В результате Яндекс стал стопроцентным акционером банка и получил все лицензии «Акрополя», включая универсальную банковскую.
Older posts →
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →