TGViewer
Channel Public Channel
Backend Portal | Программирование

Backend Portal | Программирование

@backendportal

Присоединяйтесь к нашему каналу и погрузитесь в мир Backend-разработки

Связь: @devmangx

РКН: https://clck.ru/3FobxK
Subscribers
16.1K
Photos
1.8K
Videos
174
Links
1.5K
Recent Posts 16 shown
Post #3664 448
Если бы пришлось заново изучать System Design в 2026 году, я бы придерживался такого roadmap:

1. Foundation
Networking
HTTP/HTTPS
DNS
Reverse Proxy
TLS/SSL

2. Data Layer
SQL vs NoSQL
Indexing
Replication
Sharding
CAP Theorem

3. Scaling Basics
Caching
CDN
Load Balancing
Rate Limiting
Backpressure

4. Async & Messaging
Kafka/RabbitMQ
Pub/Sub
Event-Driven Systems
WebSockets
Background Jobs

5. Distributed Systems
Consistency Models
Consensus
Fault Tolerance
Leader Election
Idempotency

6. Real-World Design
YouTube
Uber
WhatsApp
Payment Systems
X

Многие разработчики сразу переходят к задачам вроде «Спроектируйте WhatsApp». Но именно хорошее понимание фундаментальных вещей значительно упрощает изучение продвинутого System Design.

Цель — не запоминать архитектурные схемы. Цель — понимать trade-offs. Сохраняйте этот roadmap, если изучаете System Design.

👉 @BackendPortal
Post #3663 546
Объектное хранилище в эпоху быстрых данных

Объём данных, с которыми нужно работать, растёт ежедневно. Стандартных решений уже не хватает для задач ИИ и аналитики. Большие объёмы данных нужно не только хранить, но и быстро записывать и читать.

В MWS Cloud Platform мы построили объектное хранилище не только на привычных HDD-дисках, но и на NVMe. На вебинаре покажем, какие сценарии работы это открывает и как меняет привычные подходы.

Подключайтесь! Обсудим:
✅ Чем классы хранения MWS Object Storage отличаются от привычных
✅ В каких сценариях новый тёплый класс проявляет себя лучше всего
✅ Преимущества и слабые места в разных сценариях работы

📆 7 октября в 14:00 (мск)

Зарегистрироваться
Post #3661 740
Ваш API работает медленно.

Что проверите первым?

• Добавите database index
• Увеличите ресурсы сервера
• Добавите больше replicas
• Обвините сеть

Вместо этого сначала проследите весь путь request:

Client
→ DNS
→ Load Balancer
→ API Server
→ Database
→ External Services

А затем измерьте время на каждом этапе. Backend с ответом за 10 мс не поможет, если браузер загружает bundle размером 15 МБ.

Исправный API не поможет, если database query выполняется 4 секунды. И быстрая database не спасёт, если сторонний API постоянно уходит в timeout.

«API работает медленно» — это не диагноз. Это отправная точка для диагностики.

Я собрал практический API Debugging Cheat Sheet с основными проверками, командами, HTTP status codes, распространёнными проблемами и быстрыми способами их устранения.

👉 @BackendPortal
Post #3660 795
DevOps-инструмент недели: sofka

Kubernetes говорит, что что-то сломалось. Но говорит ли он, почему именно? Приходится проверять статус, события, логи и пытаться понять, в чём проблема.

Именно это решает sofka.

sofka — это TUI для Kubernetes, вдохновлённый k9s. Он показывает состояние rollout, деградировавшие состояния, блокирующие поды и последние warning-события

Вот что он умеет:

• Объясняет, почему ресурс сломан, а не просто сообщает, что с ним проблема
• Встроенная поддержка Flux CD: можно приостанавливать, возобновлять и запускать reconcile без установленного Flux CLI
• Инспектор Helm: история релизов, values и сгенерированные манифесты без установленного Helm
• Есть фильтры вроде cpu>500m, restarts>=5, age<2h, чтобы быстро находить именно то, что нужно
• Можно просматривать таймлайн всех изменений объекта, которые зафиксировал инструмент
• Можно просматривать и передавать файлы напрямую из PVC
• Можно выбрать несколько подов и смотреть их логи одновременно
• Поддержка плагинов Popeye и Trivy

Согласно бенчмаркам проекта, sofka открывает представление подов на 59% быстрее k9s и использует меньше половины его объёма памяти.

В следующий раз, когда деплой зависнет и придётся по кусочкам выяснять, что произошло, попробуйте sofka.

Начать здесь: http://github.com/nklmilojevic/sofka

👉 @BackendPortal
Post #3659 844
Полезная шпаргалка по SQL: основы JOIN-запросы и агрегация

Изучите базовые операции SQL: выборку данных, объединение таблиц с помощью JOIN, агрегирование с функциями COUNT, AVG, SUM и создание подзапросов. Эта шпаргалка станет вашим надежным помощником в ежедневной работе с SQL.

Полная PDF версия тут ⬇️

👉 @BackendPortal
Post #3658 857
Roadmap, которому стоит следовать, чтобы стать сильным Backend Developer в 2026 году:

1. Programming Fundamentals
• Java
• OOP
• Collections
• Multithreading
• Exception Handling

2. Backend Core
• APIs
• Authentication
• JWT/OAuth
• Validation
• File Uploads

3. Databases
• SQL
• Indexing
• Transactions
• Query Optimization
• Redis Caching

4. Scalability
• Load Balancing
• Async Processing
• Queues
• Rate Limiting
• Distributed Systems

5. DevOps & Deployment
• Docker
• CI/CD
• Kubernetes
• Monitoring
• Logging

6. Production Engineering
• Observability
• Performance Tuning
• Security
• Incident Debugging
• Cost Optimization

Большинство разработчиков ограничиваются изучением frameworks. Сильные backend-разработчики понимают, как работают системы, масштабирование и приложения в production.

👉 @BackendPortal
Post #3653 856
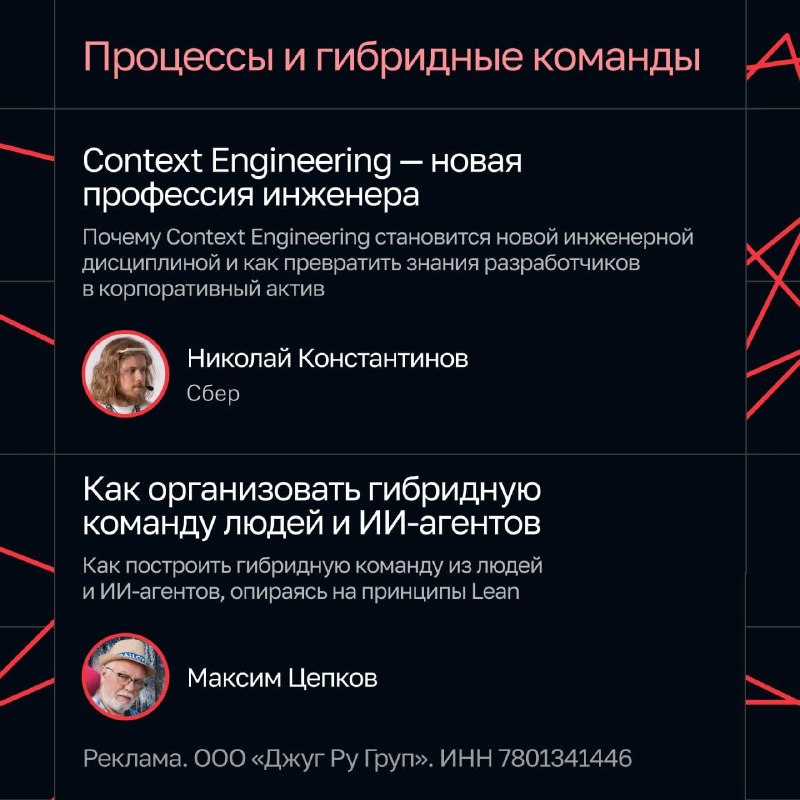
⚡️⚡️Joker 2026: что происходит с профессией разработчика

Индустрия разработки проходит через серьезный переломный момент. Меняются не только инструменты и фреймворки, но и привычный подход к работе.

Поэтому в этом сезоне меняется и Joker: первый день традиционно посвящен Java — Core Java, рантайму и работе на уровне железа. А во второй день будем обсуждать, как прямо сейчас меняется сама инженерная практика.

В программе — Context Engineering, команды из людей и ИИ-агентов, Self-Evolving Agents, новые подходы к архитектуре и работе с моделями, а также вопросы ответственности и роли эксперта.

Собрали главные темы второго дня в карточках.

🌟С промокодом: BackendPortal персональные билеты дешевле

Полное расписание и билеты — на сайте.
Post #3652 877
Backend Checklist — День 15: CORS

Ваш API работает в Postman. Работает через curl. Но стоит вызвать его из браузера — и внезапно появляется CORS error.

> Дело в браузере, а не в сервере

Request может успешно дойти до сервера. Сервер может даже вернуть 200. Но браузер всё равно может запретить frontend читать response, если CORS headers настроены неправильно.
Postman и curl не волнует CORS. Браузер — волнует.

> Preflight, который вы не отправляли

Здесь всё становится интереснее. Вы отправляете POST с JSON, добавляете Authorization header или используете PUT / DELETE. Перед фактическим request браузер может сначала отправить OPTIONS request. Если сервер не обработает его правильно, основной request вообще не будет отправлен. Именно поэтому GET может работать, а POST — внезапно нет.

> Wildcard, который не работает с credentials

Если вы отправляете credentials, то:
Access-Control-Allow-Origin: *

не сработает.

Нужно разрешить конкретный origin и добавить:
Access-Control-Allow-Credentials: true


CORS — это не ваш API, который говорит «нет».


С API всё может быть в полном порядке. Просто браузер применяет правила безопасности для cross-origin requests.

👉 @BackendPortal
Post #3651 918
Большой бесплатный гайд по SQL для начинающих

На freeCodeCamp лежит полноценный текстовый курс по SQL, который ведёт от самых основ до более серьёзных тем. Материал построен последовательно и подойдёт тем, кто только начинает разбираться в реляционных базах данных.

Внутри: таблицы и типы данных, CRUD, SELECT и WHERE, constraints, агрегатные функции, подзапросы, нормализация, JOIN и основы оптимизации запросов. Для практики в курсе используется SQLite, при этом отдельно разбираются различия между SQL-базами.

Хороший материал, чтобы системно пройти SQL с нуля или освежить базу.

👉 @BackendPortal
Post #3649 937
Backend Checklist — День 14: Schema Validation

Ваш endpoint получает age из request body и прибавляет к нему 1. Месяцами всё работает нормально. А затем client отправляет age как "twenty", и необработанный TypeError приводит к ошибке где-то глубоко внутри приложения — далеко от handler, который изначально получил request.

Валидируйте данные на входе, а не внутри business logic.

Request body — это недоверенные входные данные. Schema явно определяет, что именно принимает приложение: названия полей, типы данных, ограничения и обязательные значения.

Валидные данные попадают в приложение как проверенный, строго типизированный object. Невалидные сразу отклоняются на HTTP boundary с 422 Unprocessable Content или 400 Bad Request.

Без schema каждой downstream function приходится самостоятельно перепроверять входные данные. И первая функция, которая забудет это сделать, может стать причиной следующего production incident.

Есть два важных поведения, о которых стоит знать при работе с Pydantic или serializers вашего framework.

Первое — coercion. По умолчанию "123" может превратиться в 123: строка незаметно преобразуется в объявленный тип. Это удобно, но может скрыть ошибку client, который отправляет данные неправильного типа. Strict mode отключает такое поведение.

Второе — extra fields. Необъявленное поле может быть молча отброшено без ошибки. Например, если отправить is_admin в schema, где такого поля нет, оно просто исчезнет. Но если raw input затем попадёт напрямую в model, принятие лишних полей может стать уязвимостью. Настройка extra='forbid' позволяет отклонять такие данные.

Парсите и валидируйте данные один раз на входе, чтобы core logic работала только с теми структурами данных, для которых она была создана.

👉 @BackendPortal
Post #3648 890
Не нарушайте принцип единственной ответственности

Функция должна делать одну вещь, делать её хорошо и только её.

Эта функция делает слишком много:

def calculate_final_total(
price: float,
quantity: int,
discount_rate: float,
tax_rate: float
) -> float:
# Расчёт промежуточной суммы
subtotal = price * quantity

# Применение скидки
discounted_amount = subtotal * (1 - discount_rate)

# Расчёт налога
final_total = discounted_amount * (1 + tax_rate)

return final_total


Проблема здесь в том, что расчёт промежуточной суммы, скидки и налога объединён в одну функцию. Любое изменение одного из этапов может повлиять на весь расчёт.

Лучше разбить логику на небольшие специализированные функции:

def calculate_subtotal(price: float, quantity: int) -> float:
return price * quantity

def apply_discount(subtotal: float, discount: float) -> float:
return subtotal * (1 - discount)

def calculate_tax(amount: float, tax_rate: float) -> float:
return amount * (1 + tax_rate)


Так намного лучше.

Небольшие функции с одной задачей проще покрывать модульными тестами, потому что у них меньше зависимостей и требуется меньше моков.

Кроме того, изолированные компоненты проще переиспользовать в разных частях приложения или конвейера, не подтягивая лишние зависимости.

Поэтому держите функции простыми и сфокусированными.

Одна функция — одна ответственность.

👉 @BackendPortal
Post #3647 912
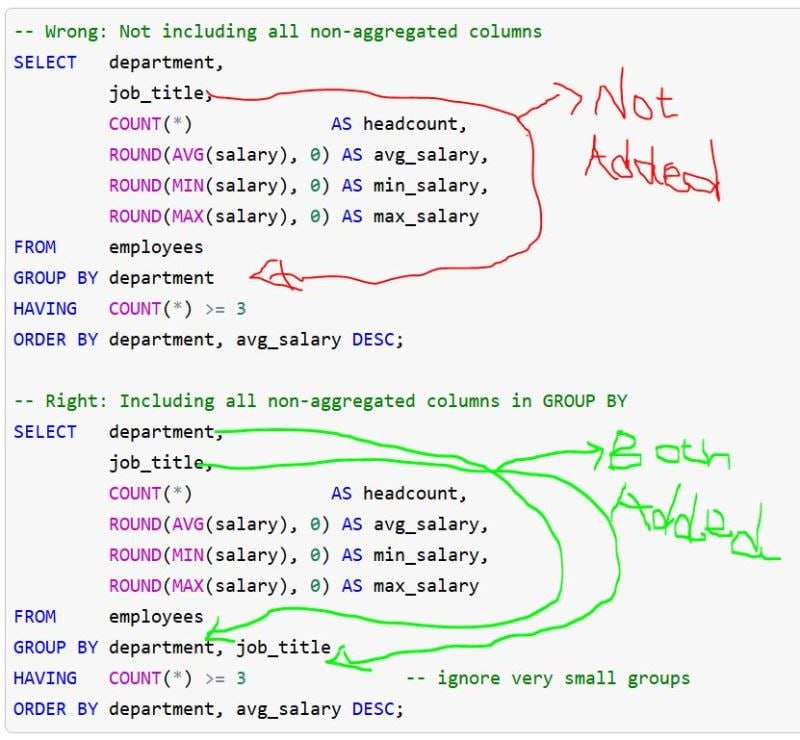
Главное правило SQL GROUP BY, которое должен знать каждый

Если в SELECT используются неагрегированные столбцы, убедитесь, что они добавлены в GROUP BY. Это не просто хорошая практика — в некоторых базах данных это обязательное требование.

Почему это важно?

GROUP BY определяет, что представляет собой одна строка результата. База данных должна точно понимать, какое единственное значение поместить в каждую ячейку этой строки.

В запросе ниже одна строка = одна должность (job_title) внутри конкретного отдела (department). Поэтому и department, и job_title должны присутствовать в GROUP BY.

Если пропустить неагрегированный столбец:

• Некоторые СУБД вернут ошибку
• Другие могут вернуть произвольное значение
• Запрос может «работать» сегодня, но завтра вернуть некорректный результат

Общее правило

Каждый столбец в SELECT должен быть функционально зависим от GROUP BY. Если внутри одной группы столбец может содержать несколько значений, его нужно либо добавить в GROUP BY, либо использовать с агрегатной функцией.

👉 @BackendPortal
Post #3645 834
Backend Checklist — День 13: JSON Serialization

Serialization — это преобразование Python objects в текст для передачи по сети. Звучит как простая смена формата, но на деле это скорее перевод, а при переводе часть информации может потеряться.

В JSON всего семь типов, а у ваших objects их гораздо больше


Весь набор типов JSON — это object, array, string, number, true, false, null. И всё. Никаких datetime, Decimal, set, UUID или bytes. Поэтому более сложные типы приходится преобразовывать, иначе json.dumps() завершится с TypeError:

datetime, UUID, Decimal — соответствующего JSON-типа нет, поэтому их обычно преобразуют в строки
set, bytes — прямого аналога тоже нет, поэтому нужно выбрать представление: например, setlist, а bytes → Base64
tuple — незаметно превращается в array, а после десериализации возвращается уже как list

Последний пример отлично показывает суть проблемы. Вы сериализуете tuple, а десериализуете уже list. Данные сохранились, но тип — нет.

Object, который вы получаете обратно, — не обязательно тот же object, который вы отправили

Round trip через JSON может быть lossy. datetime превращается в строку и останется строкой, пока кто-то явно не преобразует её обратно. Decimal, если привести его к float, чтобы он поместился в JSON, вернётся как float и потенциально потеряет точность.

Serialization — это перевод на язык, в котором всего семь «слов». Всё, для чего в JSON есть собственный тип, сохраняется напрямую. Для всего остального нужны соглашения, понятные обеим сторонам, иначе информация не переживёт передачу.

Например, в Python:
json.loads(json.dumps(("a", "b")))

вернёт:
["a", "b"]


Round trip сохранил значения, но изменил тип данных.

👉 @BackendPortal
Post #3644 910
Удивительно, как часто путают программу, процесс и поток.

Вот простое объяснение.

1. Программа

Это файл на диске, содержащий набор инструкций.

Одна программа может запускать несколько процессов.

Например, Firefox может создавать отдельные процессы для разных компонентов.

2. Процесс

Это программа, которая уже выполняется.

Программа превращается в процесс, когда загружается в память и запускается.

Для работы процесс использует, например, счётчик команд, стек и регистры.

3. Поток

Поток — минимальная единица выполнения внутри процесса.

Один процесс может содержать много потоков.

Например, браузер одновременно выполняет несколько потоков. Один может загружать содержимое, другие — отрисовывать анимации, воспроизводить видео и выполнять другие задачи.

Главные различия между процессами и потоками:

• процессы независимы, а потоки существуют внутри процесса
• у каждого процесса своё адресное пространство памяти, а потоки одного процесса делят общую память
• переключение между процессами обычно дороже
• обмен данными между потоками быстрее, чем между процессами
• создание и завершение потока обычно легче и быстрее

👉 @BackendPortal
Post #3642 904
БОЛЬШОЙ SQL-ГРЕХ

Использовать операторы NOT IN или IN, когда в данных присутствует NULL.

В SQL оператор IN — это сокращённая запись нескольких условий OR, а сравнение value = NULL всегда возвращает UNKNOWN. Из-за этого запрос может вернуть неожиданный результат или вообще пустую выборку.

Если нужно учитывать NULL, обрабатывайте его явно. Добавьте условие IS NULL к IN или используйте другой подход, корректно учитывающий NULL.

Всегда тестируйте SQL-запросы с NULL, чтобы убедиться, что они работают так, как ожидается.

👉 @BackendPortal
Post #3640 922
Бесплатный гайд по GitHub новичкам

Освоить GitHub - один из первых шагов в карьере разработчика. В официальном руководстве собраны ключевые темы: от создания репозитория до командной работы через Pull Request.

Хороший старт для студентов, джунов и всех, кто хочет программировать.

👉 @BackendPortal
Older posts →

About this channel

How can I read @backendportal without a Telegram account?
TGViewer shows the public web preview Telegram publishes for Backend Portal | Программирование: recent posts, photos, videos and the subscriber count, with no app, login or account.
How many subscribers does Backend Portal | Программирование have?
Backend Portal | Программирование (@backendportal) has 16.1K subscribers on Telegram, refreshed roughly every 30 minutes.
Does Backend Portal | Программирование know I viewed it here?
No. Public channel previews carry no viewer identity, and TGViewer has no accounts or tracking of what you look up.
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →